Bewusst kein Preis-Leistungs-Scatter und keine Trend-Sparklines: Für vergleichbare Preise, Messkonfigurationen und Zeitreihen liegt hier noch kein geprüfter Datensatz vor.
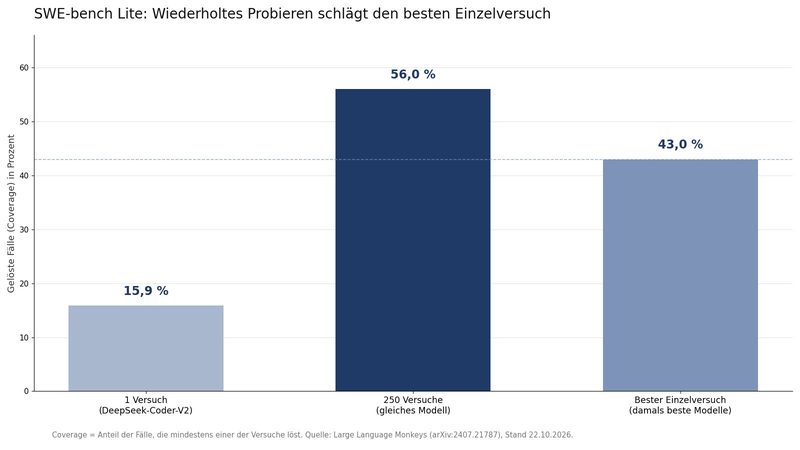
Erst Chain-of-Thought, dann Verstärkungslernen, jetzt Budget Forcing: Warum Modelle mit mehr Denkzeit besser werden - und was die Forschung dazu belegt.
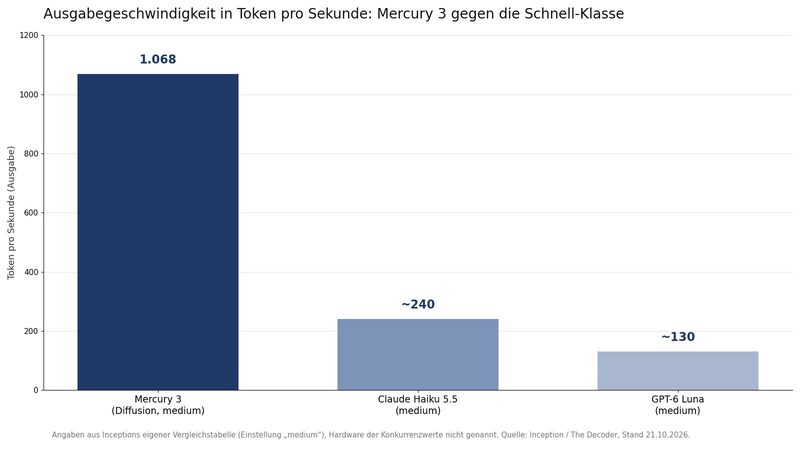
1.068 Token pro Sekunde, acht von zwölf Benchmarks gewonnen: Inception behauptet die Flucht nach vorn. Was die Technik kann, was die Tabelle wirklich zeigt.
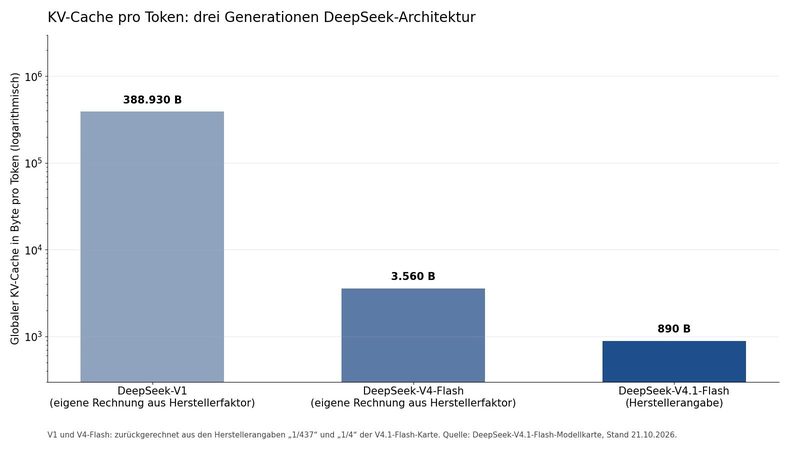
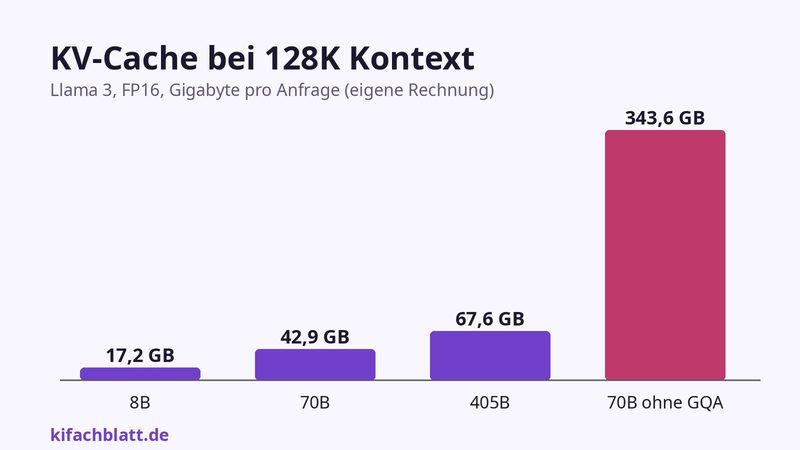
Eine Million Token Kontext klingt gratis, ist es aber nicht: Der KV-Cache frisst Speicher und Geld. Wie DeepSeek, Mistral und vLLM ihn drücken, mit Zahlen.
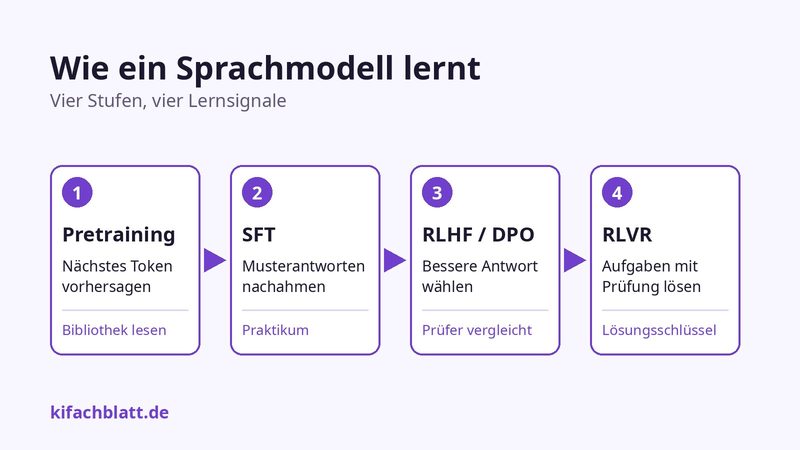
Pretraining, SFT, RLHF, DPO und RLVR einfach erklärt: Was jede Stufe leistet, warum Modelle so verschieden wirken und was die Begriffe in Modellkarten bedeuten.
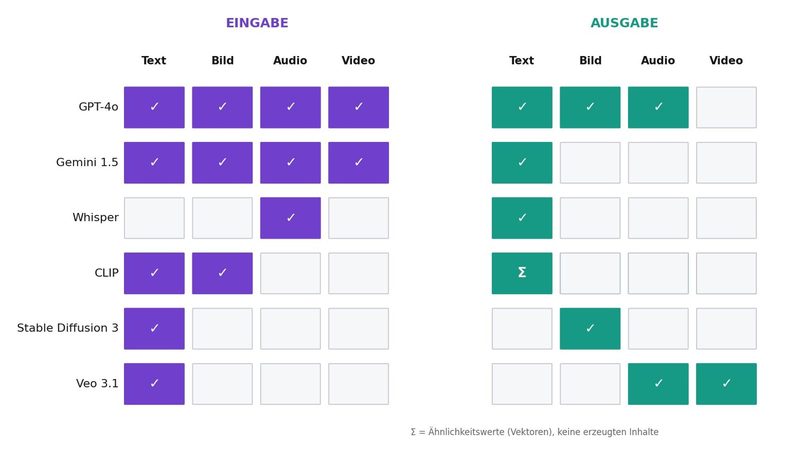
Multimodal klingt nach eierlegender Wollmilchsau. Die Matrix zeigt, welche Modelle Text, Bild, Audio und Video tatsächlich einlesen, und was sie ausgeben.
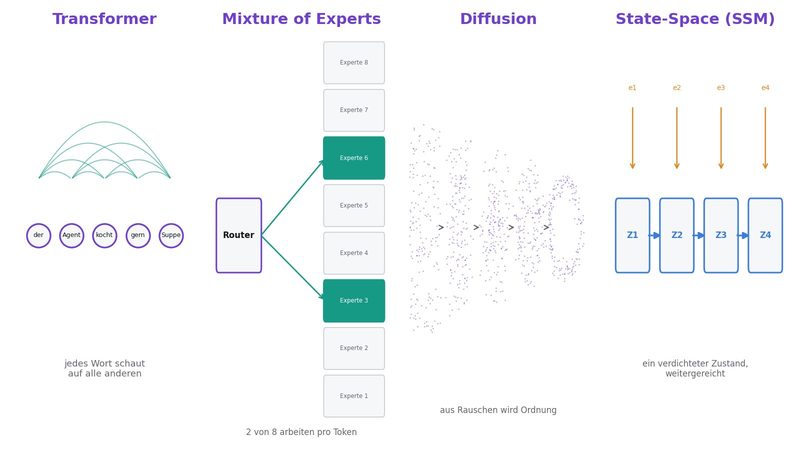
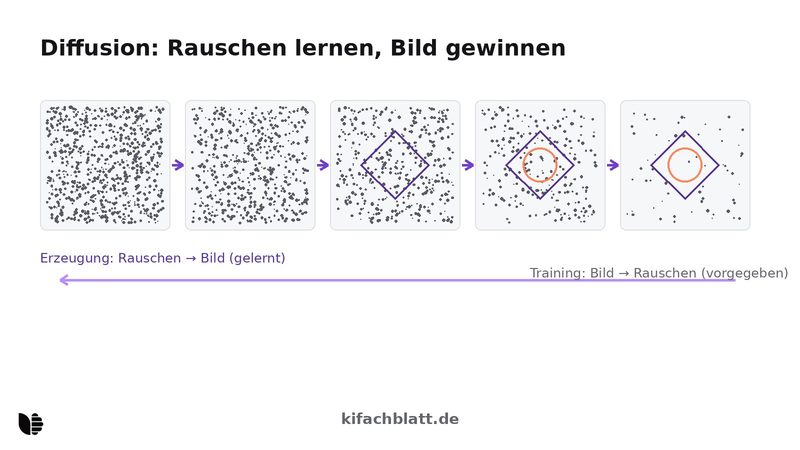
Vier Architekturfamilien entscheiden, was KI-Modelle können und kosten und wo sie scheitern: Transformer, Mixture of Experts, Diffusion, State-Space-Modelle.
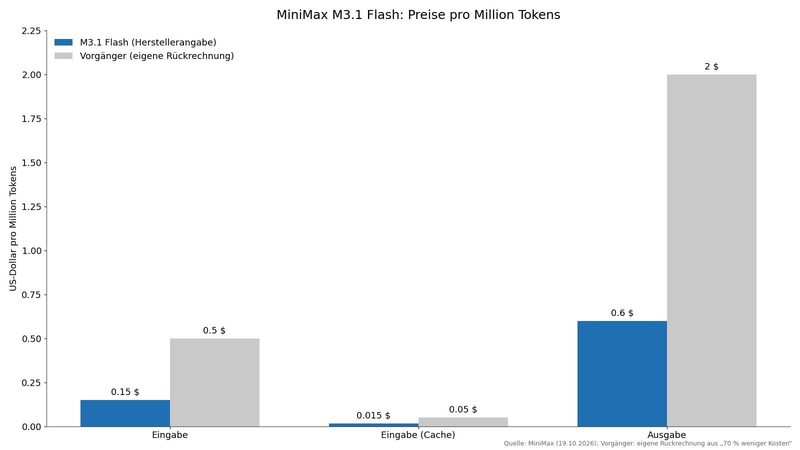
MiniMax verspricht fast dreifache Inferenzgeschwindigkeit und 70 Prozent weniger Kosten. Wir ordnen Benchmarks, Preise und das Space-Bunny-Vorspiel ein.
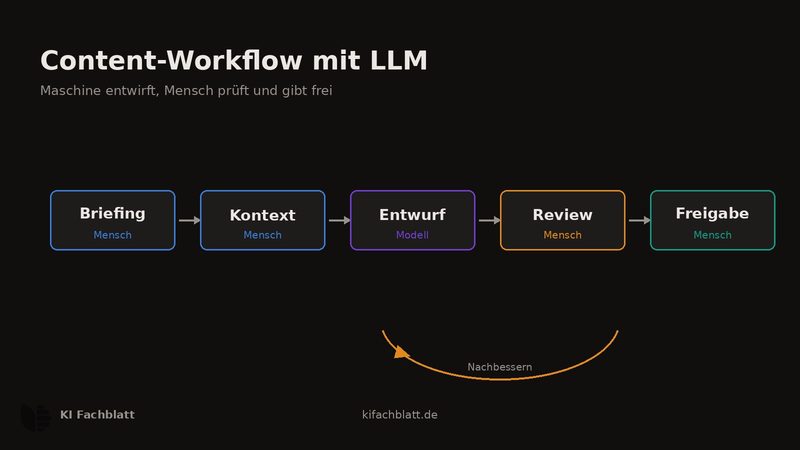
Sprachmodelle schreiben im Durchschnittston ihrer Trainingsdaten. Wie Marken ihre Stimme messbar machen, in Werkzeugen hinterlegen und mit Review sichern.
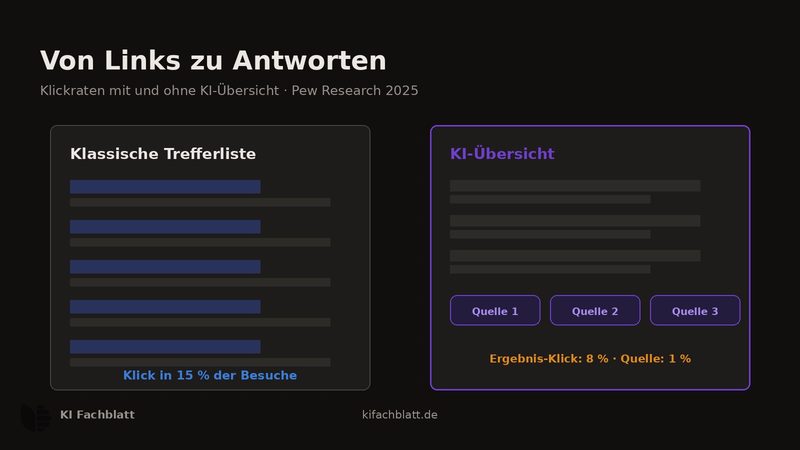
AI Overviews, Chatbots und Antwortmaschinen verändern, wie Inhalte gefunden werden. Was gemessen ist, was Google selbst rät und was hinter llms.txt steckt.
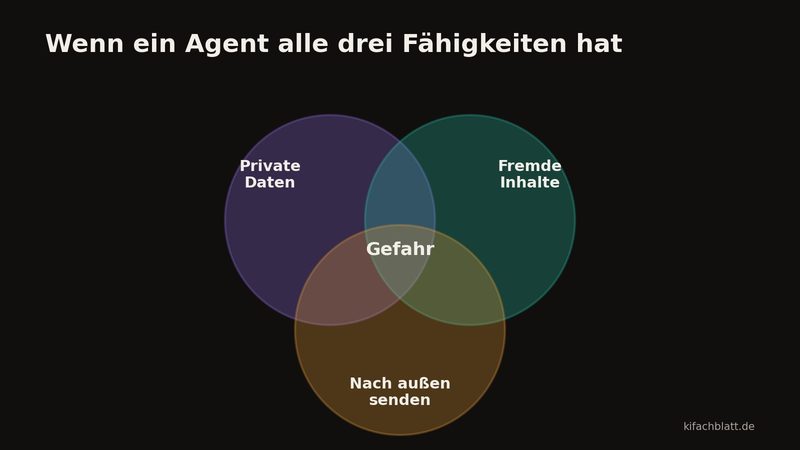
OWASP Top 10 für LLM-Anwendungen, Zugriff mit kleinsten Rechten, saubere Datenflüsse, geprüfte Modelle aus der Lieferkette und ein Patch-Rhythmus, der hält.
Kein Filter und kein System-Prompt stoppt jeden Angriff auf ein LLM-System. Was wirklich trägt: Verteidigung in Schichten, von der Eingabe bis zu den Rechten.
Welche Metriken ein LLM-Dienst wirklich braucht: TTFT und Warteschlange aus dem Server, Rate-Limits lesen, Token-Budgets einziehen und Alarme, die nicht nerven.
Prompt Injection, Jailbreaks, vergiftete Daten, kopierte Modelle: die wichtigsten Angriffsmuster auf LLM-Systeme, eingeordnet anhand der OWASP Top 10 von 2025.
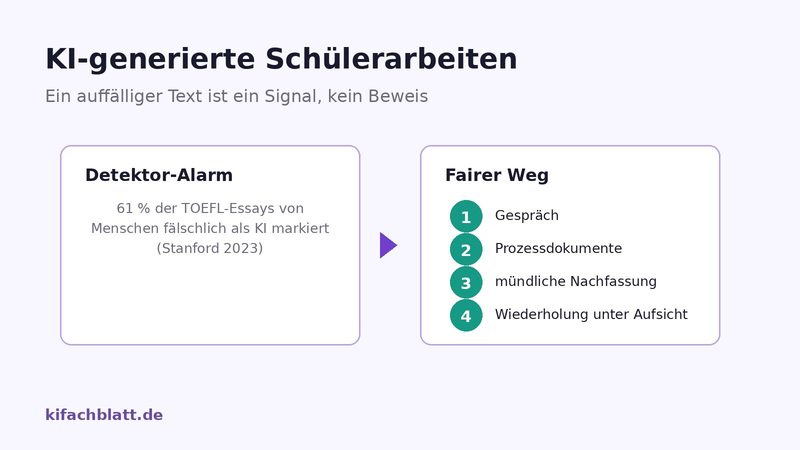
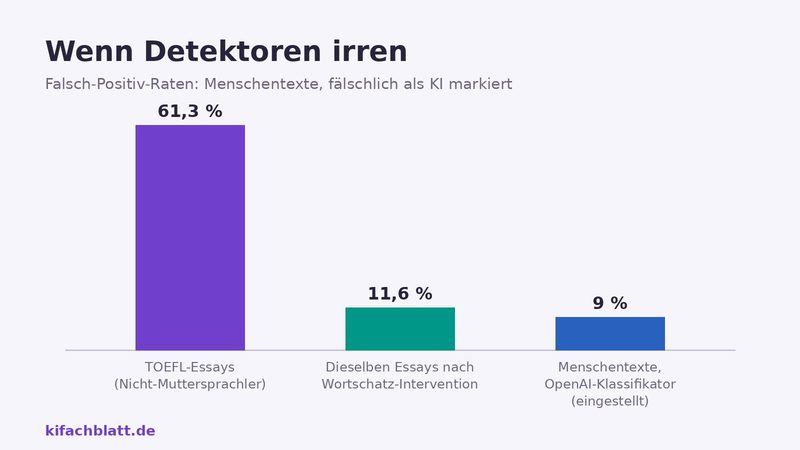
Warum KI-Detektoren in Studien so stark irren, wie Lehrkräfte Verdachtsfällen fair begegnen und welche Aufgabenformate das Problem an der Wurzel verkleinern.
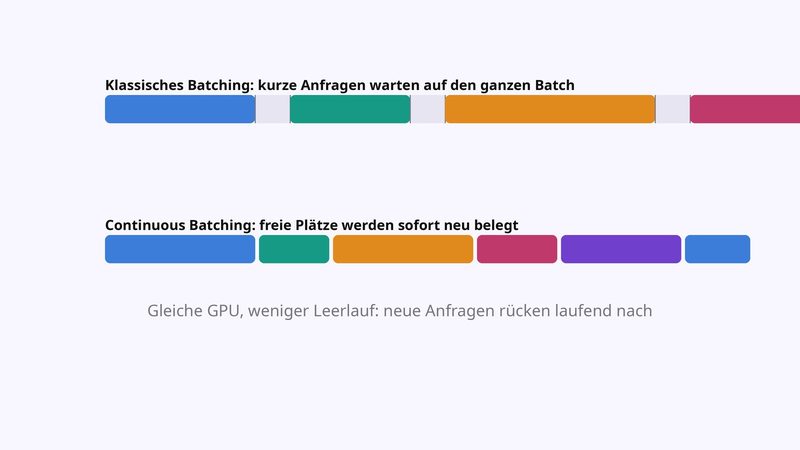
Continuous Batching, PagedAttention und die Kennzahlen TTFT und TPOT: Wie ein Inferenz-Server viele Anfragen zugleich beantwortet und wo die Grenzen liegen.
Der Hugging Face Hub ist der zentrale Marktplatz für offene KI-Modelle. Wie du Modellkarten, Kennzahlen und Leaderboards richtig liest und Blindgänger erkennst.
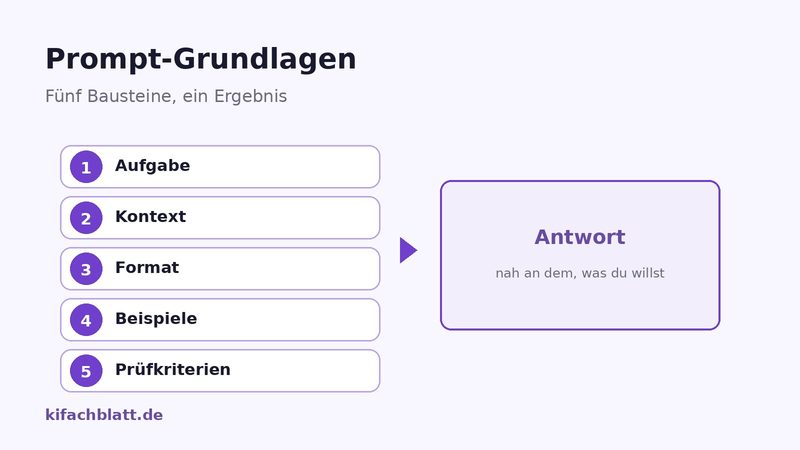
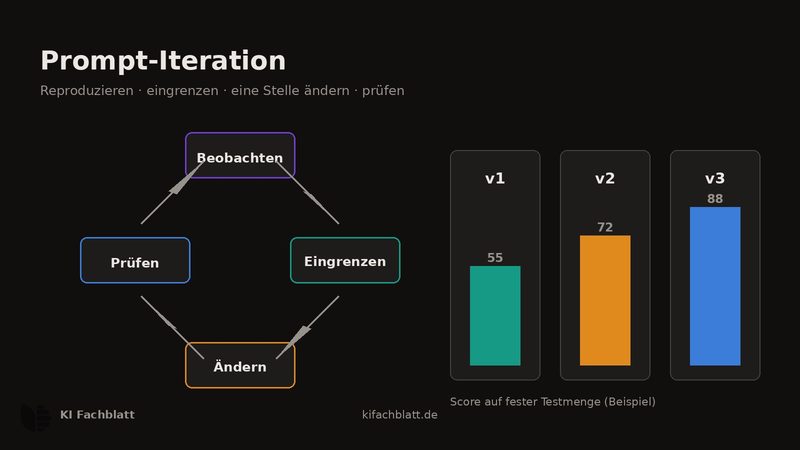
Was ein Prompt ist, aus welchen Bausteinen gute Anweisungen bestehen, was Few-Shot bedeutet und warum Iteration wichtiger ist als der perfekte erste Satz.
Herunterladbar heißt nicht frei nutzbar: Warum offene Gewichte und Open Source zwei verschiedene Dinge sind, welche Lizenzfallen lauern und wie du sie prüfst.
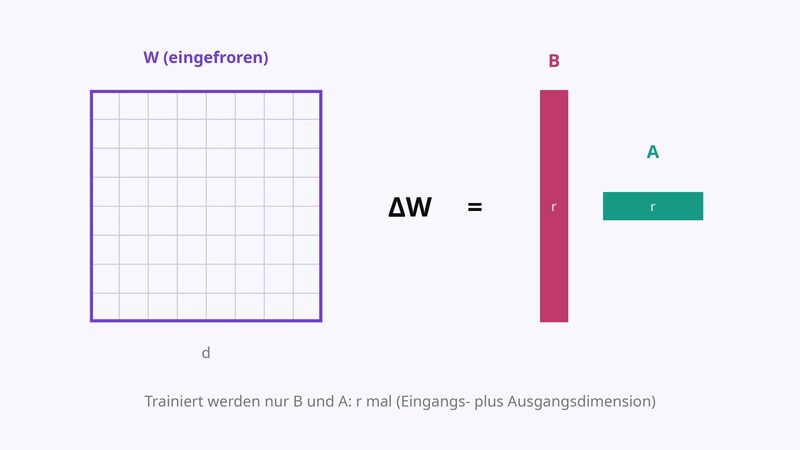
Wie LoRA ein Milliarden-Modell mit Millionen Zusatzparametern umbaut: die Mathematik dahinter, eine eigene Parameter-Rechnung und der Trainingslauf mit PEFT.
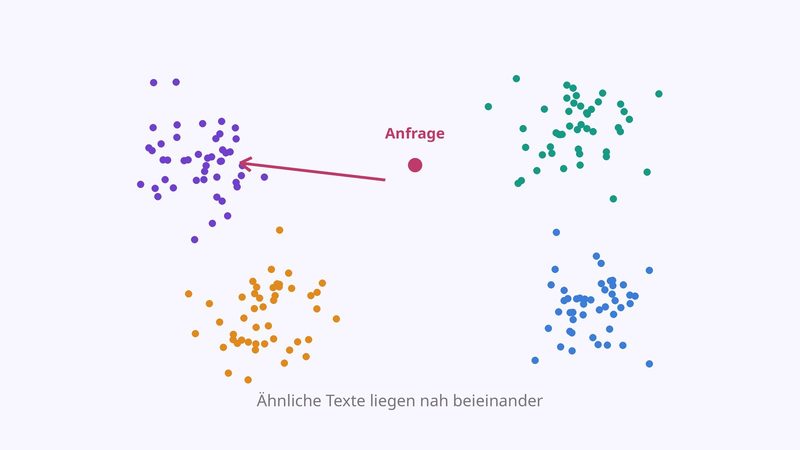
Wie aus Wörtern und Sätzen Zahlenreihen werden, was Kosinus-Ähnlichkeit misst, wie HNSW und FAISS Millionen von Vektoren durchsuchen und was MTEB verrät.
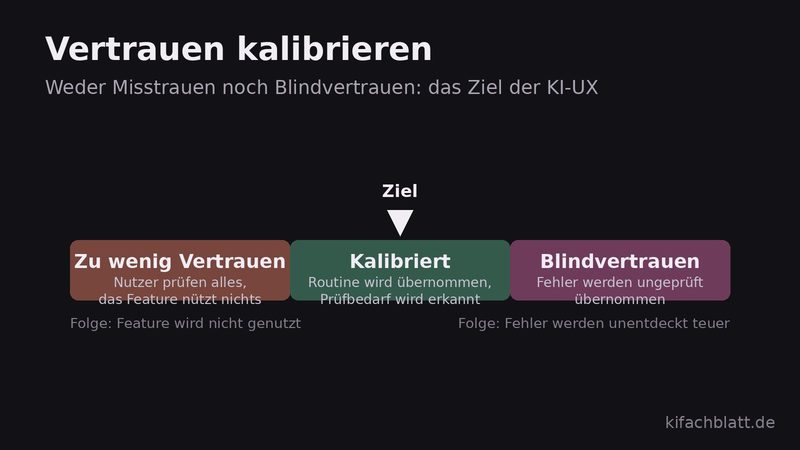
Wie Sie KI-Features so gestalten, dass Nutzer ihnen richtig vertrauen: Unsicherheit zeigen, Fehler prüfbar machen, Fallbacks bauen und Erwartungen steuern.
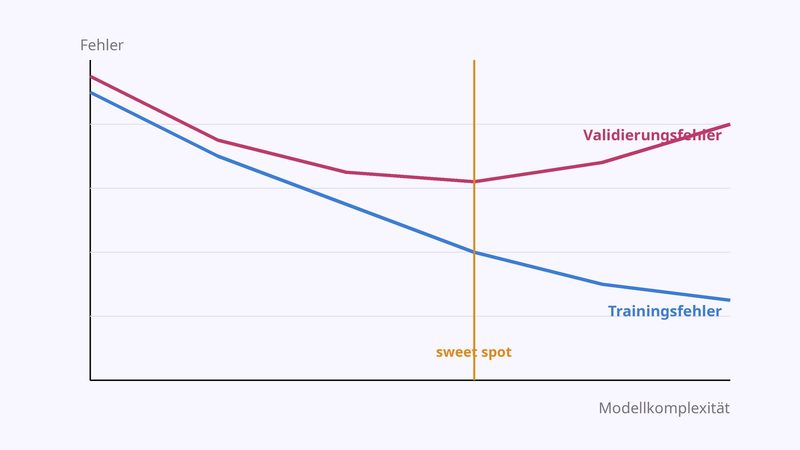
Trainings-, Validierungs- und Testdaten, warum Modelle auswendig lernen statt zu verstehen und wie Kreuzvalidierung die Leistung auf neuen Fällen schätzt.
Ob ein Text von einer KI stammt, kann heute kein Werkzeug zuverlässig sagen. Was Wasserzeichen wie SynthID leisten und warum Detektoren Unschuldige treffen.
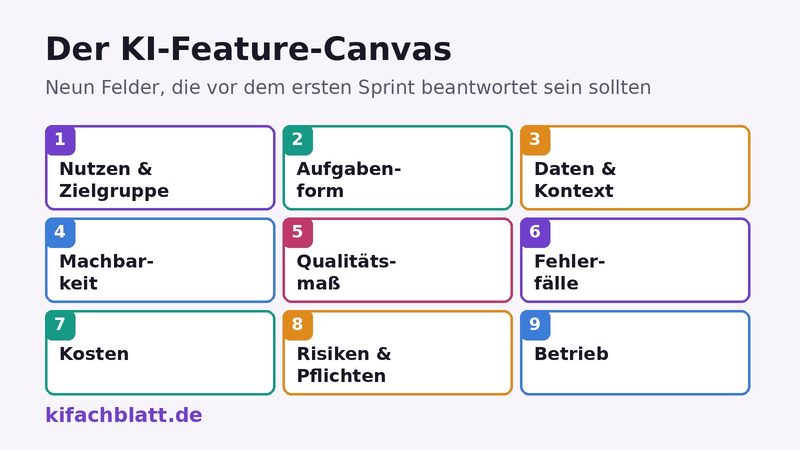
Neun Felder, mit denen Sie ein KI-Feature vor dem ersten Sprint prüfen: Nutzen, Daten, Machbarkeit, Qualitätsmaß, Kosten und der Plan für den Fehlerfall.
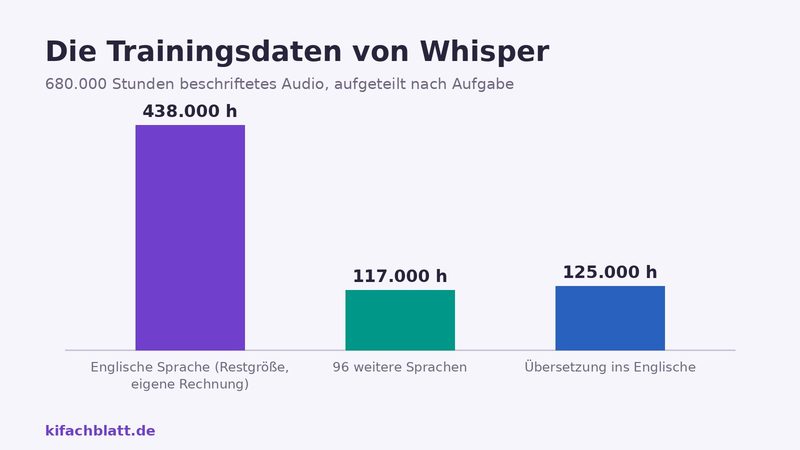
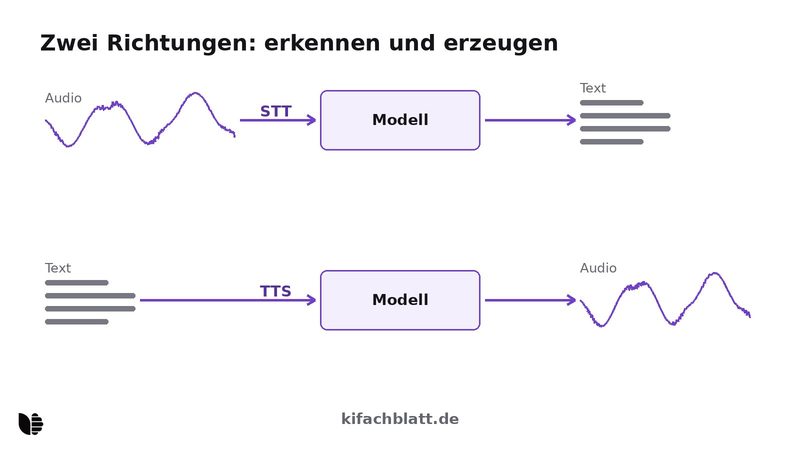
KI transkribiert Interviews in Minuten, fast auf Profi-Niveau. Was Whisper und Co. leisten, wo sie Fehler machen und wie ein sauberer Workflow aussieht.
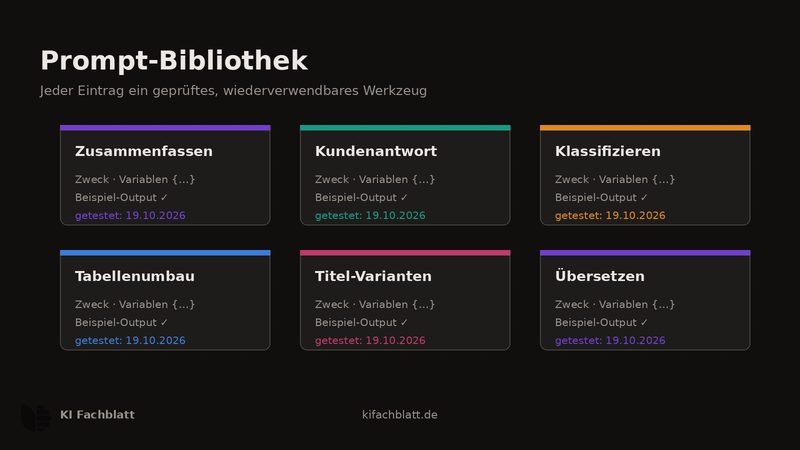
Gute Prompts sind wiederverwendbares Werkzeug. Wie man sie sammelt, versioniert und pflegt, damit aus einmaligem Ausprobieren ein wachsender Bestand wird.
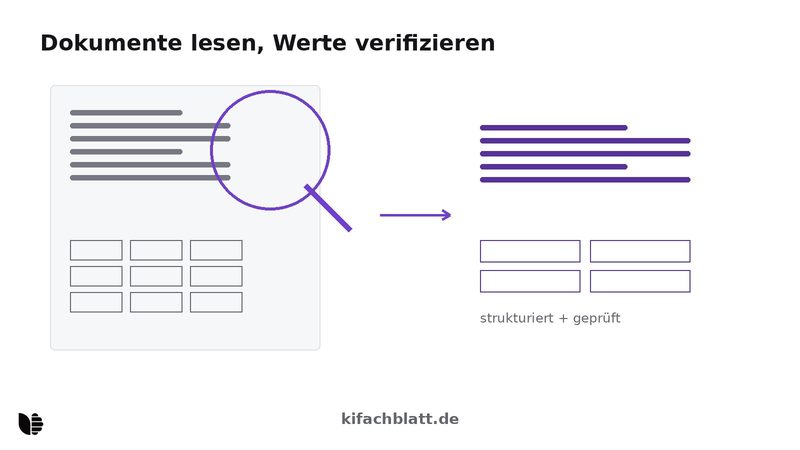
Modelle lesen Bilder: Was Bildverständnis bei Dokumenten, Screenshots und Diagrammen leistet, wo es Fehler macht und wie du Ergebnisse zuverlässig absicherst.
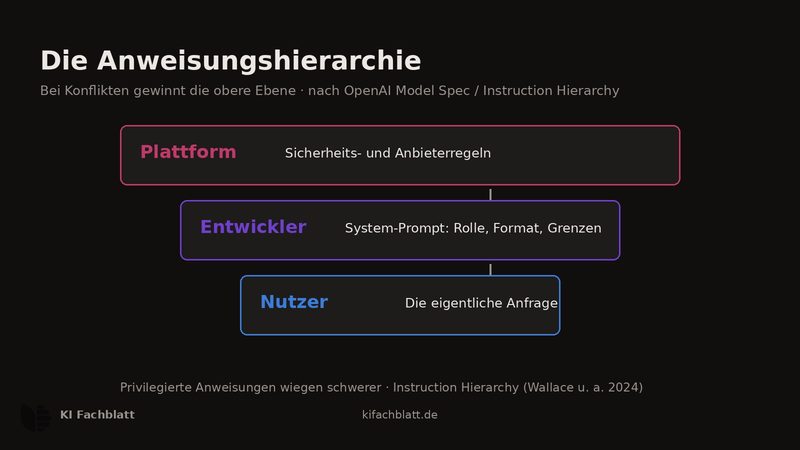
Was ein System-Prompt ist, wie die Anweisungshierarchie von OpenAI und Anthropic funktioniert, was in den System-Prompt gehört und was dort nichts verloren hat.
Zwei von drei Bewerbungen entstehen mit KI-Hilfe. Was das für die Auswahl bedeutet, warum Detektoren keine Lösung sind und wie Personaler Prozesse umbauen.
KI sortiert Lebensläufe schneller als jedes Team – und diskriminiert nachweisbar. Was die Werkzeuge können, warum sie Hochrisiko-KI sind, was du beachten musst.
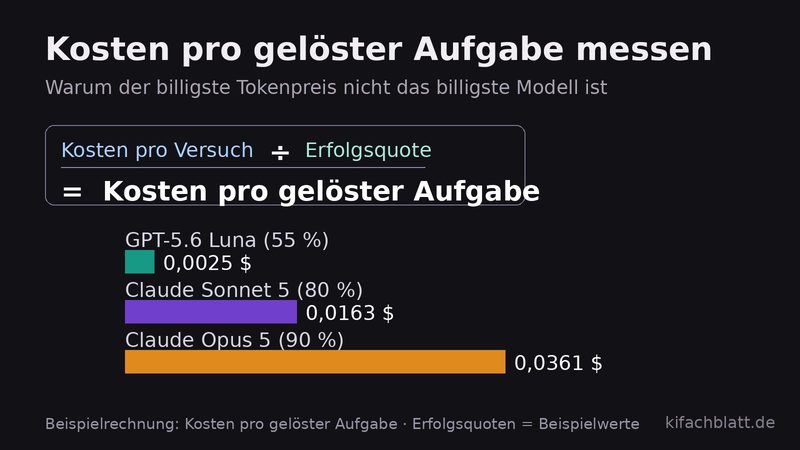
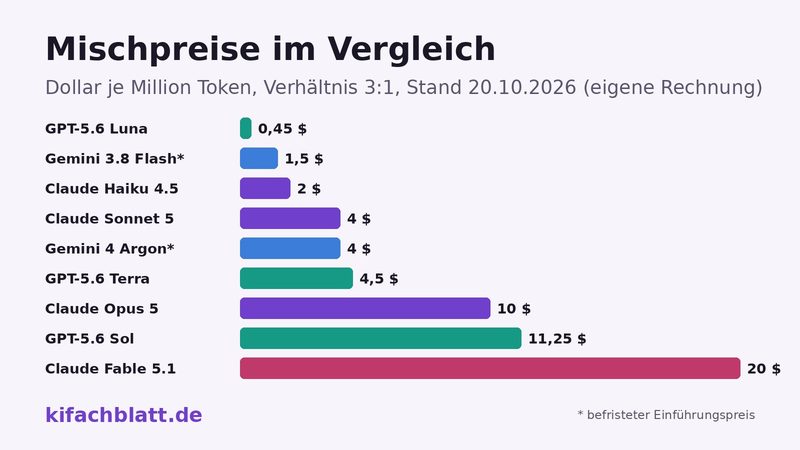
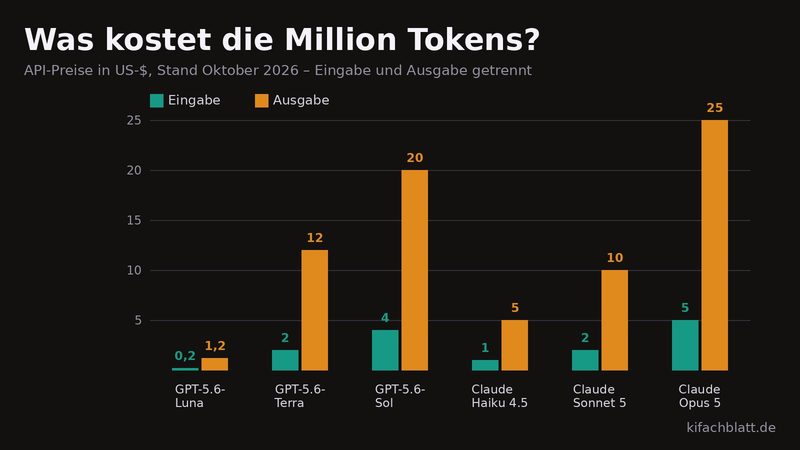
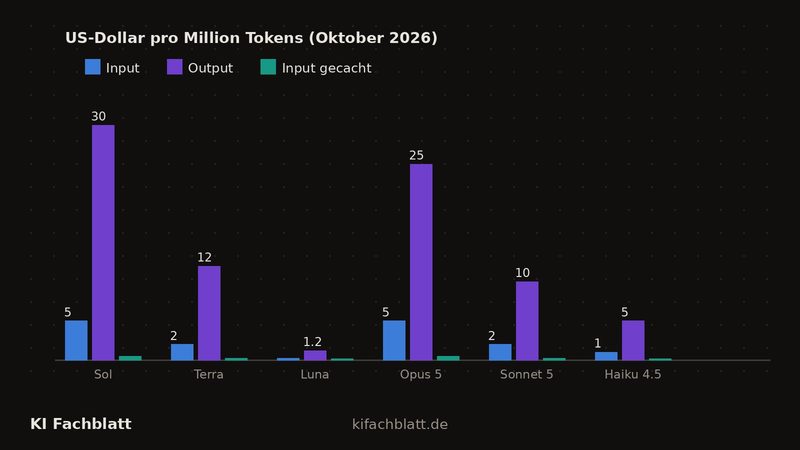
Was kostet eine gelöste Aufgabe wirklich? Von Token-Preisen über versteckte Posten zur KI-Kostenrechnung – mit aktuellen Preisen und eigener Beispielrechnung.
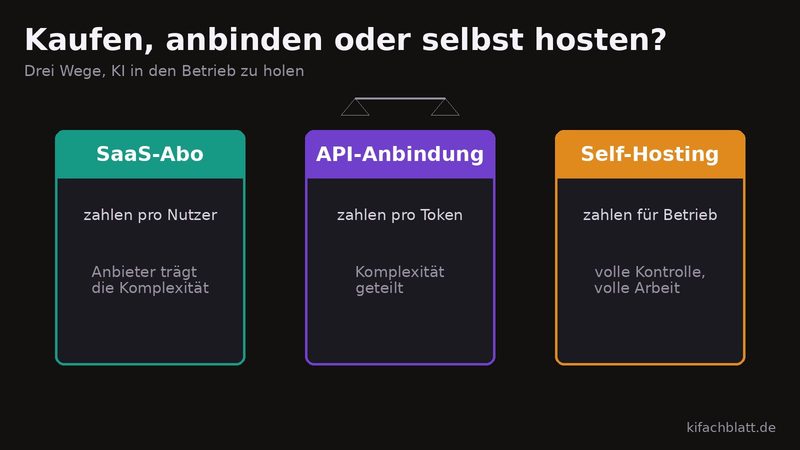
Fertigabo, API-Anbindung oder eigener Server? Die drei Beschaffungswege für KI: Was sie kosten, wo die versteckten Posten stecken, wann sich was rechnet.
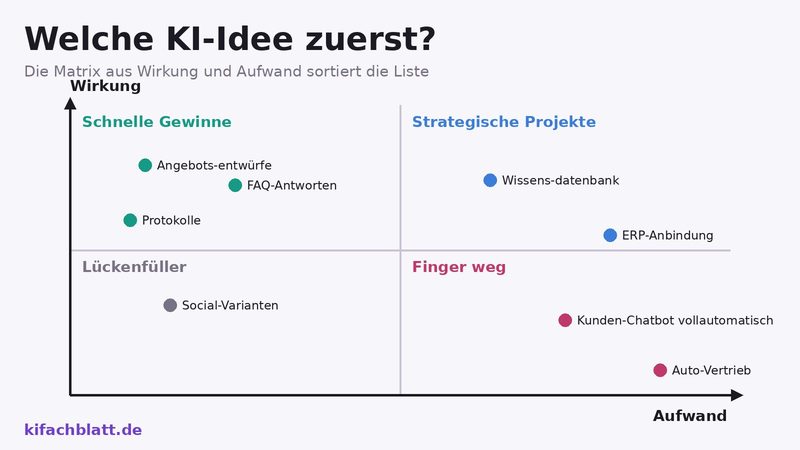
Vom Bauchgefühl zur Liste: KI-Anwendungsfälle im Betrieb finden, nach Wirkung und Aufwand sortieren und mit einem Piloten starten, der misst statt verspricht.
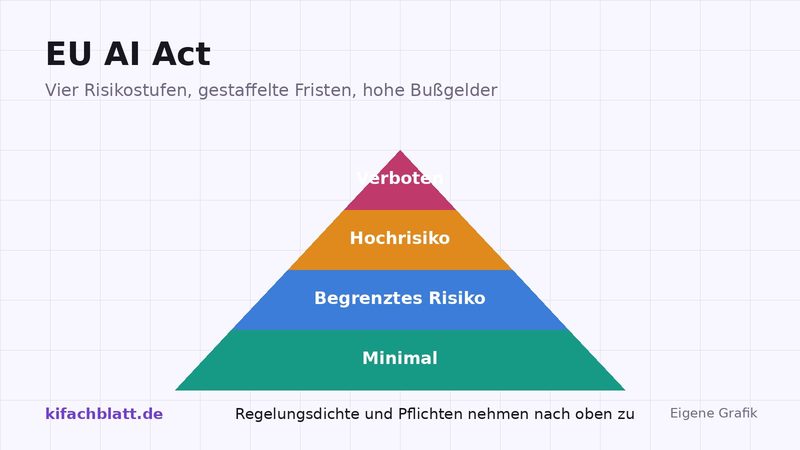
Die KI-Verordnung gilt gestaffelt, der Omnibus hat Hochrisiko-Fristen verschoben. Was seit 2026 gilt, was 2027 kommt und wer in Deutschland kontrolliert.
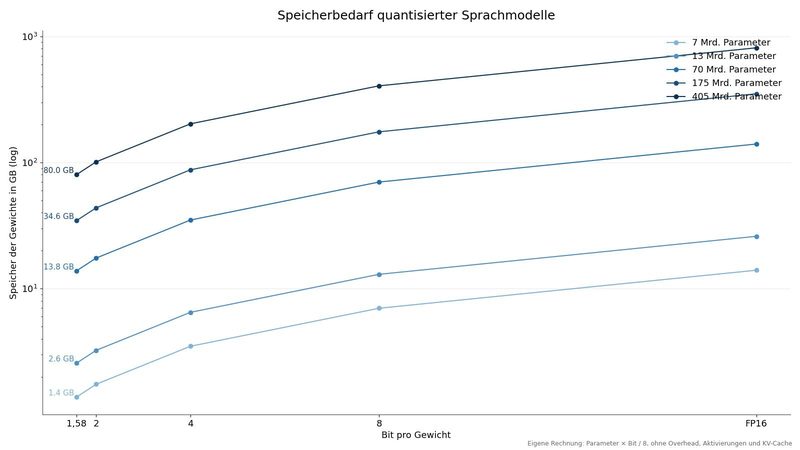
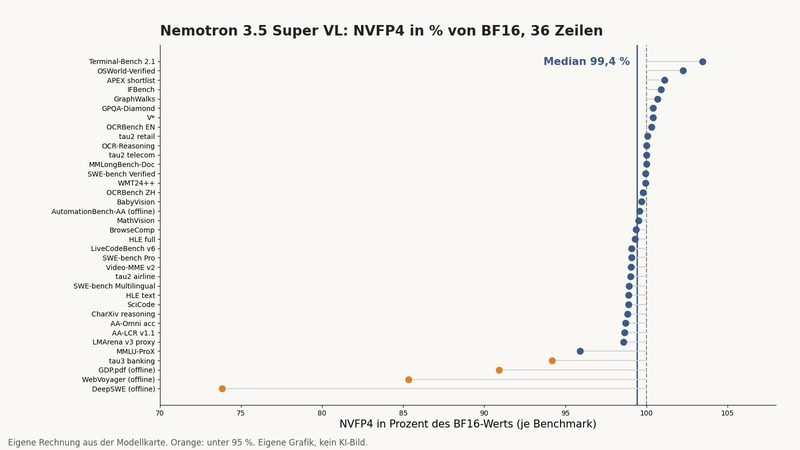
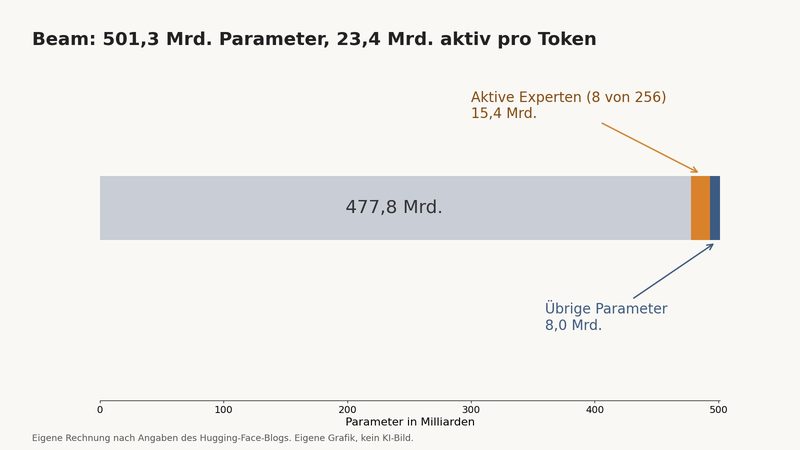
Metas 816-Milliarden-Modell im Check: Architektur, Speicherbedarf, Lizenzbedingungen und eine Benchmark-Bilanz, die eher gemischt ausfällt als überlegen.
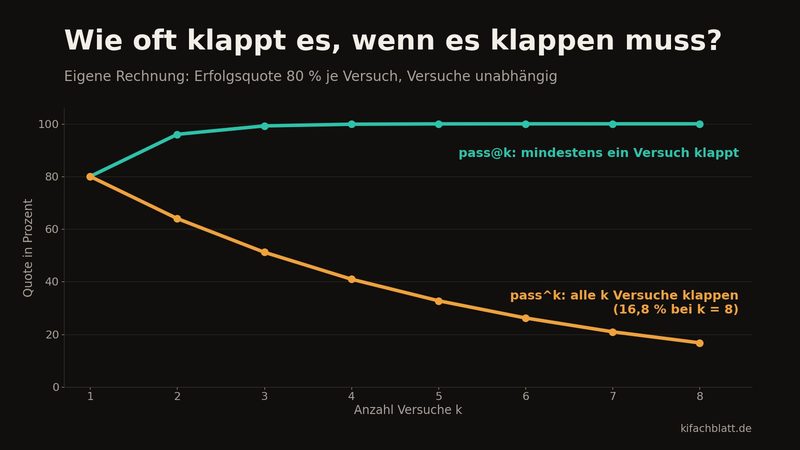
Ein Preprint testet 15 KI-Modelle drei Stunden lang auf 77 Terminalaufgaben. Was Methode, Zahlen und Kosten belegen und wo die Grenzen der Studie liegen.
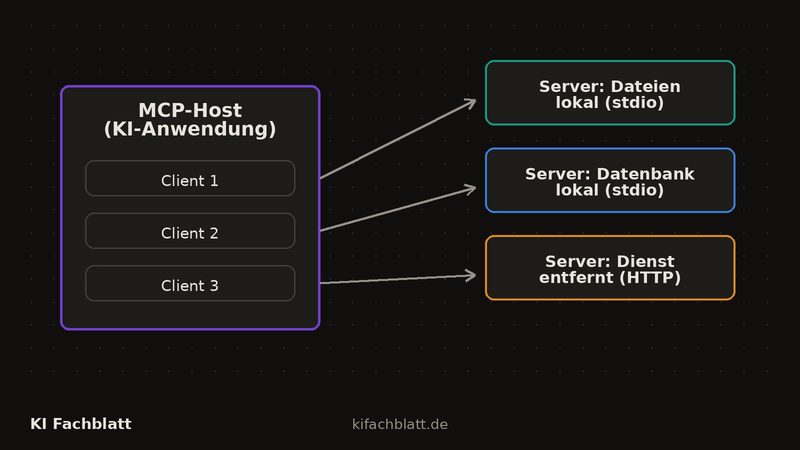
Das Model Context Protocol erklärt: Host, Client und Server, die drei Server-Primitive Tools, Resources und Prompts, Transportwege und Sicherheitsfragen.
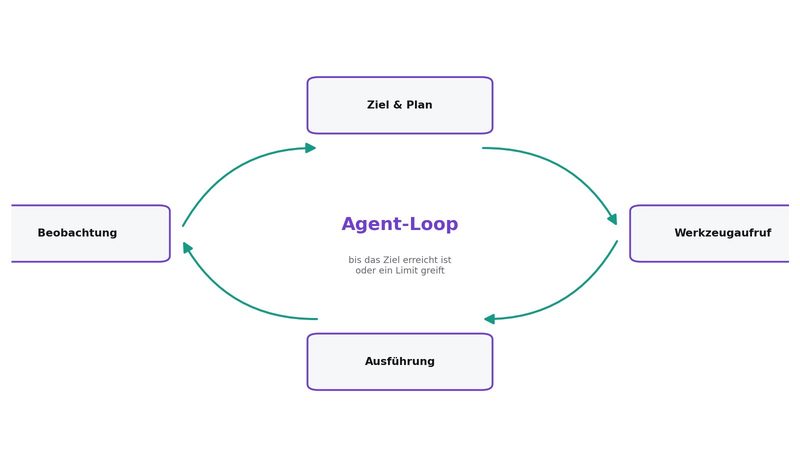
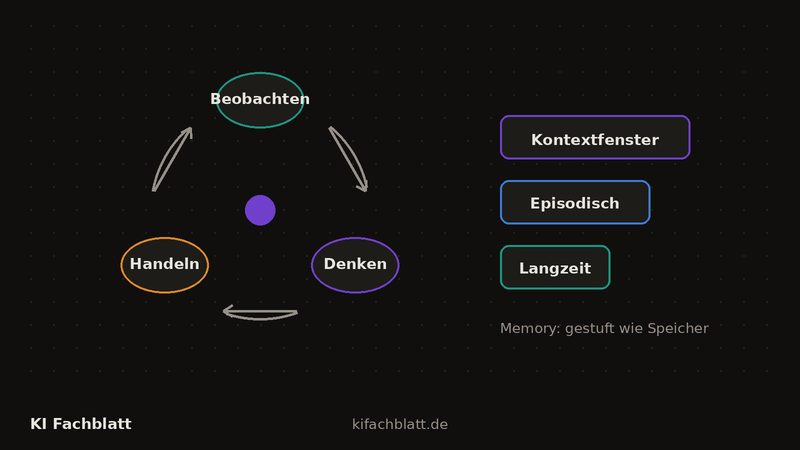
Aus welchen Bausteinen ein KI-Agent entsteht: der Agent-Loop, Planung von ReAct bis Tree of Thoughts, Memory jenseits des Kontextfensters und Orchestrierung.
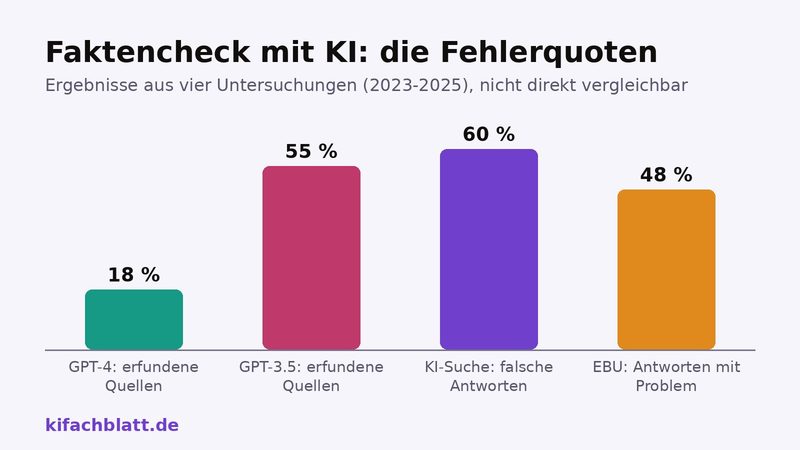
KI-Assistenten erfinden Quellen und nennen falsche Fakten mit voller Überzeugung. Was Studien über Fehlerquoten zeigen und wie ein Prüf-Workflow aussieht.
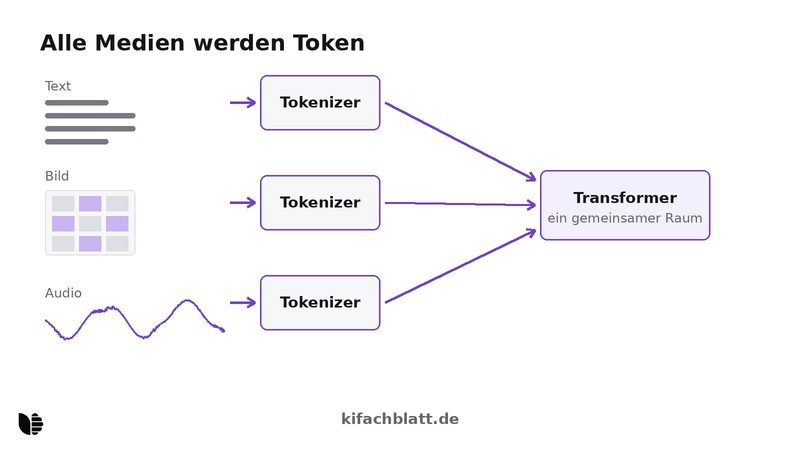
Ein Modell, viele Sinne: Wie Text, Bild, Audio und Video als Tokens im selben Modell landen, welche Architekturen das tragen und was das für die Wahl heißt.
Die drei großen Hebel für günstigere und schnellere LLM-Anwendungen: Prompt-Caching, Batch API und die richtige Modellgröße, mit Zahlen und eigener Rechnung.
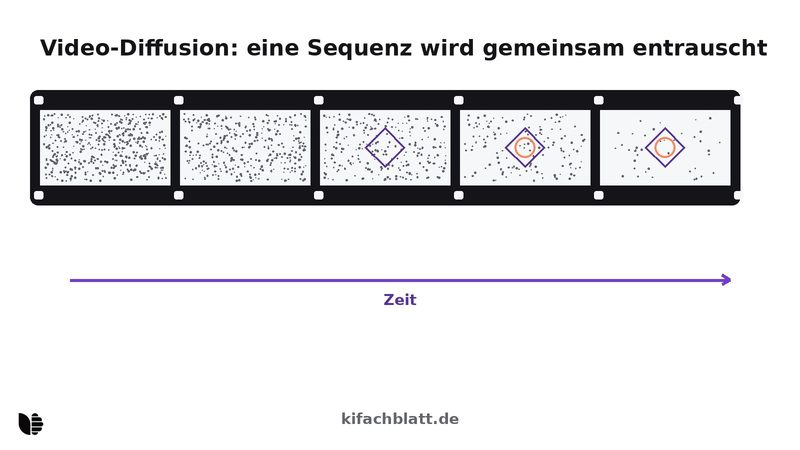
Videomodelle nach dem Sora-Aus: Was Veo 3.1, Runway Gen-4.5 und Kling 3.0 können, wie Video-Diffusion funktioniert und woran die Clips bis heute scheitern.
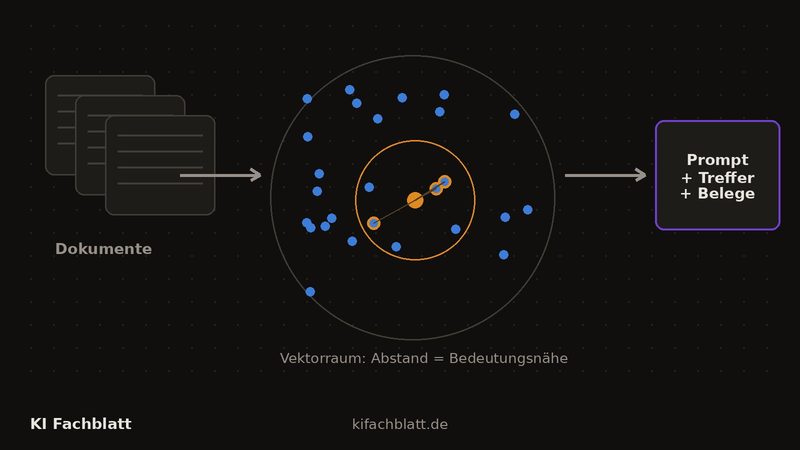
Ein eigenes Retrieval-System von null: Text zerlegen, Embeddings erzeugen, Vektoren indexieren, Treffer in den Prompt legen und mit Quellenangabe antworten.
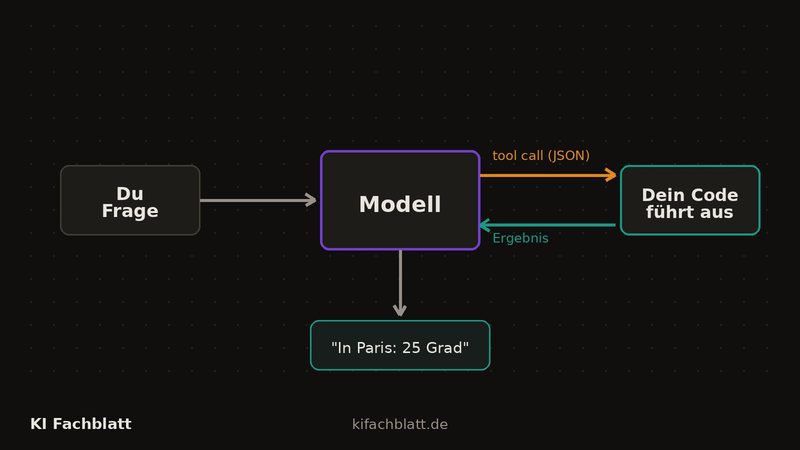
Wie ein Sprachmodell deine Funktionen aufruft: Werkzeugdefinition per JSON Schema, die fünf Schritte der Aufruf-Schleife, Client- und Server-Tools, Fehler.
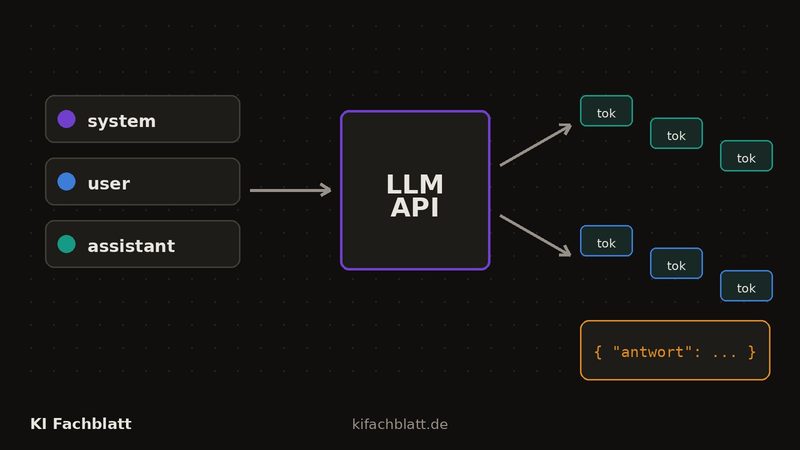
Wie ein API-Aufruf an ein Sprachmodell aufgebaut ist, welche Parameter das Verhalten steuern, wie Streaming funktioniert und wann Structured Output Pflicht ist.
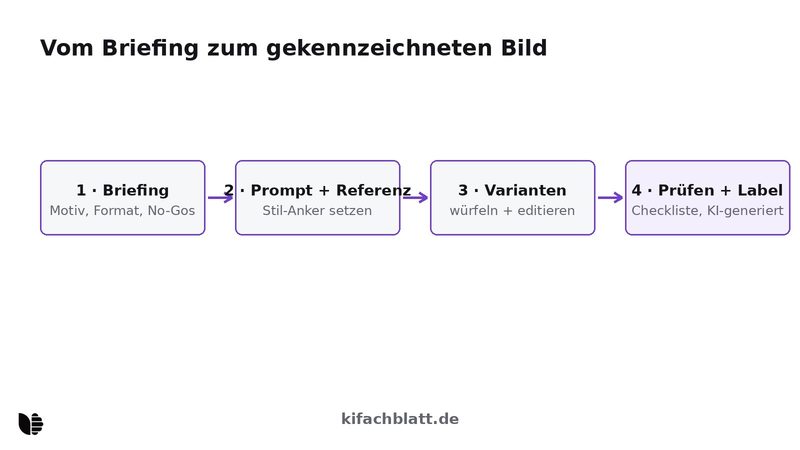
Vom Rauschen zum Bild: Wie Diffusionsmodelle Text in Bilder übersetzen, was ein Bild-Tokenizer tut und warum die Modelle Stile können, aber nichts verstehen.
 KI