 KI
Nach den ersten Wochen mit einer LLM-Anwendung kommen zwei Fragen garantiert: Warum ist das so teuer, und warum ist das so langsam? Beide haben dieselbe Wurzel: Tokens. Jede Anfrage bezahlt und wartet auf Input- und Output-Tokens, also dreht sich fast jede Optimierung um drei Hebel: weniger neu bezahlen (Caching), weniger sofort bezahlen (Batching) und weniger pro Token bezahlen (Modellwahl). Dieser Artikel geht die Hebel mit den aktuellen Preislisten durch und rechnet sie an einem Beispiel durch. Grundlagen liefert Inferenz und Kosten verstehen; wie du Anbieterpreise systematisch vergleichst, zeigt API-Preise vergleichen.
Hebel 1: Prompt-Caching
Prompt-Caching speichert den Anfang deiner Anfrage (das Präfix) und rechnet bei Wiederholung ab dem gespeicherten Zustand weiter, statt alles neu zu verarbeiten. Bei OpenAI ist das automatisch aktiv, sobald die Anfrage mindestens 1.024 Tokens umfasst: Das System prüft, ob der Anfang schon auf dem Rechner liegt (Cache Hit) oder neu verarbeitet werden muss (Cache Miss). [1] Anthropic bietet dieselbe Technik in zwei Formen: automatisch über ein einziges cache_control-Feld, das den Cache-Punkt mitwachsen lässt, oder über explizite Haltepunkte auf einzelnen Inhaltsblöcken; der Cache lebt standardmäßig fünf Minuten und verlängert sich kostenlos bei jedem Treffer, optional gibt es eine Stunde. [2]
Die Preislogik ist bei beiden Anbietern ähnlich und dreiteilig: Schreiben in den Cache kostet einen Aufschlag (bei Anthropic das 1,25-Fache des Input-Preises für fünf Minuten, das Doppelte für eine Stunde; bei OpenAI seit der GPT-5.6-Familie ebenfalls das 1,25-Fache, davor nichts), Lesen aus dem Cache kostet etwa ein Zehntel des Input-Preises, und die Ersparnis zeigt sich im Nutzungsfeld cached_tokens beziehungsweise cache_read_input_tokens. [1][2] Bei OpenAI beträgt die Mindestlebensdauer eines geschriebenen Präfixes in der GPT-5.6-Familie 30 Minuten (prompt_cache_options.ttl); ältere Modelle kennen stattdessen Aufbewahrungsrichtlinien wie in_memory mit typisch 5 bis 10 Minuten Inaktivität. [1]
Hebel 2: Batch API für alles ohne Eile
Die Batch API von OpenAI nimmt Anfragen als Datei entgegen (eine Zeile JSON pro Request), arbeitet sie asynchron ab und liefert Ergebnisse mit einem 24-Stunden-Ziel, in der Praxis oft schneller. Der Preis dafür: 50 Prozent Rabatt auf Input und Output, dazu ein separater, deutlich größerer Rate-Limit-Topf. Die Dokumentation nennt als typische Fälle Evaluationen, das Klassifizieren großer Datensätze und das Einbetten ganzer Repositories; unterstützt werden unter anderem Responses, Chat Completions, Embeddings und Bild-Endpunkte. [3]
Die Leitfrage ist ehrlich: Muss die Antwort jetzt da sein? Alles, was nachts laufen kann (Reporte, Tagging, Migrationen, Testmengen-Auswertung), gehört in den Batch. Alles, worauf ein Mensch wartet, nicht. Anthropic bietet ein entsprechendes Angebot (Message Batches), und die Multiplikatoren für Cache und Batch addieren sich beziehungsweise stapeln sich mit anderen Preisreglern. [2]
Hebel 3: Modellwahl
- Input
- Output
- Input (gecacht)
Daten als Tabelle
| Input | Output | Input (gecacht) | |
|---|---|---|---|
| GPT-5.6 Sol | 5 $ | 30 $ | 0,5 $ |
| GPT-5.6 Terra | 2 $ | 12 $ | 0,2 $ |
| GPT-5.6 Luna | 0,2 $ | 1,2 $ | 0,02 $ |
| Claude Opus 5 | 5 $ | 25 $ | 0,5 $ |
| Claude Sonnet 5 | 2 $ | 10 $ | 0,2 $ |
| Claude Haiku 4.5 | 1 $ | 5 $ | 0,1 $ |
Quelle: OpenAI API Pricing; Anthropic Prompt-Caching-Preistabelle [2][4]
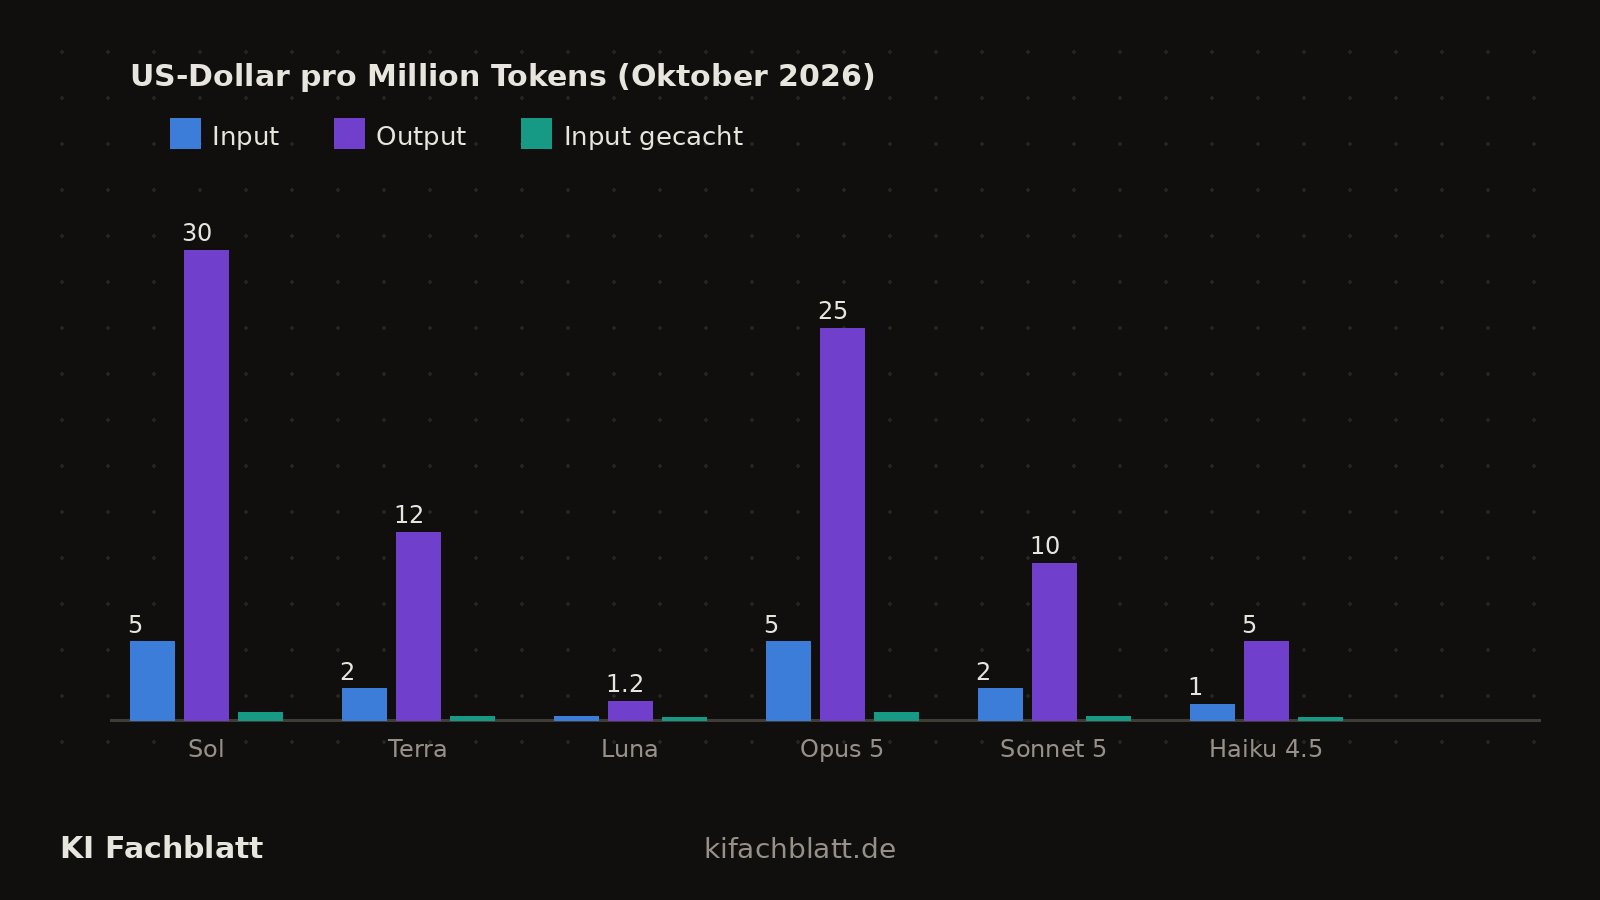
Preise pro Million Tokens in US-Dollar, aus den Preislisten von OpenAI und Anthropic, abgerufen am 20. Oktober 2026. Gecachter Input: OpenAI-Listenhinweis beziehungsweise 0,1x-Multiplikator bei Anthropic. [2][4]
Die Spreizung ist gewaltig: GPT-5.6 Luna kostet pro Token ein Zehntel von Terra, Claude Haiku 4.5 ein Fünftel von Opus 5, und der Unterschied zwischen Flaggschiff und Spar-Modell liegt bei Faktor 25. [2][4] Gleichzeitig schreibt OpenAI im eigenen Latenz-Leitfaden, dass kleinere Modelle nicht nur schneller und billiger sind, sondern bei richtiger Führung (längerer Prompt, Few-Shot-Beispiele, Feinschliff) größere sogar schlagen können. [5] Die Reihenfolge ist entscheidend: erst mit dem guten Modell eine Testmenge bauen (Evals statt Bauchgefühl), dann verkleinern und gegen die Testmenge prüfen, nie umgekehrt.
Eigene Rechnung: 50.000 Anfragen
Eigene Überschlagsrechnung für einen Dokumenten-Tagger: 50.000 Anfragen pro Monat mit je 4.000 Input-Tokens (davon 3.000 stabil: System-Prompt und Richtlinien) und 400 Output-Tokens, Modell GPT-5.6 Terra. [4]
| Variante | Input | Output | Summe/Monat |
|---|---|---|---|
| Ohne alles (Terra) | 200 Mio. × 2 $ = 400 $ | 20 Mio. × 12 $ = 240 $ | 640 $ |
| + Prompt-Caching (75 % gecacht) | 50 Mio. × 2 $ + 150 Mio. × 0,20 $ = 130 $ | 240 $ | 370 $ |
| + Batch API (50 % auf alles) | 65 $ | 120 $ | 185 $ |
| Stattdessen Luna ohne alles | 200 Mio. × 0,20 $ = 40 $ | 20 Mio. × 1,20 $ = 24 $ | 64 $ |
Drei Lesarten. Erstens: Caching und Batch zusammen drücken den Terra-Workload von 640 auf 185 Dollar, und beides verlangt keine Qualitätsänderung, nur Betriebsdisziplin. Zweitens: Das kleine Modell schlägt jede Optimierung des großen, wenn die Qualität in deiner Testmenge mitgeht; das ist eine Messfrage, keine Glaubensfrage. Drittens: Cache-Schreiben ist nicht geschenkt; bei OpenAI sind im Beispiel 150 Millionen geschriebene Cache-Tokens im ersten Umlauf mit 1,25-Fach-Preis eingerechnet? Nein, der Einfachheit halber haben wir die einmaligen Schreibkosten (hier rund 375 $ über den Monat verteilt bei vollständiger Erneuerung alle 30 Minuten im Dauerbetrieb) nicht eingerechnet; bei realistischen Chat-Verläufen mit wachsender Historie sind sie deutlich kleiner, aber sie gehören in jede seriöse Rechnung. [1]
Latenz: Was sich wie schnell anfühlt
OpenAI bündelt seine Erfahrung aus Kundenprojekten in sieben Prinzipien: Tokens schneller verarbeiten, weniger Tokens erzeugen, weniger Input-Tokens nutzen, weniger Anfragen machen, parallelisieren, die Nutzer weniger warten lassen und nicht alles mit einem LLM lösen. [5] Drei davon wirken sofort. Erstens: kürzere Ausgaben; die Faustregel des Leitfadens lautet, dass 50 Prozent weniger Output-Tokens etwa 50 Prozent weniger Latenz bringen, weil die Erzeugung der teuerste Schritt ist. [5] Zweitens: Streaming, das die Zeit bis zum ersten sichtbaren Zeichen (Time to First Token) drückt, ohne die Gesamtdauer zu ändern. Drittens: Parallelisieren, wo Aufgaben unabhängig sind, statt sie hintereinander durch ein Modell zu schieben.
Weniger offensichtlich, aber wirksam: Nicht jede Aufgabe braucht ein LLM. Der Leitfaden empfiehlt ausdrücklich, deterministische Teile (Validierung, Suche, einfache Weichen) klassisch zu lösen. [5] Ein Regex, der 95 Prozent der Fälle sortiert, ist schneller, billiger und genauer als jeder Prompt; das Modell ist für die restlichen fünf da.
Typische Fehler
- Caching ohne Präfix-Disziplin: Wenn der Anfang der Anfrage bei jedem Call anders aussieht (Zeitstempel, Zufalls-IDs), gibt es nie einen Treffer. [1]
- Batch für Nutzer-Anfragen: Wer wartet, braucht den synchronen Weg; Batch ist für Hintergrundarbeit. [3]
- Modell verkleinern ohne Testmenge: Die Ersparnis ist sicher, der Qualitätsverlust unbekannt; erst evaluieren, dann wechseln.
- Nur auf den Input-Preis schauen: Output kostet bei allen Anbietern ein Vielfaches des Inputs; ausgabefreudige Prompts sind teurer als lange Eingaben. [2][4]
- Latenz am falschen Ende suchen: Wenn die Antwort 2.000 Tokens lang ist, hilft kein schnelleres Modell, nur eine kürzere Antwort. [5]
Wie es weitergeht
Der systematische Vergleich der Preislisten (Blended Price, Kontextlängen, versteckte Posten) folgt in API-Preise vergleichen. Wer die Physik dahinter verstehen will, warum Tokens Zeit und Speicher kosten, liest Inferenz und Kosten verstehen; und für eigene Anwendungen mit Abruflogik lohnt sich der Blick in RAG selbst bauen, wo Caching und Chunkgröße direkt zusammenwirken.
Methode
Gelesen wurden am 20. Oktober 2026 die Prompt-Caching-Leitfäden von OpenAI und Anthropic einschließlich Preistabellen und Aufbewahrungsregeln, die Batch-API-Dokumentation, die OpenAI-Preisliste und der Latenz-Leitfaden von OpenAI. Alle Tabellen- und Diagrammzahlen stammen aus diesen Quellen; die Monatsrechnung ist eine eigene Überschlagsrechnung und im Text als solche gekennzeichnet, einschließlich des dort offengelegten Umgangs mit Cache-Schreibkosten. Der Text entstand mit KI-Unterstützung und wurde von der Redaktion verantwortet.
Grenzen
Preise und Caching-Regeln ändern sich schnell; alle Angaben beziehen sich auf den 20. Oktober 2026. Die Beispielrechnung vereinfacht (gleiche Anfragengröße, idealisierte Cache-Trefferquote von 75 Prozent, Schreibkosten separat diskutiert statt eingerechnet) und ersetzt keine Messung am eigenen Workload. Qualitätsunterschiede zwischen Modellen sind aufgabenabhängig und hier nicht gemessen. Die Faustregel zur Latenz stammt aus einem Anbieter-Leitfaden und ist keine universelle Messgröße.
Quellen
- Prompt caching, OpenAI Platform Docs (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- Prompt caching (inkl. Preistabelle), Anthropic Docs (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- Batch API, OpenAI Platform Docs (abgerufen 2026-10-20) ↩1 ↩2 ↩3
- OpenAI API Pricing, OpenAI (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- Latency optimization, OpenAI Platform Docs (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6