 KI
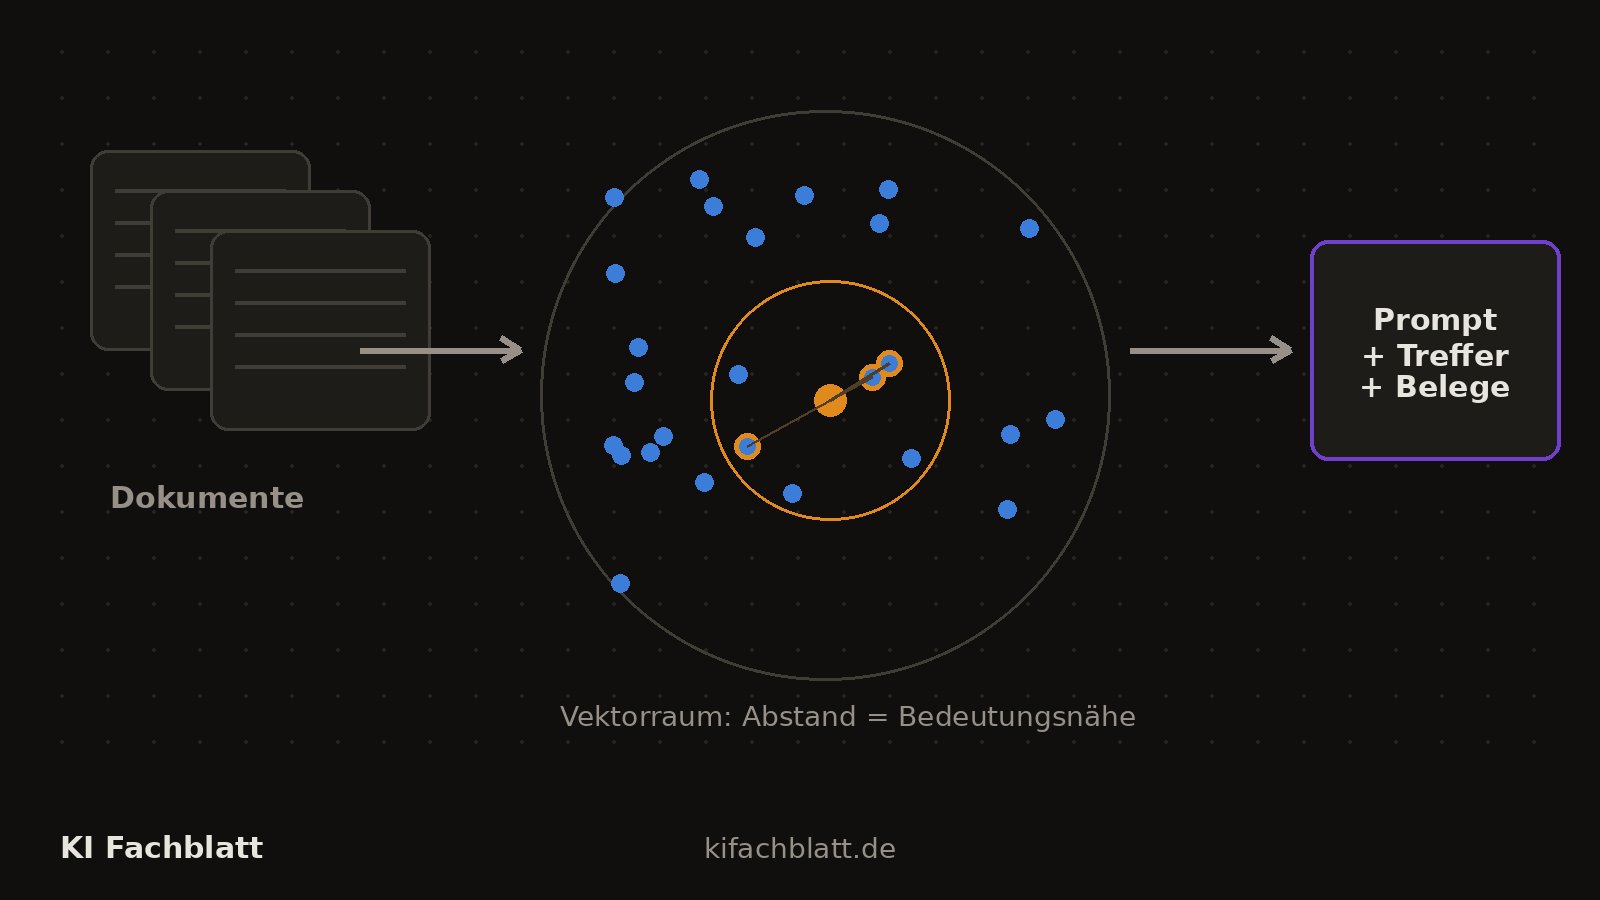
RAG (Retrieval-Augmented Generation, auf Deutsch etwa: Antworten mit vorherigem Nachschlagen) ist das Standardrezept, um ein Sprachmodell mit eigenem Wissen antworten zu lassen: Handbücher, Verträge, Wissensdatenbanken. Statt das Modell teuer nachzutrainieren, baust du eine Suchmaschine über deine Texte und legst die besten Treffer in den Prompt. Dieser Artikel baut das System Schritt für Schritt: Text zerlegen, Embeddings erzeugen, in einer Vektordatenbank ablegen, bei einer Frage die passenden Schnipsel holen und die Antwort mit Belegen schreiben lassen. Die Entscheidung, ob du überhaupt RAG brauchst oder der lange Kontext reicht, klärt RAG oder langer Kontext.
Woher das Muster kommt
Der Bauplan stammt aus dem RAG-Paper von Lewis und Kollegen (2020). Die Autoren kombinierten zwei Speicherarten: das parametrische Gedächtnis eines vortrainierten Modells (dort steckt, was beim Lernen in den Gewichten hängen blieb) und ein nicht-parametrisches Gedächtnis: einen dichten Vektorindex über Wikipedia, den ein neuronaler Retriever (DPR) abfragt. Das Ergebnis stellte damals bei drei offenen Frage-Antwort-Aufgaben einen neuen Bestwert auf, und die erzeugten Antworten waren nach Angaben der Autoren faktischer, spezifischer und vielfältiger als die des reinen Modells. [1]
Zwei Eigenschaften aus dem Paper erklären, warum das Muster bis heute trägt. Erstens: Das Wissen lässt sich aktualisieren, ohne das Modell anzufassen; die Autoren zeigten, dass sich der Index einfach austauschen lässt, wenn sich die Welt ändert. [1] Zweitens: Jede Antwort lässt sich auf die gefundenen Stellen zurückführen; man kann sehen, worauf sich das Modell stützt. Genau diese beiden Eigenschaften willst du auch in deinem Selbstbau.
Schritt 1: Text zerlegen (Chunking)
Der Retriever findet Schnipsel, keine Dokumente. Deshalb wird jedes Dokument in Stücke zerlegt, das Chunking. Die Größe ist ein Kompromiss: Zu klein, und der Treffer fehlt der Zusammenhang ("die genannte Frist" ohne den Satz davor); zu groß, und der Treffer verwässert, weil das Embedding den Durchschnitt vieler Themen abbildet. Aus der Praxis der Redaktion: 300 bis 800 Tokens pro Schnipsel mit einem Überlapp von 10 bis 15 Prozent ist ein robuster Startpunkt für Prosa; Tabellen und Code gehören in eigene, nie mitten durchtrennte Schnipsel. Das sind Erfahrungswerte, keine Norm; die richtige Größe entscheidet nur ein Test mit deinen echten Fragen (Vorgehen: Evals statt Bauchgefühl).
Wichtiger als die exakte Größe sind die Metadaten: Speichere zu jedem Schnipsel Quelle, Titel, Abschnitt und Position. Sie machen später die Belegzeile möglich und erlauben Filter, etwa "nur Verträge von 2026". Wer die Metadaten wegwirft, bekommt ein System, das Antworten ohne Herkunftsnachweis erzeugt, und baut damit einen Halluzinations-Verstärker mit Extraaufwand.
Schritt 2: Embeddings erzeugen
Ein Embedding-Modell übersetzt jeden Schnipsel in einen Zahlenvektor; die Kosinus-Ähnlichkeit zwischen zwei Vektoren misst dann inhaltliche Nähe. OpenAI beschreibt den Nutzen so: kleine Abstände bedeuten hohe Verwandtschaft, große Abstände geringe; typische Anwendungen sind Suche, Clustering, Empfehlungen und Klassifikation. [2] Aktuell bietet OpenAI zwei Modelle der dritten Generation an: text-embedding-3-small mit 1.536 Dimensionen und text-embedding-3-large mit 3.072; beide lassen sich über den dimensions-Parameter kürzen, ohne dass die Vektoren ihre Bedeutungsstruktur verlieren. Die Abrechnung erfolgt pro Input-Token. [2]
Zwei Regeln verhindern die teuersten Anfängerfehler. Erstens: Frage und Antwort landen im selben Vektorraum, also müssen beide mit demselben Modell eingebettet werden; Embeddings verschiedener Modelle sind untereinander unvergleichbar. Zweitens: Einmal erzeugte Vektoren bleiben gültig, bis du das Embedding-Modell wechselst; ein Wechsel heißt, den kompletten Bestand neu einzubetten. Die Preisordnung ist dabei moderat: OpenAI beziffert grob 62.500 Seiten pro US-Dollar für das Small-Modell (bei rund 800 Tokens pro Seite). [2]
Schritt 3: Index aufbauen
Der Index beantwortet die Frage: Welche Vektoren liegen am nächsten an diesem Anfragevektor? Für den Selbstbau reichen zwei ausgewachsene Optionen. FAISS ist eine Open-Source-Bibliothek von Meta AI für effiziente Ähnlichkeitssuche und Clustering in dichten Vektoren; sie läuft lokal im Prozess, ohne Server. [3] pgvector bringt Vektor-Ähnlichkeitssuche als Open-Source-Erweiterung in Postgres; praktisch, wenn deine Dokumente ohnehin in der Datenbank liegen und du Vektoren und Metadaten gemeinsam abfragen willst. [4] Beide unterstützen approximative Suche, die bei großen Beständen Geschwindigkeit gegen minimale Trefferverluste tauscht.
| Kriterium | FAISS | pgvector |
|---|---|---|
| Art | Bibliothek im Prozess | Postgres-Erweiterung |
| Betrieb | kein Server nötig | läuft in der vorhandenen Datenbank |
| Metadaten | selbst verwalten | als Tabellenspalten neben dem Vektor |
| Lizenz | MIT | Open Source (PostgreSQL-Lizenz) |
| Passt zu | Experimente, lokale Tools, große statische Bestände | Produkte mit bestehender Postgres, Filter über SQL |
Schritt 4: Abrufen und antworten
Zur Laufzeit wird die Frage mit demselben Embedding-Modell vektorisiert, der Index liefert die k nächsten Schnipsel (k zwischen 3 und 10 ist ein guter Start), und diese wandern mit klaren Markierungen in den Prompt. Entscheidend ist die Arbeitsanweisung: Antworte nur aus den beigelegten Stellen, und wenn sie nichts hergeben, sag das. Dazu kommt die Belegpflicht: Jede Kernaussage bekommt die Nummer ihrer Quelle. Das ist kein Stilfeature, sondern die technische Umsetzung von Grounding, dem Verankern der Antwort in überprüfbarem Material.
# Laufzeit: Frage einbetten, Treffer holen, belegt antworten
q = embed(frage)                        # gleiches Modell wie beim Index
treffer = index.search(q, k=5)          # 5 naechste Schnipsel mit Metadaten

kontext = "\n\n".join(
    f"[Quelle {i+1}: {t.meta['titel']}]\n{t.text}"
    for i, t in enumerate(treffer)
)

antwort = llm(messages=[
    {"role": "system", "content": (
        "Antworte NUR aus den beigelegten Quellen. "
        "Zitiere jede Aussage mit [Quelle n]. "
        "Wenn die Quellen die Frage nicht beantworten, sage das offen.")},
    {"role": "user", "content": f"Quellen:\n{kontext}\n\nFrage: {frage}"}
])
Wo es klemmt: die ehrliche Fehlerliste
- Der Retriever findet die falsche Stelle: Synonyme und Fachbegriffe verfehlen sich. Gegenmittel: k erhöhen, Metadatenfilter, hybride Suche aus Vektoren und Volltext.
- Der Treffer ist richtig, die Antwort geht darüber hinaus: Das Modell ergänzt aus seinem Trainingswissen. Gegenmittel: strikte Arbeitsanweisung, Temperatur 0, Antworten gegen die Treffer zurückprüfen.
- Veraltete Schnipsel: Der Index altert nicht von allein; plane Lösch- und Neu-Einbettungsläufe ein. Die Austauschbarkeit des Index ist die Kernstärke des Musters. [1]
- Kontextfenster überlaufen: 10 Treffer à 800 Tokens sprengen kleine Kontexte; Treffer kürzen oder k begrenzen. Grundlagen: Tokens, Kontext, Kosten.
- Vertrauliche Daten im Prompt: Alles, was im Prompt landet, geht an den API-Anbieter; für interne Dokumente gehört das in die Anbieterwahl oder zu lokalen Modellen.
Eigene Rechnung: Was das kostet
Eigene Überschlagsrechnung mit den Preisen vom 20. Oktober 2026: 10.000 Dokumentenseiten à 800 Tokens ergeben 8 Millionen Tokens einmalig einzubetten; bei den von OpenAI genannten rund 62.500 Seiten pro US-Dollar für text-embedding-3-small kostet der Erstaufbau etwa 16 US-Cent. [2] Pro Anfrage kommen rund 4.000 Tokens Abrufkontext in den Sprachmodell-Prompt; bei GPT-5.6 Terra (2,00 $ pro Million Input-Tokens) sind das 0,8 Cent Abrufkosten pro Frage, zuzüglich der Antwort-Tokens. Der Engpass ist also nicht die Einbettung, sondern der tägliche Prompt-Verkehr; dort helfen Prompt-Caching und die Rezepte aus Kosten- und Latenz-Tuning.
Wie es weitergeht
Damit steht der Kern. Wer die Suchseite vertiefen will, liest Embeddings und Vektorsuche verstehen; wer den Abruf vom Modell selbst steuern lassen will (der Agent entscheidet, ob und wonach er sucht), findet das Muster als Agentic RAG in Agenten-Architekturen. Und bevor du die Qualität anhand von Einzelfällen beurteilst, baue eine kleine Testmenge nach Evals statt Bauchgefühl.
Methode
Gelesen wurden am 20. Oktober 2026 das RAG-Paper (Abstract, Einleitung und Ergebnisdiskussion), der OpenAI-Leitfaden zu Embeddings einschließlich der dort genannten Modell- und Preisbeispiele sowie die Projektseiten von FAISS und pgvector. Die Kostenrechnung ist eine eigene Überschlagsrechnung auf Basis der OpenAI-Angaben und als solche gekennzeichnet; Chunkgrößen und k-Werte sind redaktionelle Erfahrungswerte. Der Text entstand mit KI-Unterstützung und wurde von der Redaktion verantwortet.
Grenzen
Chunkgrößen, k-Werte und Fehlerliste sind Praxiswerte, keine Benchmark-Ergebnisse; die richtige Konfiguration hängt vom Datenbestand ab. Die Preis- und Modellangaben von OpenAI beziehen sich auf den 20. Oktober 2026 und können sich ändern. FAISS und pgvector wurden nicht für diesen Artikel neu installiert und gemessen; die Einordnung folgt den Projektbeschreibungen. Das RAG-Paper beschreibt den Forschungsprototyp von 2020; heutige Systeme weichen in Details ab (andere Retriever, hybride Suche), das Grundmuster ist aber unverändert.
Quellen
- Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, arXiv:2005.11401 (Lewis u. a., NeurIPS 2020) (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4
- Vector embeddings, OpenAI Platform Docs (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4 ↩5
- FAISS: A library for efficient similarity search and clustering of dense vectors, GitHub: facebookresearch/faiss (MIT) (abgerufen 2026-10-20) ↩1 ↩2
- pgvector: Open-source vector similarity search for Postgres, GitHub: pgvector/pgvector (abgerufen 2026-10-20) ↩1 ↩2