KI
Praxis
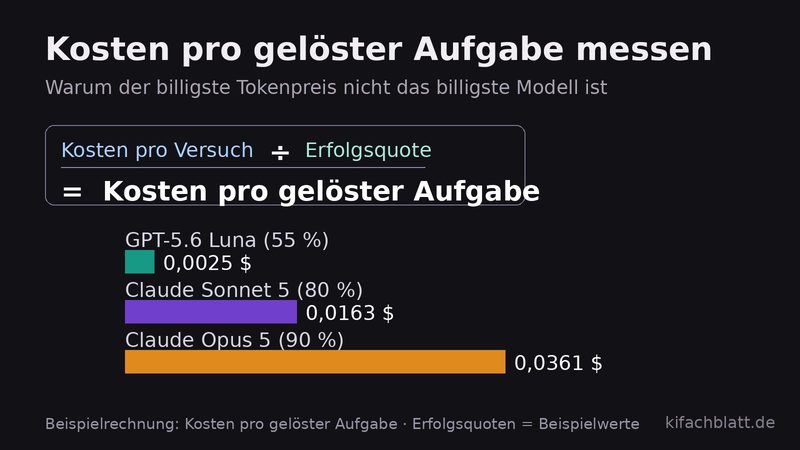
Kosten pro gelöster Aufgabe messen: vom Tokenpreis zur Aufgabe
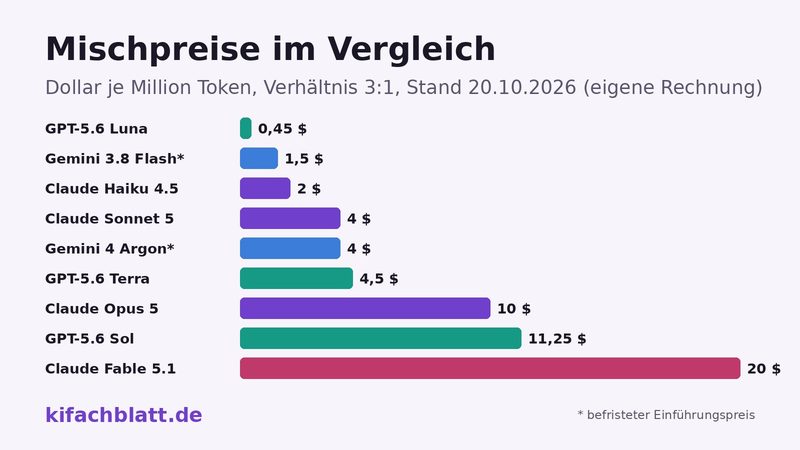
Tokenpreise allein sagen nicht, was KI wirklich kostet. So messen Sie in vier Schritten die Kosten pro gelöster Aufgabe und vergleichen Modelle fair.
Lesen →
Tokenpreise allein sagen nicht, was KI wirklich kostet. So messen Sie in vier Schritten die Kosten pro gelöster Aufgabe und vergleichen Modelle fair.
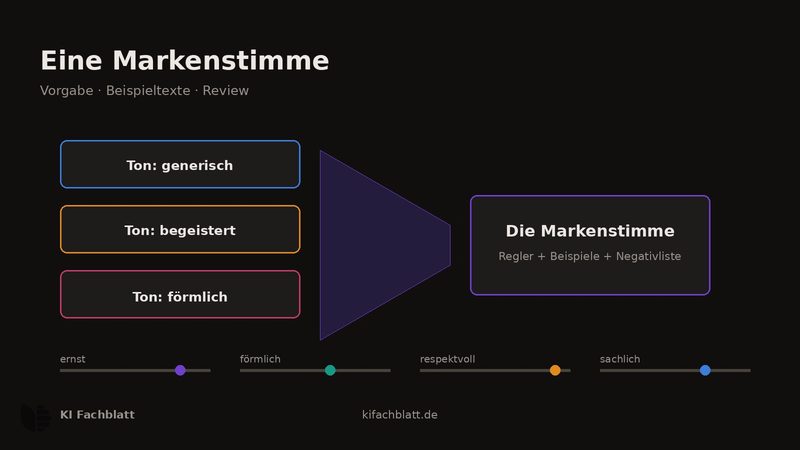
Sprachmodelle schreiben im Durchschnittston ihrer Trainingsdaten. Wie Marken ihre Stimme messbar machen, in Werkzeugen hinterlegen und mit Review sichern.
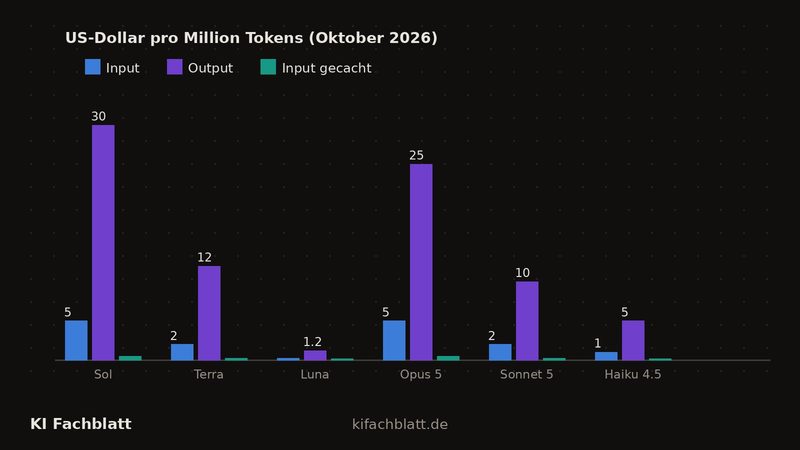
Eingabe, Ausgabe, Cache, Batch: So lesen Sie LLM-Preislisten richtig, bringen Anbieter auf eine vergleichbare Größe und finden gern vergessene Posten.
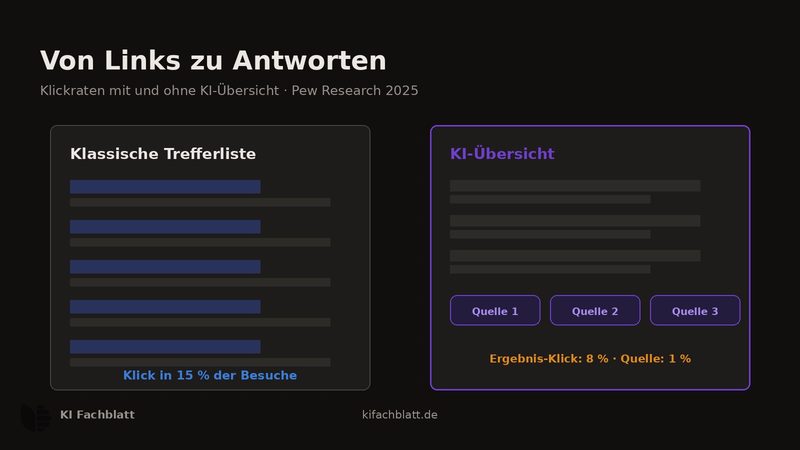
AI Overviews, Chatbots und Antwortmaschinen verändern, wie Inhalte gefunden werden. Was gemessen ist, was Google selbst rät und was hinter llms.txt steckt.
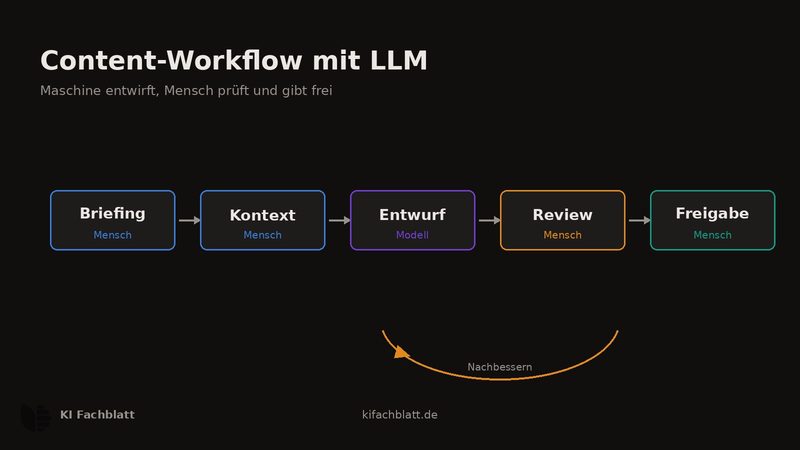
Wie Redaktionen Sprachmodelle sinnvoll einbauen: klare Briefings, maschinelle Entwürfe, menschliche Prüfung. Mit Produktivitätszahlen und Googles Regeln.
Welche Metriken ein LLM-Dienst wirklich braucht: TTFT und Warteschlange aus dem Server, Rate-Limits lesen, Token-Budgets einziehen und Alarme, die nicht nerven.
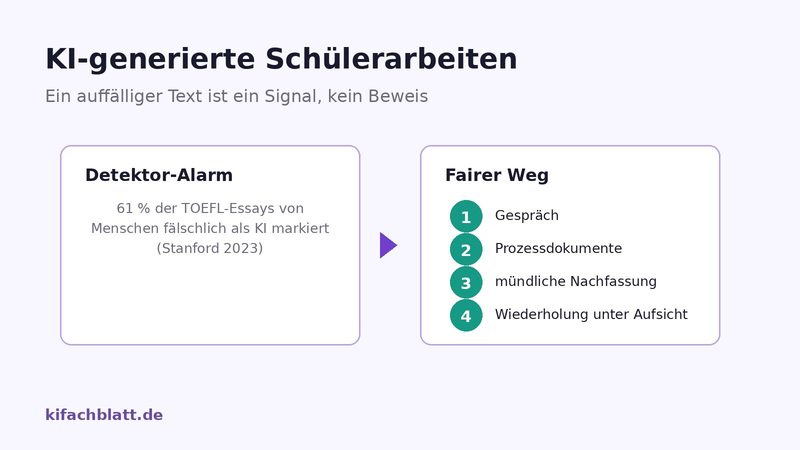
Warum KI-Detektoren in Studien so stark irren, wie Lehrkräfte Verdachtsfällen fair begegnen und welche Aufgabenformate das Problem an der Wurzel verkleinern.
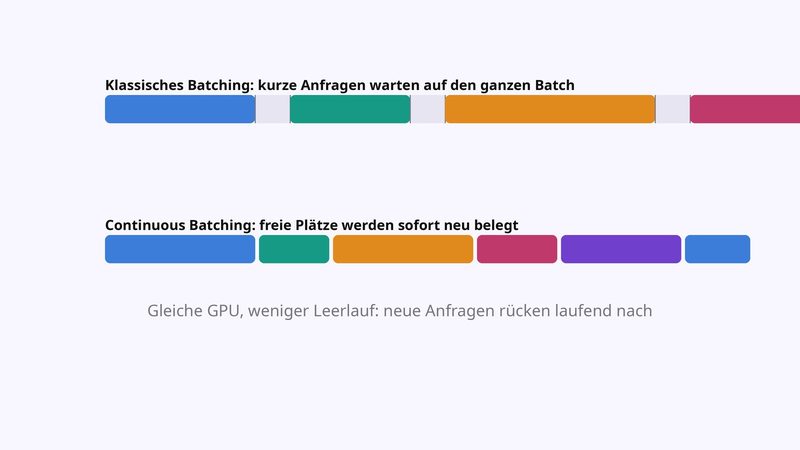
Continuous Batching, PagedAttention und die Kennzahlen TTFT und TPOT: Wie ein Inferenz-Server viele Anfragen zugleich beantwortet und wo die Grenzen liegen.
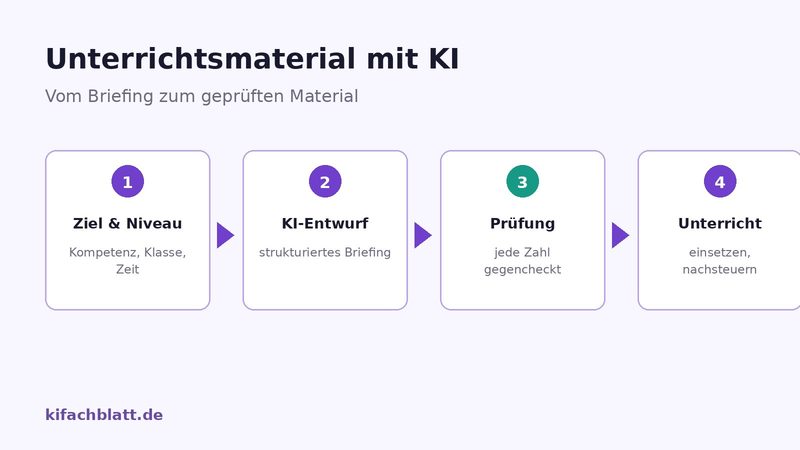
Wie Lehrkräfte mit Sprachmodellen differenziertes Material entwerfen: ein Workflow mit Kontrollpunkten, ein Briefing zum Kopieren und seine Grenzen.
Der Hugging Face Hub ist der zentrale Marktplatz für offene KI-Modelle. Wie du Modellkarten, Kennzahlen und Leaderboards richtig liest und Blindgänger erkennst.
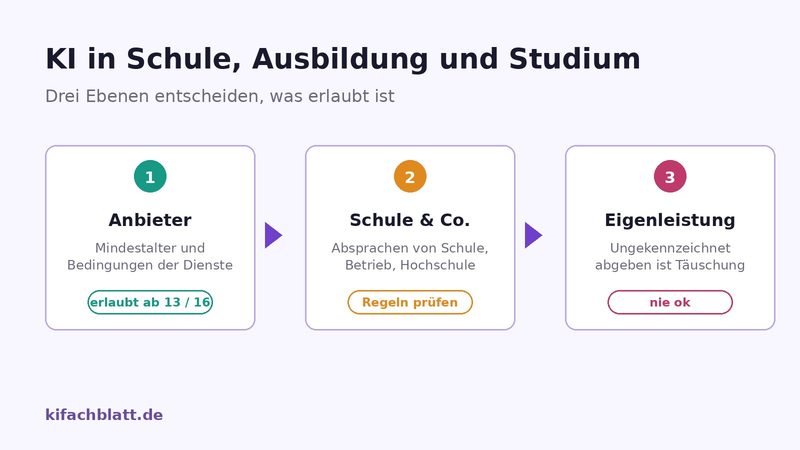
Wann Schüler, Azubis und Studierende KI nutzen dürfen, was Anbieter, Schulen und Hochschulen vorgeben und wo die Täuschungsgrenze verläuft.
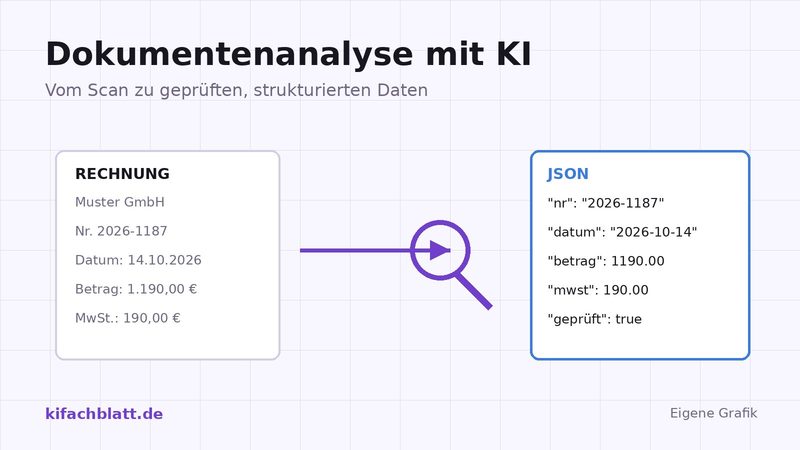
Wie KI Belege in strukturierte Daten übersetzt, warum die E-Rechnung die Arbeit erleichtert und welche Prüfung die GoBD verlangt.
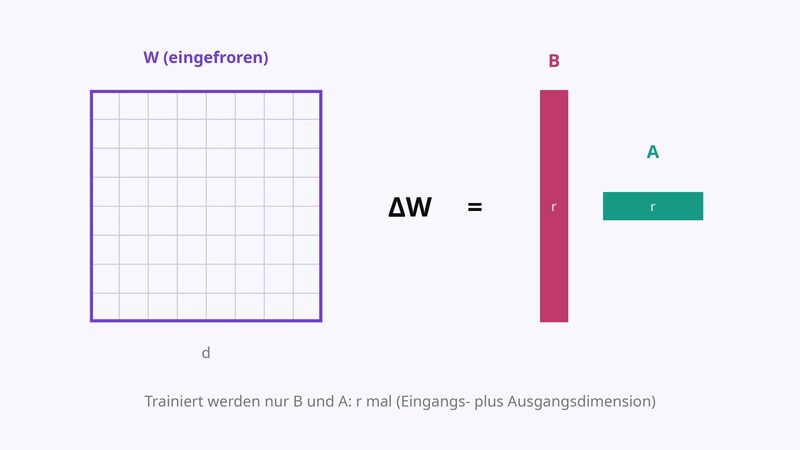
Wie LoRA ein Milliarden-Modell mit Millionen Zusatzparametern umbaut: die Mathematik dahinter, eine eigene Parameter-Rechnung und der Trainingslauf mit PEFT.
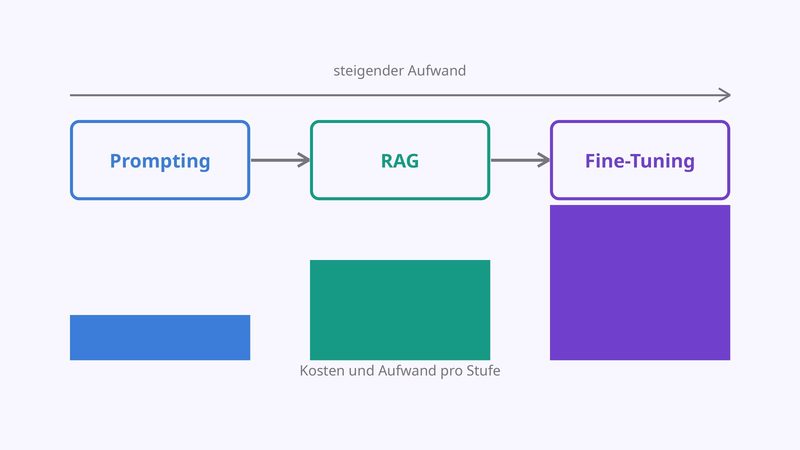
Prompting, RAG oder Fine-Tuning? Was jeder Weg kann, was Fine-Tuning nicht kann (aktuelles Wissen) und wie die Kostenrechnung die Entscheidung trägt.
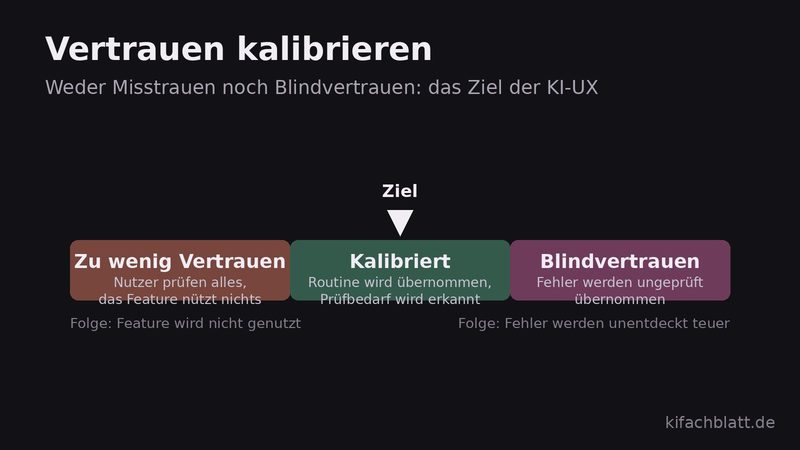
Wie Sie KI-Features so gestalten, dass Nutzer ihnen richtig vertrauen: Unsicherheit zeigen, Fehler prüfbar machen, Fallbacks bauen und Erwartungen steuern.
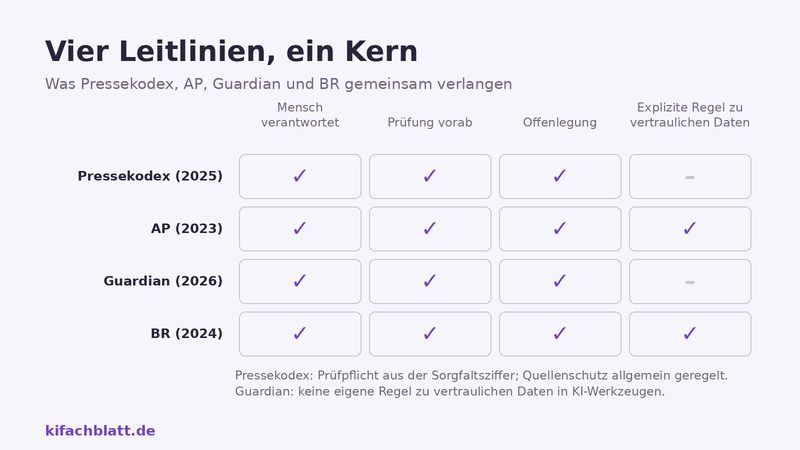
Pressekodex, AP, Guardian und BR formulieren fast dieselben Regeln. Was Redaktionen kennzeichnen sollten und wie eine eigene Deklaration gelingt.
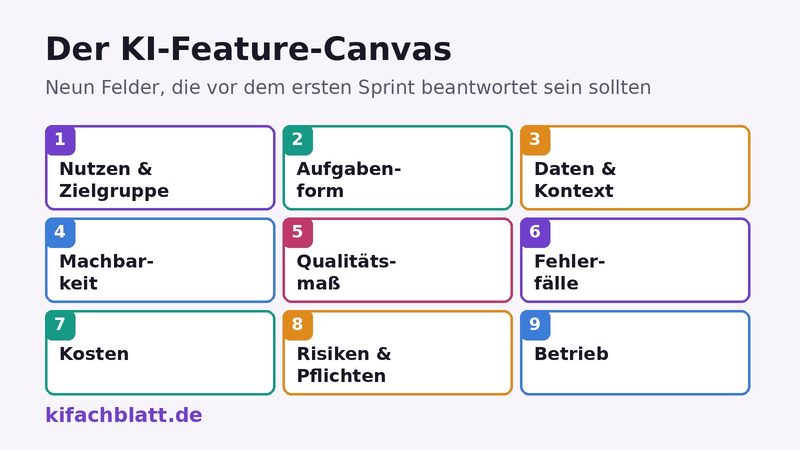
Neun Felder, mit denen Sie ein KI-Feature vor dem ersten Sprint prüfen: Nutzen, Daten, Machbarkeit, Qualitätsmaß, Kosten und der Plan für den Fehlerfall.
KI transkribiert Interviews in Minuten, fast auf Profi-Niveau. Was Whisper und Co. leisten, wo sie Fehler machen und wie ein sauberer Workflow aussieht.
Gute Prompts sind wiederverwendbares Werkzeug. Wie man sie sammelt, versioniert und pflegt, damit aus einmaligem Ausprobieren ein wachsender Bestand wird.
Modelle lesen Bilder: Was Bildverständnis bei Dokumenten, Screenshots und Diagrammen leistet, wo es Fehler macht und wie du Ergebnisse zuverlässig absicherst.
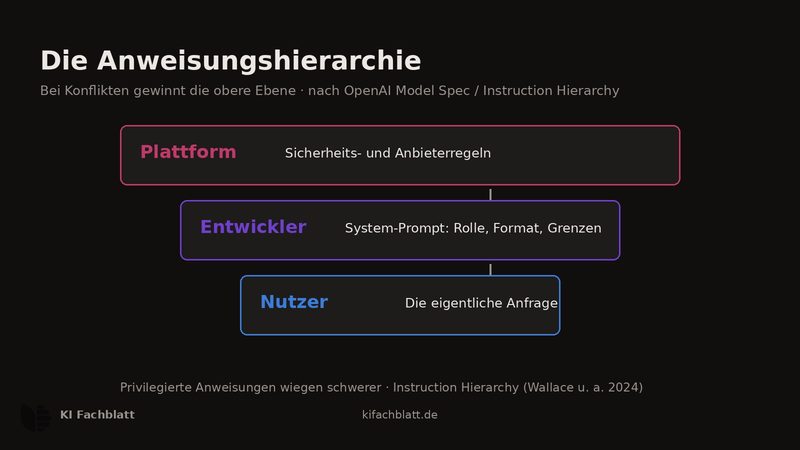
Was ein System-Prompt ist, wie die Anweisungshierarchie von OpenAI und Anthropic funktioniert, was in den System-Prompt gehört und was dort nichts verloren hat.
Zwei von drei Bewerbungen entstehen mit KI-Hilfe. Was das für die Auswahl bedeutet, warum Detektoren keine Lösung sind und wie Personaler Prozesse umbauen.
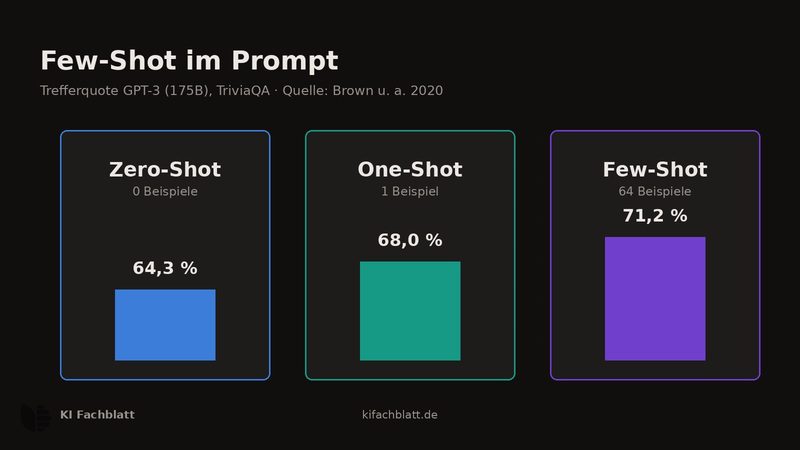
Warum ein paar Beispiele im Prompt oft mehr bringen als lange Anweisungen, was die Forschung dazu wirklich zeigt und wie man Beispiele richtig baut.
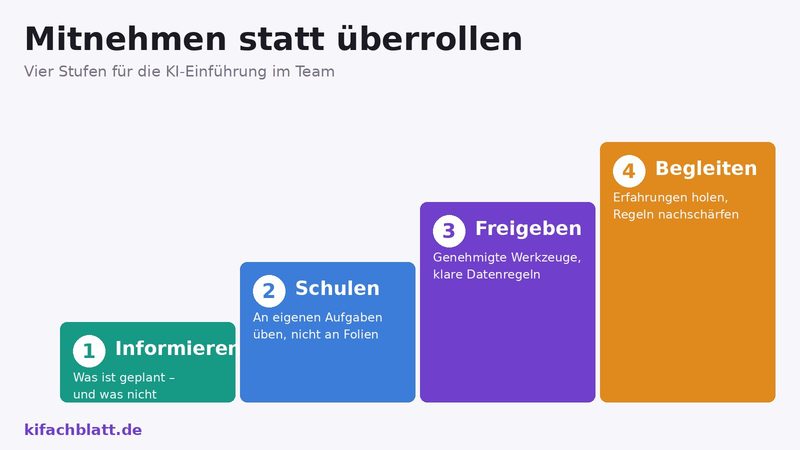
Technik ist der leichte Teil: Wie du Belegschaft, Führung und Betriebsrat bei der KI-Einführung mitnimmst – mit Schulung, Regeln und Freigaben.
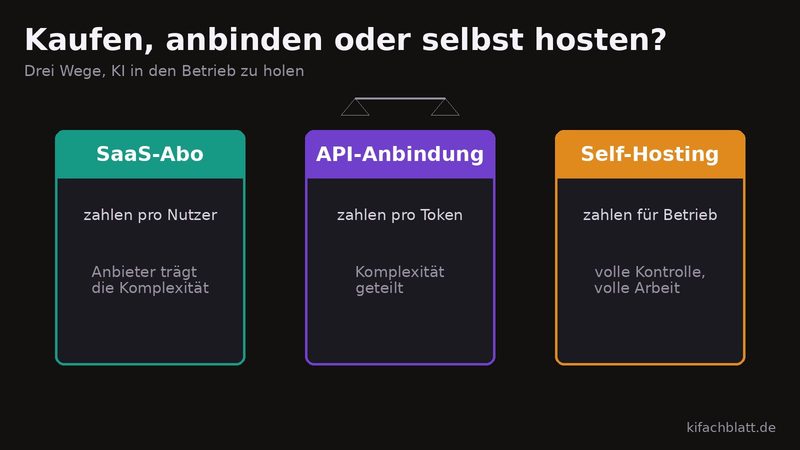
Fertigabo, API-Anbindung oder eigener Server? Die drei Beschaffungswege für KI: Was sie kosten, wo die versteckten Posten stecken, wann sich was rechnet.
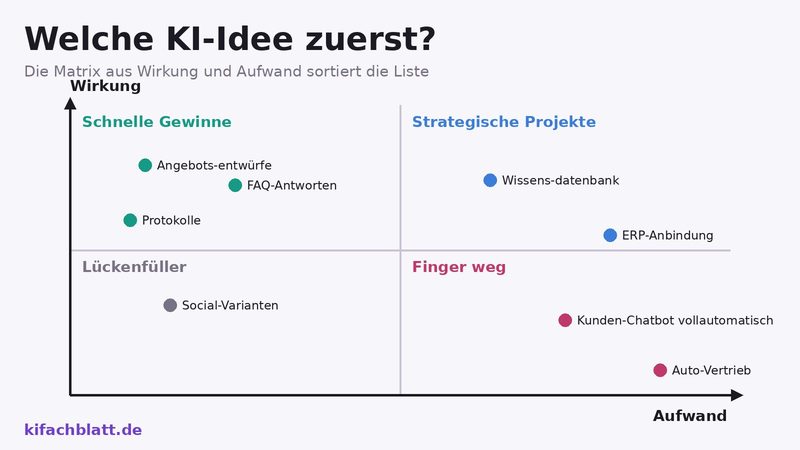
Vom Bauchgefühl zur Liste: KI-Anwendungsfälle im Betrieb finden, nach Wirkung und Aufwand sortieren und mit einem Piloten starten, der misst statt verspricht.
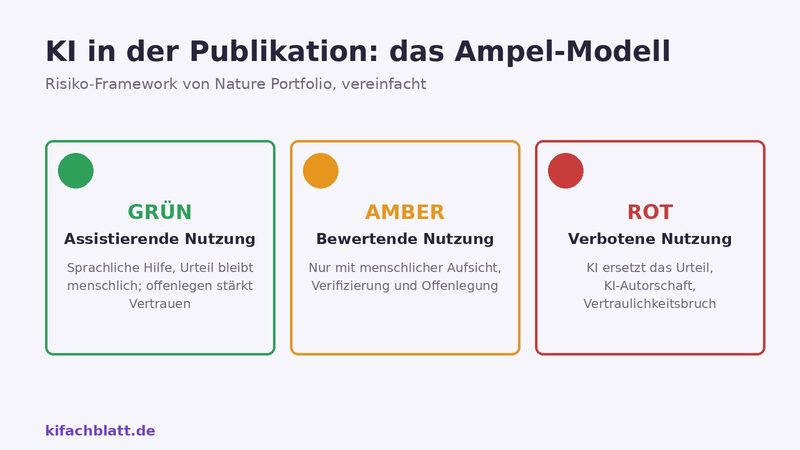
COPE, ICMJE, Nature und Science sind sich einig: KI ist nie Autorin, die Nutzung wird offengelegt. Was wohin gehört und was verboten ist.
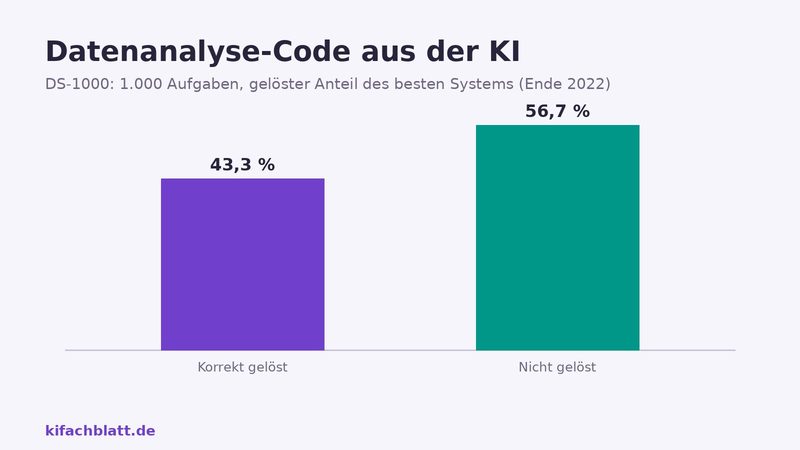
Tabelle hochladen, Frage stellen, Diagramm bekommen: KI-Assistenten schreiben den Analyse-Code mit. Wo das hilft und wie die Gegenprobe aussieht.
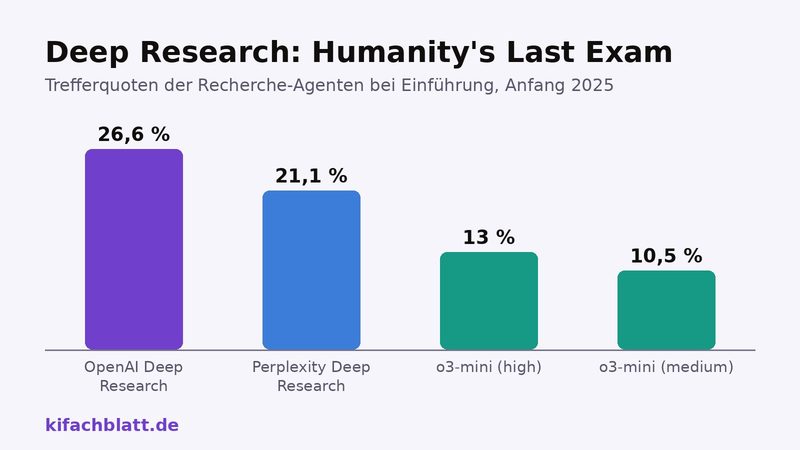
Recherchierende KI-Agenten lesen Hunderte Quellen und liefern Berichte mit Zitaten. Was die Angebote leisten, was sie kosten und wo sie irren.
Die drei großen Hebel für günstigere und schnellere LLM-Anwendungen: Prompt-Caching, Batch API und die richtige Modellgröße, mit Zahlen und eigener Rechnung.
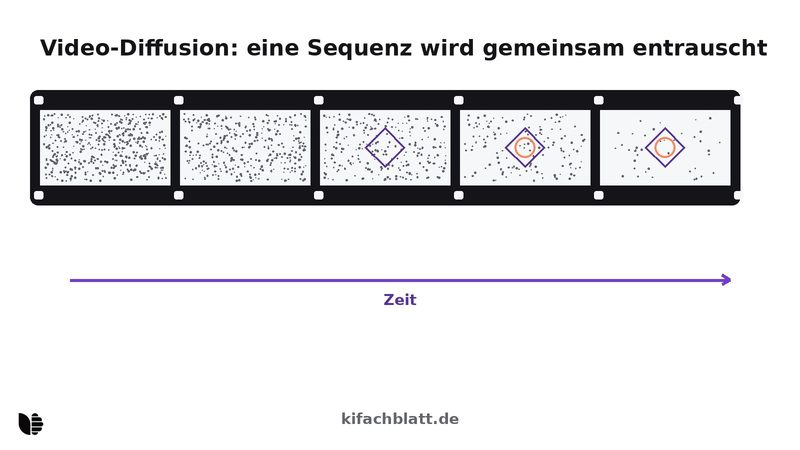
Videomodelle nach dem Sora-Aus: Was Veo 3.1, Runway Gen-4.5 und Kling 3.0 können, wie Video-Diffusion funktioniert und woran die Clips bis heute scheitern.
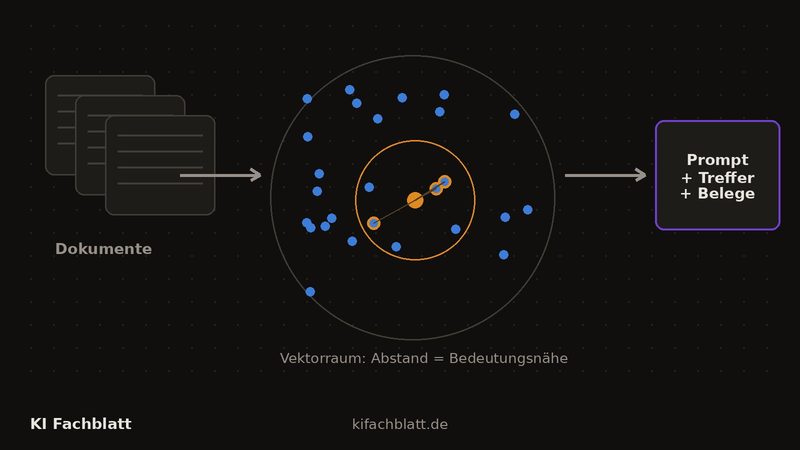
Ein eigenes Retrieval-System von null: Text zerlegen, Embeddings erzeugen, Vektoren indexieren, Treffer in den Prompt legen und mit Quellenangabe antworten.
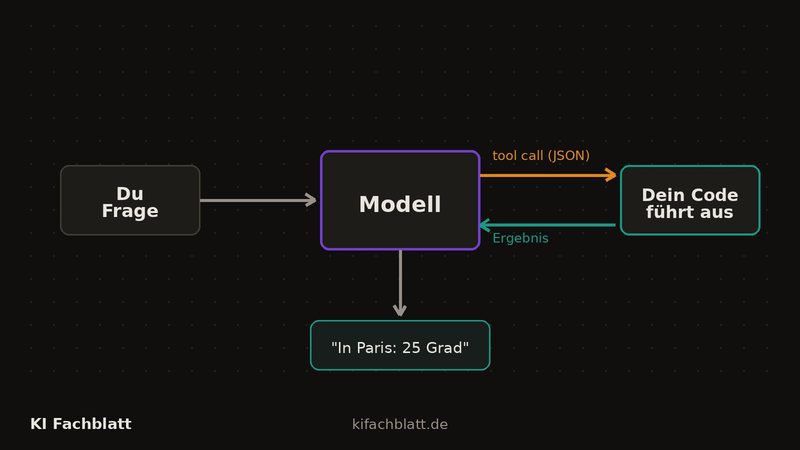
Wie ein Sprachmodell deine Funktionen aufruft: Werkzeugdefinition per JSON Schema, die fünf Schritte der Aufruf-Schleife, Client- und Server-Tools, Fehler.
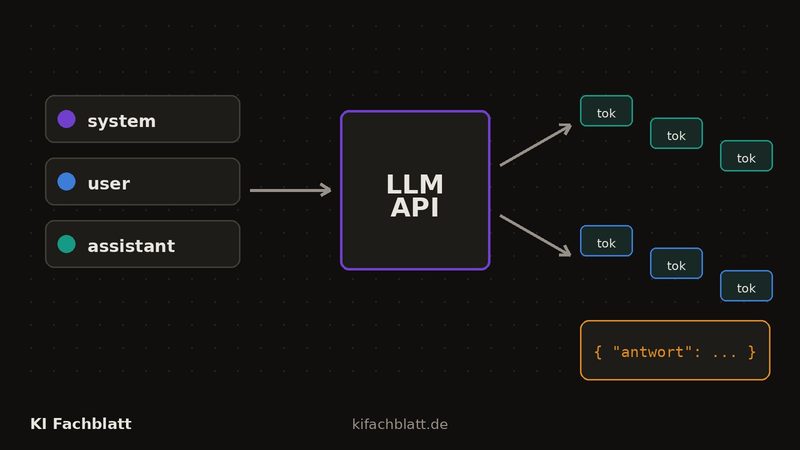
Wie ein API-Aufruf an ein Sprachmodell aufgebaut ist, welche Parameter das Verhalten steuern, wie Streaming funktioniert und wann Structured Output Pflicht ist.
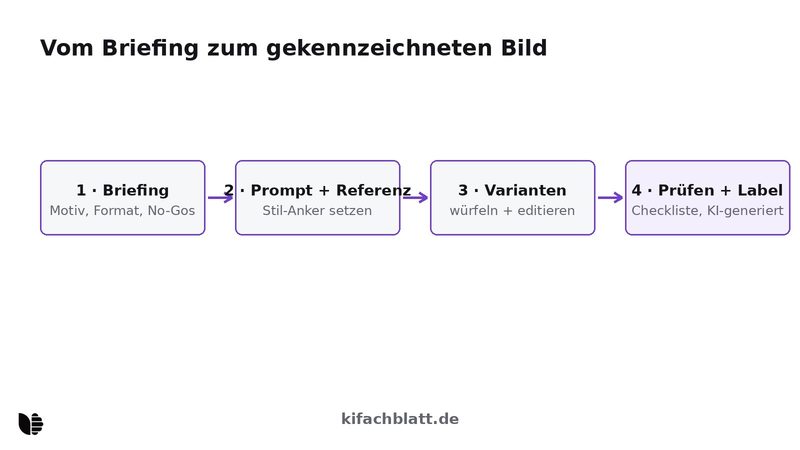
Vom Prompt zur Bildserie: Midjourney, Firefly und API-Modelle gezielt steuern, typische Fehler prüfen und KI-Bilder sauber kennzeichnen.