 KI
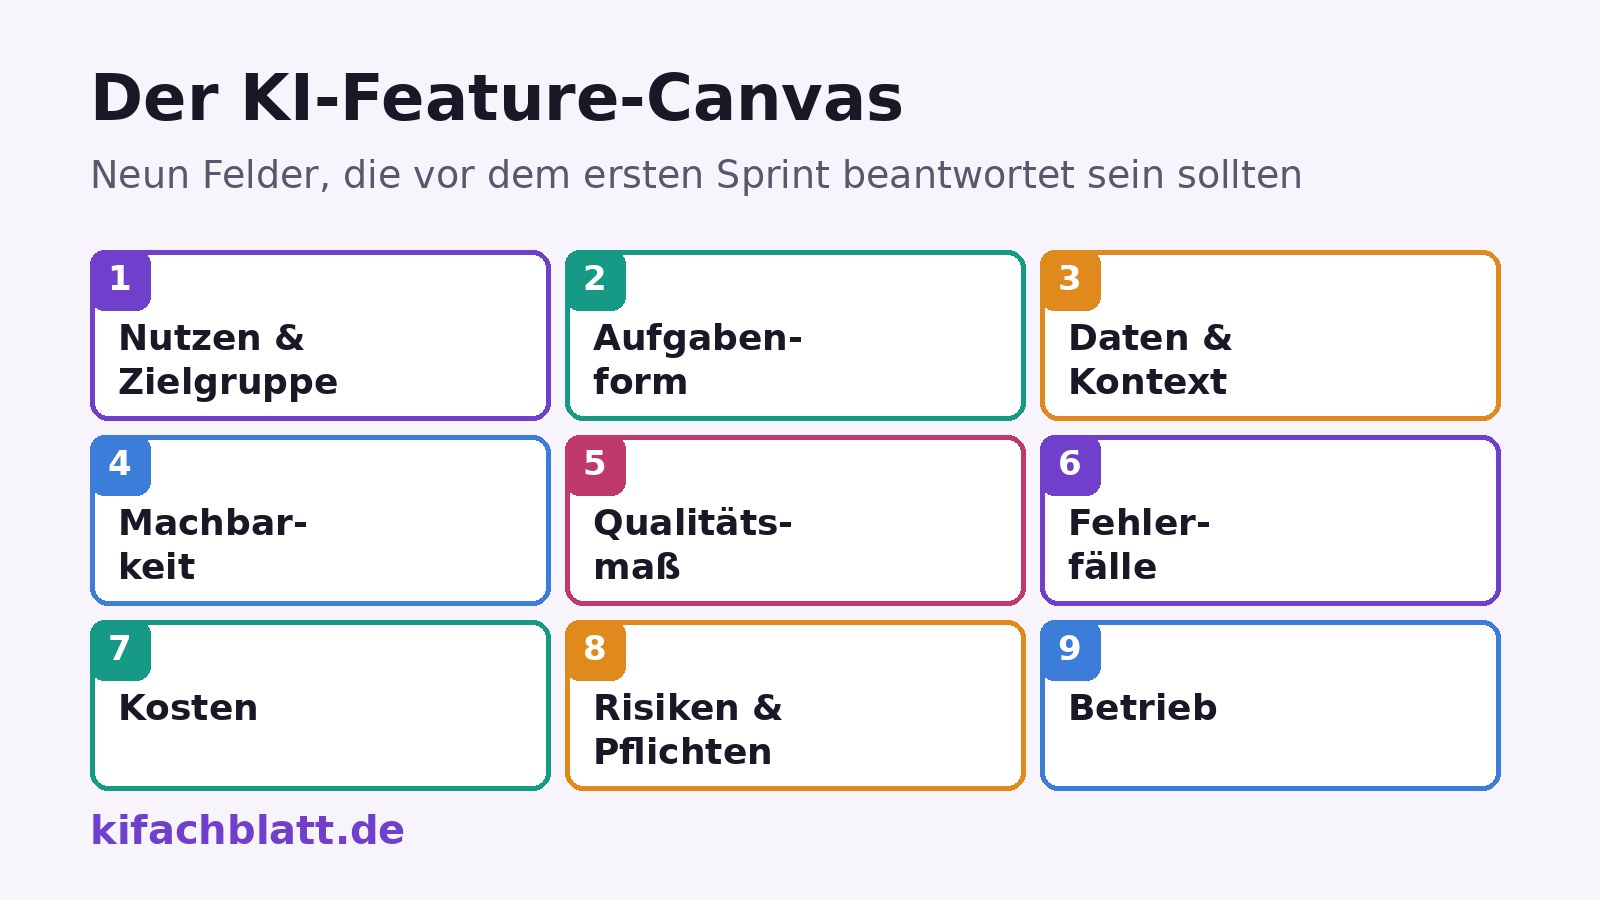
Zwischen einer beeindruckenden KI-Demo und einem KI-Feature, das Menschen jeden Tag zuverlässig nutzen, liegt mehr Arbeit als zwischen der Idee und der Demo. Die Demo zeigt den einen Fall, der klappt. Das Produkt muss die tausend Fälle überstehen, die nicht im Skript standen: leere Eingaben, veraltete Daten, Nutzer, die etwas ganz anderes wollen. Dieser Beitrag stellt einen Canvas aus neun Feldern vor, mit dem Produktteams ein KI-Feature prüfen, bevor der erste Sprint läuft. Er bündelt Regeln aus Googles Praxisleitfaden für maschinelles Lernen [1], der klassischen Analyse technischer Schulden in ML-Systemen [2], dem Risikorahmen des NIST [3], der Zeithorizont-Messung von METR [4] und den Gestaltungsrichtlinien für Mensch-KI-Interaktion von Microsoft Research [5].
Warum KI-Features eine eigene Planung brauchen
Klassische Software ist deterministisch: Gleiche Eingabe, gleiche Ausgabe, und ein Fehler ist ein Bug. Ein KI-Feature ist probabilistisch: Gleiche Eingabe, unterschiedliche Ausgaben, und eine gewisse Fehlerrate ist Normalfall, nicht Ausnahme. Dazu kommen laufende Grenzkosten: Jede Nutzung kostet Rechenzeit, also Geld, und die Rechnung wächst mit dem Erfolg des Features. Und schließlich hängt das Verhalten an einem Modell eines Anbieters, das sich mit dem nächsten Update ändern kann.
Dass diese Unterschiede unterschätzt werden, ist kein neues Problem. Schon 2015 beschrieben Google-Ingenieure um D. Sculley, wie schnell gebaute ML-Systeme massive laufende Wartungskosten erzeugen: schleichende Abhängigkeiten zwischen Datenquellen, versteckte Rückkopplungen, Konfigurationen, die niemand mehr überblickt [2]. Ihre Kernbotschaft: Das Modell ist nur ein kleiner Teil des Systems, der Rest ist Rohrleitung. Für LLM-Features gilt das unverändert, nur dass Prompt, Kontextaufbereitung und Auswertung die Rohrleitung bilden.
Der wichtigste Gegenentwurf zur KI-Begeisterung kommt aus Googles „Rules of Machine Learning“ [1]. Regel Nummer eins: Keine Angst davor, ein Produkt ohne maschinelles Lernen zu veröffentlichen. Wenn eine Heuristik fünfzig Prozent des Nutzens bringt, ist sie der bessere Start, denn sie ist nachvollziehbar, billig und sofort da. Regel Nummer zwei: Erst Messgrößen entwerfen und erfassen, dann Modelle bauen. Beides läuft auf dasselbe hinaus: Ein KI-Feature beginnt nicht mit dem Modell, sondern mit der Frage, woran man Erfolg überhaupt erkennt.
Der Canvas: neun Felder
Der Canvas lässt sich in einem Workshop von ein bis zwei Stunden mit Produkt, Technik und Fachseite ausfüllen. Die Reihenfolge der Felder ist egal, aber kein Feld darf leer bleiben. „Wird sich beim Bauen klären“ ist keine Antwort, sondern eine unbezifferte Risikozusage.
| Feld | Leitfrage | Fertig, wenn |
|---|---|---|
| 1. Nutzen und Zielgruppe | Wer hat welches Problem, und wie löst die Person es heute? | Eine Zielgruppe und ihre heutige Umgehungslösung sind notiert. |
| 2. Aufgabenform | Was genau bekommt das Modell, was soll es ausgeben? | Fünf echte Beispiel-Ein- und Ausgaben liegen vor. |
| 3. Daten und Kontext | Woher kommt das Wissen, das das Modell braucht? | Quelle, Aktualität und Nutzungsrecht sind geklärt. |
| 4. Machbarkeit | Können heutige Modelle diese Aufgabe zuverlässig? | Ein Vorabtest mit mindestens 20 echten Fällen liegt vor. |
| 5. Qualitätsmaß | Woran messen wir „gut genug“? | Ein eigener Test mit Schwelle ist definiert. |
| 6. Fehlerfälle | Was passiert, wenn das Modell irrt oder nicht antwortet? | Fallback und Verantwortung sind festgelegt. |
| 7. Kosten | Was kostet eine gelöste Aufgabe im Zielbetrieb? | Eine Rechnung mit offengelegten Annahmen existiert. |
| 8. Risiken und Pflichten | Datenschutz, Haftung, Missbrauch: Was ist zu prüfen? | Die Prüfliste ist abgearbeitet oder terminiert. |
| 9. Betrieb | Wer überwacht Qualität und Kosten nach dem Start? | Monitoring und eine verantwortliche Person sind benannt. |
Erfahrungsgemäß wird Feld 5, das Qualitätsmaß, am häufigsten übersprungen, weil es unbequem ist: Es verwandelt „das wird schon gut“ in eine Zahl, die man verfehlen kann. Genau deshalb ist es das wichtigste Feld. Wie Sie eine eigene kleine Testmenge in einer Stunde bauen, zeigt der Beitrag Evals statt Bauchgefühl; woran Sie gute und schlechte Zahlen unterscheiden, steht in Modelle und Agenten richtig evaluieren.
Machbarkeit realistisch prüfen: der Zeithorizont
Ob ein Modell eine Aufgabe „kann“, hängt weniger vom Thema ab als von der Länge der Kette aus Schritten, die fehlerfrei gelingen müssen. Die Forschungsorganisation METR misst das als Zeithorizont: die Länge von Aufgaben, gemessen an der Bearbeitungszeit menschlicher Fachleute, die ein Agent mit einer bestimmten Wahrscheinlichkeit löst. Ihr Befund vom März 2025: Aufgaben, für die Menschen unter vier Minuten brauchen, lösen damalige Frontier-Modelle fast immer; bei Aufgaben über vier Stunden liegt die Erfolgsquote unter zehn Prozent [4]. Die Grenze verschiebt sich schnell, im Schnitt verdoppelte sich der Horizont etwa alle sieben Monate, aber „schnell besser“ ist kein Bauplan für heute.
Daten als Tabelle
| Aufgabenlänge für menschliche Fachleute | Erfolgsquote |
|---|---|
| bis ca. 4 Minuten | 100 % |
| über 4 Stunden | 10 % |
Quelle: METR [4]
Größenordnungen aus der METR-Zeithorizont-Messung vom März 2025 [4]: knapp 100 Prozent Erfolg bei kurzen Aufgaben, unter 10 Prozent bei Aufgaben über vier Stunden Menschenzeit. Software- und Reasoning-Aufgaben, Frontier-Modelle zum Messzeitpunkt.
Die praktische Konsequenz für Feld 4: Schneiden Sie das Feature in Aufgaben, die im zuverlässigen Bereich liegen, und testen Sie mit echten Fällen aus Feld 2, nicht mit erfundenen Demofällen. Zwanzig bis fünfzig Durchläufe genügen für eine erste Pass-Rate, solange Sie wissen, dass kleine Stichproben breite Unsicherheit haben. Liegt die Quote deutlich unter dem, was der Anwendungsfall verträgt, ist das kein Scheitern des Projekts, sondern eine Information: Aufgabe kleiner schneiden, Menschen in die Schleife holen oder das Feature streichen, bevor es teuer wird.
Qualität vor dem Bau messbar machen
Ein Eval ist die Antwort auf Feld 5: eine feste Menge echter Eingaben mit erwarteten Ergebnissen oder Bewertungskriterien, gegen die jede Modell- und Prompt-Version automatisch läuft. Er tut fürs KI-Feature, was der Regressionstest für klassische Software tut, nur dass die Messlatte nicht „läuft oder läuft nicht“ heißt, sondern eine Quote. Googles Regel zwei, erst die Messgrößen zu bauen [1], bedeutet hier: Der Eval existiert vor der ersten Zeile Produktionscode, und die Schwelle („ab 85 Prozent auf unserer Testmenge gehen wir live“) steht vorher fest. Wer die Schwelle nachträglich an die Messung anpasst, misst nicht mehr, sondern dekoriert.
Kosten vom ersten Tag an rechnen
Bei klassischen Features sind die Grenzkosten pro Nutzer klein und sinken mit der Skala. Bei KI-Features zahlt jede Anfrage echte Token-Preise, und ein beliebtes Feature wird zum Kostenrisiko. Feld 7 verlangt deshalb eine Rechnung vor dem Bau: Kosten pro Anfrage, Anfragen pro gelöster Aufgabe, Aufgaben pro Nutzer und Monat, mal Zielnutzerzahl. Die Bausteine dafür liefern drei Beiträge dieser Redaktion: API-Preise vergleichen erklärt Listenpreise, Cache- und Batch-Rabatte und versteckte Posten, Kosten pro gelöster Aufgabe messen führt vom Tokenpreis zur Kennzahl, die Entscheider wirklich brauchen, und KI-Kosten und ROI kalkulieren setzt die Rechnung in den Unternehmenskontext.
Fehlerfälle und Fallbacks zuerst denken
Weil Fehler zum Normalbetrieb gehören, ist Feld 6 keine Fußnote: Was sieht der Nutzer, wenn das Modell unsinnig antwortet, den Dienst verweigert oder gar nicht erreichbar ist? Die Gestaltungsrichtlinien für Mensch-KI-Interaktion aus Microsoft Research, an zwanzig Produkten mit 49 Designern geprüft, verlangen unter anderem, Unsicherheit sichtbar zu machen und ein effizientes Verwerfen und Korrigieren zu ermöglichen [5]. Der Beitrag KI-UX: Vertrauen, Fehlerfälle, Fallbacks vertieft genau diese Muster. Bei hohen Einsätzen gehört ein Human-in-the-Loop in den Entwurf: Das Modell bereitet vor, ein Mensch gibt frei. Der freiwillige KI-Risikorahmen des NIST [3] liefert die Checklisten-Struktur für Feld 8, von Datenflüssen bis Missbrauchsszenarien.
Vom Canvas zum MVP
Das MVP ist die kleinste Version, die Feld 1 wirklich löst: eine Zielgruppe, eine Aufgabe, eine Metrik. Alles, was die Demo schöner macht, ohne die Metrik zu bewegen, bleibt draußen. Zwei Regeln aus den Quellen halten das MVP billig: Erst die einfache Lösung, auch wenn sie nicht glänzt [1], und die Rohrleitung so bauen, dass Modell und Prompt austauschbar bleiben, damit das nächste Modell-Update keine Katastrophe ist [2]. Prompts, Evals und ihre Ergebnisse gehören wie Code in die Versionsverwaltung. Und Feld 9 gilt ab dem ersten echten Nutzer: Ohne Blick auf Qualitäts- und Kostenzahlen fliegt das Feature blind.
Sechs Prüffragen für jeden KI-Feature-Pitch
- Würden wir das Problem auch ohne KI lösen, und was genau gewinnt der Nutzer durch das Modell?
- Liegen fünf echte Beispiel-Ein- und Ausgaben vor, keine erfundenen Demofälle?
- Welche Messgröße und welche Schwelle entscheiden über „gut genug“, und wer hat sie vor dem Bau festgelegt?
- Was kostet eine gelöste Aufgabe bei tausend und bei hunderttausend Nutzern, mit welchen Annahmen?
- Was ist der schlimmste realistische Fehler, und was erlebt der Nutzer in diesem Moment?
- Wer betreut das Feature in sechs Monaten, und woran sieht diese Person, dass Qualität oder Kosten kippen?
Ein Pitch, der alle sechs Fragen beantwortet, muss nicht gebaut werden, aber er darf entschieden werden. Das ist der Unterschied zwischen einem Canvas und einer Begeisterungsrunde: Er macht „nein“ zu einem normalen, billigen Ergebnis, solange ein Nein noch nichts kostet.
Methode
Gelesen wurden am 20. Oktober 2026 Googles „Rules of Machine Learning“ [1], der NeurIPS-Aufsatz zu technischen Schulden in ML-Systemen [2], die NIST-Seite zum AI Risk Management Framework [3], der METR-Bericht zum Zeithorizont [4] und die Beschreibung der 18 Gestaltungsrichtlinien von Microsoft Research [5]. Der Canvas ist eine eigene Zusammenstellung der Redaktion auf dieser Grundlage, kein übernommenes Fremd-Framework.
Grenzen
Der Canvas ersetzt keine Fachprüfung zu Recht und Datenschutz; Feld 8 liefert nur die Prüfstruktur. Die Zeithorizont-Zahlen stammen aus Software- und Reasoning-Aufgaben und übertragen sich nur eingeschränkt auf andere Domänen; METR weist selbst auf Annahmen und Unsicherheit der Trendlinie hin.
Quellen
- Rules of Machine Learning: Best Practices for ML Engineering, Google for Developers (Martin Zinkevich) (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- Hidden Technical Debt in Machine Learning Systems, D. Sculley u. a., NeurIPS 2015 (papers.nips.cc) (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4 ↩5
- AI Risk Management Framework, National Institute of Standards and Technology (NIST) (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4
- Measuring AI Ability to Complete Long Software Tasks, METR (Thomas Kwa, Ben West, Joel Becker u. a., März 2025) (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4 ↩5
- Guidelines for Human-AI Interaction, Amershi u. a., CHI 2019 (Microsoft Research) (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4