 KI
Zwei Modelle, zwei Zahlen: 71 gegen 74 Prozent. Welches ist besser? Die ehrliche Antwort lautet fast immer: Das hängt davon ab, was gemessen wurde, wie oft, womit und ob das Modell die Aufgaben schon kannte. Evaluation ist die Kunst, diese vier Fragen zu stellen, bevor man einer Zahl glaubt.
Diese Seite gibt dir die Werkzeuge dafür: eine Landkarte der Benchmark-Typen, ein Verständnis von Kontamination, den Unterschied zwischen pass@k und pass^k und eine Checkliste für den Alltag. Begriffe wie Benchmark, Evals und Pass-Rate sind im Glossar erklärt.
Benchmark-Typen: Wissen testen ist etwas anderes als Arbeit testen
Ein Benchmark ist eine Prüfung mit festen Aufgaben. Wie bei Schulprüfungen unterscheiden sich die Formate stark. Eine Multiple-Choice-Klausur zeigt, was jemand weiß. Sie zeigt nicht, ob er ein Projekt zu Ende bringt. Bei KI-Modellen ist es genauso. Die zehn Portraits des KI Fachblatts lassen sich grob so einordnen (Einordnung der Redaktion anhand der Portrait-Beschreibungen):
| Typ | Was geprüft wird | Beispiele |
|---|---|---|
| Wissen und Denken | Fragen mit vorgegebenen Antworten, meist aus Fachgebieten | MMLU-Pro, GPQA, Humanity's Last Exam |
| Software | Echte Programmierprobleme lösen, im Terminal arbeiten | SWE-bench Verified, Terminal-Bench 2.1 |
| Web und Computer | Im Netz suchen, echte Programme am Rechner bedienen | BrowseComp, OSWorld |
| Ganze Projekte | Daten vorbereiten, Modelle trainieren, Experimente auswerten | MLE-bench |
| Dialog mit Regeln | Mit einem simulierten Nutzer sprechen und Vorgaben einhalten | τ²-Bench |
| Sicherheit | Eine beschriebene Schwachstelle mit einem Angriffsskript nachstellen | CyberGym |
Daraus folgt eine einfache Regel: Wähle den Benchmark-Typ, der deiner Aufgabe ähnelt. Für einen Support-Bot sagt ein Wissenstest wenig, ein Test wie τ²-Bench mehr. Für einen Coding-Agenten helfen Wissensfragen kaum, Aufgaben aus echten Repositories schon. Und für dein eigenes Produkt zählt am Ende eine eigene Testmenge, wie sie Evals: Testen statt Bauchgefühl beschreibt.
Kontamination: Wenn die Klausur im Lernstoff steckte
Stell dir vor, die Aufgaben der Abschlussprüfung hätten vorher im Lernheft gestanden. Das Ergebnis wäre glänzend und sagte kaum etwas über das Können. Genau das meint Kontamination bei Sprachmodellen: Das Modell hat Informationen aus dem Test schon beim Training aufgenommen, und die Messung wird ungenau [2].
Das Problem ist schwer zu sehen. Trainiert wird auf riesigen Mengen Text, und wo Benchmark-Aufgaben samt Lösungen öffentlich im Netz stehen, können sie ins Trainingsmaterial gelangen. Eine Übersichtsarbeit zu dem Thema beschreibt die Folgen und diskutiert Alternativen zu klassischen, festen Tests [2].
Was dagegen hilft
- Frische Aufgaben: LiveCodeBench sammelt laufend neue Aufgaben aus Programmierwettbewerben. Zum Zeitpunkt der Veröffentlichung umfasste es 400 Aufgaben, die zwischen Mai 2023 und Mai 2024 erschienen sind [3]. Wer ein Modell nur an Aufgaben misst, die nach dessen Trainingsende erschienen, begrenzt das Risiko.
- Eigene, nicht veröffentlichte Tests: Eine Testmenge, die nie im Netz stand, kann nicht im Training gelandet sein.
- Nachsehen, nicht nur glauben: Hersteller-Zahlen sind Herstellerangaben. Unabhängige Messungen und Hinweise auf mögliche Kontamination gehören zur Einordnung dazu.
Streuung: Wie sicher ist die Zahl überhaupt?
Jede Messung hat Rauschen. Bei einem Test mit 100 Aufgaben und 70 gelösten ist der wahre Wert nicht exakt 70 Prozent. Das 95-Prozent-Wilson-Intervall reicht in diesem Fall von etwa 60,4 bis 78,1 Prozent (eigene Rechnung). Bei 1.000 Aufgaben und ebenfalls 70 Prozent schrumpft es auf etwa 67,1 bis 72,8 Prozent. Das ist der Grund, warum zwei Modelle mit 71 und 74 Prozent auf einem kleinen Test oft gar nicht unterscheidbar sind. Mehr dazu unter Konfidenzintervall.
| Aufgaben im Test | Untere Grenze | Obere Grenze |
|---|---|---|
| 50 | 56,2 % | 80,9 % |
| 100 | 60,4 % | 78,1 % |
| 500 | 65,8 % | 73,9 % |
| 1.000 | 67,1 % | 72,8 % |
pass@k und pass^k: Einmal klappen oder immer klappen?
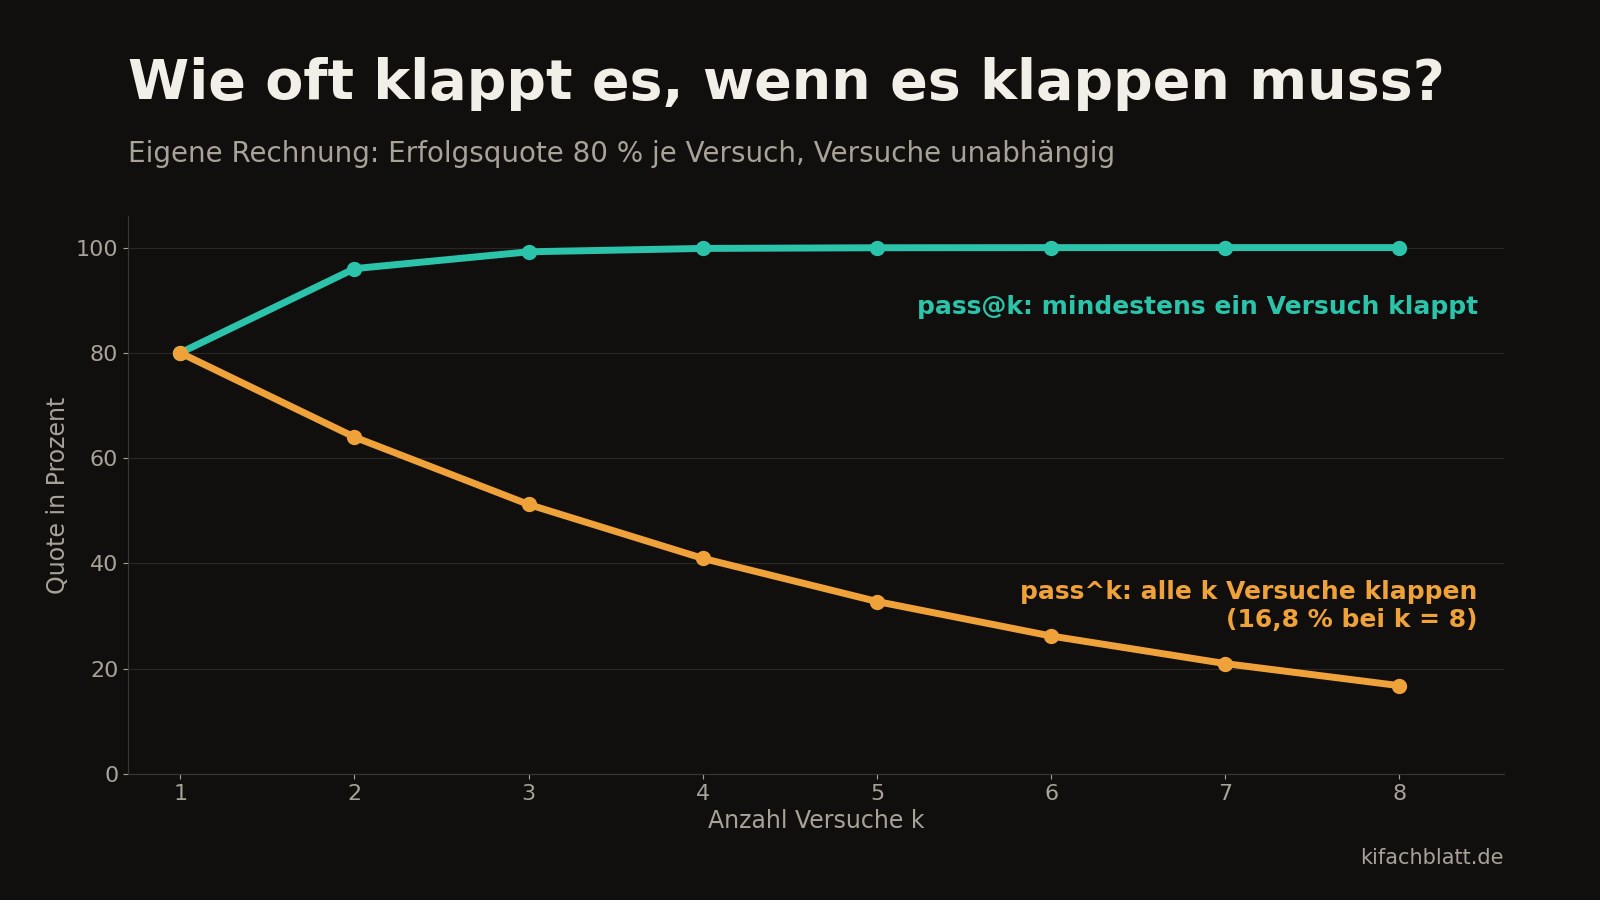
Sprachmodelle antworten nicht jedes Mal gleich. Wer dieselbe Aufgabe mehrfach stellt, bekommt manchmal Erfolg, manchmal nicht. Zwei Kennzahlen beschreiben das, und sie sagen fast das Gegenteil:
- pass@k ist die Chance, dass mindestens einer von k Versuchen gelingt [1]. Das passt, wenn man Lösungen automatisch prüfen kann, etwa mit Unit-Tests, und einfach mehrfach probiert.
- pass^k ist die Chance, dass alle k Versuche gelingen, gemittelt über die Aufgaben [1]. Das passt, wenn jeder einzelne Lauf stimmen muss, zum Beispiel im Kundendienst.
Die Analogie: Ein Basketballspieler trifft 80 Prozent seiner Freiwürfe. Bei einem einzigen Wurf ist das stark. Wenn aber acht Würfe in Folge sitzen müssen, gelingt das bei unabhängigen Würfen nur in 0,8^8 = 16,8 Prozent der Fälle. Bei einem Agenten, der acht Kundenanfragen fehlerfrei bearbeiten soll, gilt dieselbe Mathematik (eigene Rechnung, vereinfacht: gleiche Erfolgsquote bei jedem Versuch).
- pass@k (mindestens einer klappt)
- pass^k (alle klappen)
Daten als Tabelle
| Versuche k | pass@k (mindestens einer klappt) | pass^k (alle klappen) |
|---|---|---|
| 1 | 80 % | 80 % |
| 2 | 96 % | 64 % |
| 4 | 99,84 % | 41 % |
| 8 | 100 % | 16,8 % |
Quelle: Eigene Rechnung nach [1]
Eigene Rechnung mit den Definitionen aus [1]: pass@k = 1 - (1 - p)^k und pass^k = p^k, bei gleicher Erfolgsquote p = 0,8 und unabhängigen Versuchen.
Das ist keine Theorie. Die τ-Bench-Autoren fanden 2024, dass selbst ein starkes Modell (GPT-4o mit Funktionsaufrufen) im Einzelhandels-Szenario bei über 60 Prozent Aufgabenerfolg lag, bei pass^8 aber unter 25 Prozent [1]. Diese Zahlen betreffen ein älteres Modell. Sie zeigen aber das Muster: Hoher Durchschnitt heißt nicht verlässlich. Das aktuelle Folgeprojekt steht im Portrait zu τ²-Bench.
Agenten evaluieren: Der Endzustand zählt
Ein Chatbot wird an seinem Text gemessen, ein Agent an seinen Taten. Hat er die Buchung wirklich geändert? Die Datei wirklich repariert? τ-Bench löst das, indem es nach jedem Gespräch den Zustand der Datenbank mit dem erwarteten Zielzustand vergleicht. Wie der Nutzer die Bitte formuliert, darf variieren, solange das Ergebnis stimmt [1]. Diese Idee lässt sich auf eigene Agenten übertragen: Prüfe, was sich in der Welt verändert hat, und nicht, wie überzeugend die Antwort klingt. Grundlagen zu Agenten findest du unter Was ein KI-Agent wirklich ist, den Agent-Loop im Glossar.
Für Agenten kommen weitere Fragen dazu:
- Was kostet eine gelöste Aufgabe? Ein Agent, der doppelt so oft gewinnt, aber zehnmal so viele Tokens verbrennt, ist nicht automatisch besser. Siehe Kosten pro gelöster Aufgabe.
- Wie lang darf die Aufgabe sein? Manche Tests prüfen kurze Aufträge, andere ganze Projekte, siehe MLE-bench oder Terminal-Bench 2.1. Ein Wert aus kurzen Aufgaben lässt sich nicht auf lange übertragen.
- Welcher Aufbau steckt dahinter? τ-Bench vergleicht Modelle und Methoden [1]. Dasselbe Modell kann mit anderem Prompt oder anderen Werkzeugen anders abschneiden. Vergleiche daher nur Zahlen mit gleichem Aufbau.
- Wurde auch die Sicherheit geprüft? Ob ein Agent Aufgaben löst, ist eine andere Frage als ob er sich austricksen lässt. Dazu siehe Sicherheit für Agenten-Systeme.
Wenn ein Modell das Modell bewertet
Offene Antworten wie Zusammenfassungen lassen sich schwer automatisch prüfen. Deshalb setzen viele ein zweites Modell als Prüfer ein, kurz LLM-as-a-Judge. Die Studie hinter MT-Bench und Chatbot Arena fand, dass starke Prüfmodelle wie GPT-4 mit menschlichen Bewertungen zu über 80 Prozent übereinstimmten, so oft wie Menschen untereinander [4]. Dieselbe Arbeit nennt typische Schwächen: Positionsbias (die erste Antwort wird bevorzugt), Wortreichtum (lange Antworten gewinnen) und Eigenlob (das Modell mag die eigene Modellfamilie) [4]. Praktisch heißt das: Reihenfolge der Antworten mischen, Kriterien vorgeben und regelmäßig Stichproben selbst lesen.
Checkliste: Eine Benchmark-Zahl lesen
- Welcher Typ? Passt die Art der Aufgaben zu meiner Aufgabe?
- Wer hat gemessen? Hersteller, unabhängige Stelle oder ich selbst?
- Wie viele Aufgaben und wie oft? Gibt es ein Intervall oder mehrere Läufe?
- Kontamination möglich? Stammen die Aufgaben aus der Zeit vor dem Modelltraining?
- Welcher Aufbau? Gleicher Prompt, gleiche Werkzeuge, gleiche Versuchszahl bei allen Modellen?
- Pass@k oder pass^k? Reicht ein Erfolg, oder muss es jedes Mal klappen?
- Was kostet es? Zeit, Tokens, Geld pro gelöster Aufgabe.
Wie diese Seite in einen größeren Weg passt, zeigen die Lernpfade für Einsteiger, Praktiker und Entscheider.
Methode
Gelesen wurden am 20. Oktober 2026 die arXiv-Seiten der vier genannten Arbeiten, beim τ-bench-Paper einschließlich des Volltexts mit Definition von pass^k und den Ergebnissen. Die Einordnung der zehn Benchmarks in Typen beruht auf den Beschreibungen in den Portraits des KI Fachblatts. Die Rechnungen zu pass^k und zum Wilson-Intervall stammen von der Redaktion (Wilson-Score, z = 1,96).
Grenzen
Die τ-bench-Zahlen betreffen Modelle von 2024 und sind nicht auf aktuelle Modelle übertragbar. Die pass^k-Rechnung nimmt gleiche Erfolgsquote und unabhängige Versuche an; reale Aufgaben sind unterschiedlich schwer. Ob einzelne aktuelle Modelle kontaminiert sind, wurde nicht untersucht. Die Angaben zu LLM-as-a-Judge stammen aus einer Studie von 2023 mit damaligen Modellen.
Quellen
- τ-bench: A Benchmark for Tool-Agent-User Interaction in Real-World Domains, arXiv:2406.12045 (Yao u. a., Sierra) (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- Benchmark Data Contamination of Large Language Models: A Survey, arXiv:2406.04244 (Xu u. a.) (abgerufen 2026-10-20) ↩1 ↩2 ↩3
- LiveCodeBench: Holistic and Contamination Free Evaluation of Large Language Models for Code, arXiv:2403.07974 (Jain u. a.) (abgerufen 2026-10-20) ↩1 ↩2
- Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena, arXiv:2306.05685 (Zheng u. a., NeurIPS 2023) (abgerufen 2026-10-20) ↩1 ↩2 ↩3