 KI
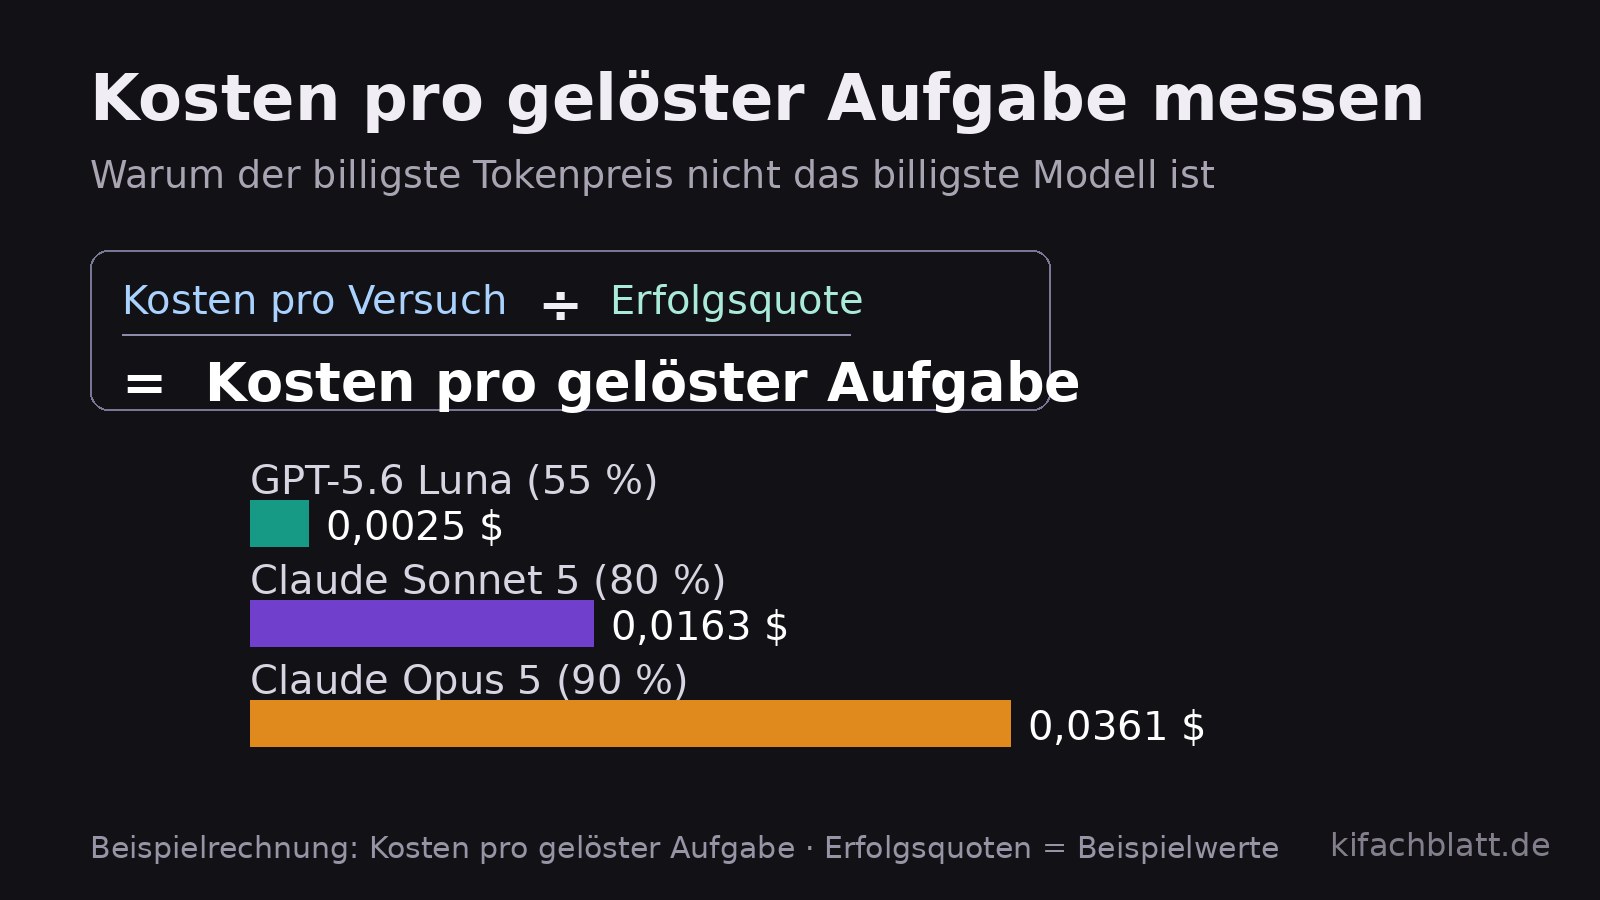
Modell A kostet einen Dollar je Million Token, Modell B das Zehnfache. Welches ist billiger? Die Preisliste beantwortet die Frage nicht. Wenn A die Aufgabe in vier von zehn Fällen löst und B in neun von zehn, zahlen Sie bei A für viele Fehlversuche und bei B fast nie. Die Kennzahl, die Entscheider wirklich brauchen, sind die Kosten pro gelöster Aufgabe. Dieser Beitrag zeigt in vier Schritten, wie Sie sie für Ihren eigenen Anwendungsfall messen, mit echten Preisen vom 20. Oktober 2026 und einer durchgerechneten Beispielrechnung.
Die Formel
Kosten pro gelöster Aufgabe = Gesamtkosten eines Laufs geteilt durch gelöste Aufgaben. Wenn Sie nur Daten pro Versuch haben, gilt die Umformung: Kosten pro Versuch geteilt durch Erfolgsquote. Scheitert ein Modell bei der Hälfte der Aufgaben, verdoppelt das seinen effektiven Preis. Genau so arbeitet die Vergleichsseite Artificial Analysis: Ihre „Cost per Task“ berechnet sich aus den Preisen für Eingabe-, Cache-Hit-, Cache-Write-, Reasoning- und Antwort-Token, geteilt durch die Zahl der Aufgaben im Test [1]. Die Methode ist öffentlich einsehbar und eine gute Vorlage für die eigene Rechnung.
Schritt 1: Aufgabe und „gelöst“ definieren
Bevor irgendetwas gemessen wird, steht die Definition: Was ist eine Aufgabe, und wann gilt sie als gelöst? „Das Ticket ist gelöst, wenn die Antwort die Kundenfrage fachlich richtig beantwortet und kein Mensch nachfassen muss“ ist eine Regel. „Die Antwort sieht gut aus“ ist keine. Diese Regel ist zugleich Ihr Eval: eine feste Menge echter Fälle mit festem Bewertungsverfahren. Wie Sie so eine Testmenge in einer Stunde bauen, zeigt Evals statt Bauchgefühl. Wer Schritt 1 überspringt, misst später Zahlen ohne Bedeutung, denn „gelöst“ wird dann nachträglich so gebogen, dass das Lieblingsmodell gewinnt.
Schritt 2: Token pro Versuch messen, nicht schätzen
Ein Versuch besteht selten aus einem einzigen API-Aufruf. Agenten planen, rufen Werkzeuge, lesen Ergebnisse und antworten erst dann; jeder dieser Schritte verbraucht Token. Zählen Sie die usage-Felder der API-Antworten über den ganzen Versuch, nicht nur den letzten. Drei Posten werden dabei regelmäßig unterschätzt: Denk-Token, die bei Reasoning-Modellen als Ausgabe abgerechnet werden (Google weist sie ausdrücklich als Teil des Ausgabepreises aus) [3], der Werkzeug-Overhead, den Anthropic je nach Modell mit rund 300 bis 800 zusätzlichen Eingabetoken pro Anfrage beziffert [2], und Tokenizer-Effekte: Neuere Tokenizer bei Claude ab Version 4.7 erzeugen laut Anthropic rund 30 Prozent mehr Token für denselben Text [2]. Wer mit alten Schätzwerten kalkuliert, wundert sich über die Rechnung.
Schritt 3: Erfolgsquote sauber messen
Die Erfolgsquote (Pass-Rate) ist der empfindliche Teil der Formel: Sie steht im Nenner. Drei Regeln halten sie ehrlich. Erstens echte Fälle aus dem Betrieb, nicht aus der Demo. Zweitens genug Fälle: Bei 20 Versuchen trennt eine Quote von 80 Prozent nicht sauber zwischen 60 und 95; die Breite dieser Unsicherheit zeigt das Konfidenzintervall, siehe Modelle und Agenten richtig evaluieren. Drittens realistische Bedingungen: Die Erfolgsquote hängt stark von der Aufgabenlänge ab. Die Zeithorizont-Messung von METR fand für Frontier-Modelle fast sichere Erfolge bei Minuten-Aufgaben und unter zehn Prozent bei Aufgaben über vier Stunden Menschenzeit [4]. Eine Quote ohne Angabe der Aufgabenart ist keine Zahl, sondern Werbung.
Schritt 4: Rechnen und vergleichen, ein Beispiel
Wir setzen die Ticket-Rechnung aus API-Preise vergleichen fort. Annahmen wie dort: 3.000 Eingabe- und 700 Ausgabetoken pro Versuch, Standardpreise vom 20. Oktober 2026 [2] [3]. Die Erfolgsquoten sind Beispielwerte der Redaktion, keine Messung; sie zeigen nur das Rechenmuster. Kosten pro gelöster Aufgabe = Kosten pro Versuch geteilt durch Erfolgsquote.
| Modell | Kosten pro Versuch | Erfolgsquote (Beispiel) | Kosten pro gelöster Aufgabe |
|---|---|---|---|
| GPT-5.6 Luna | 0,0014 $ | 55 % | 0,0025 $ |
| Claude Sonnet 5 | 0,0130 $ | 80 % | 0,0163 $ |
| Claude Opus 5 | 0,0325 $ | 90 % | 0,0361 $ |
- pro Versuch
- pro gelöster Aufgabe
Daten als Tabelle
| Modell | pro Versuch | pro gelöster Aufgabe |
|---|---|---|
| GPT-5.6 Luna | 0 $ | 0 $ |
| Claude Sonnet 5 | 0,01 $ | 0,02 $ |
| Claude Opus 5 | 0,03 $ | 0,04 $ |
Quelle: Eigene Rechnung, Beispielwerte
Eigene Beispielrechnung: Kosten pro Versuch (hell) und pro gelöster Aufgabe (voll). Erfolgsquoten 55/80/90 % sind Beispielwerte, Preise von [2] (20.10.2026).
In diesem Beispiel ändert die Erfolgsquote die Rangfolge nicht, aber sie verändert die Abstände: Lunas Vorsprung schmilzt von Faktor 9 auf Faktor 6,5 gegenüber Sonnet 5. Und sie zeigt die zweite Rechnung, die Entscheider interessiert: die Grenzkosten der Qualität. Der Wechsel von Sonnet 5 auf Opus 5 kostet hier rund zwei Cent mehr pro gelöster Aufgabe und kauft zehn Prozentpunkte Erfolgsquote. Ob das die Nachkontrolle der Restfälle aufwiegt, ist eine betriebswirtschaftliche Frage, keine technische. Unsere LHTB-2-Analyse rechnet genau diese Grenzkosten-Logik für Agenten-Benchmarks mit echten Messwerten durch.
Typische Messfehler
- Zu kleine Stichprobe. Zwanzig Versuche trennen keine Modelle; unter etwa 50 Fällen sind Quoten nur Anhaltspunkte, und selbst dann gehört das Konfidenzintervall dazu.
- Denk-Token vergessen. Reasoning-Modelle erzeugen unsichtbare Ausgabetoken. Wer nur die sichtbare Antwort zählt, unterschätzt den teuren Posten.
- Retry-Kaskaden ignoriert. Agenten versuchen Schritte intern erneut. Zählt man nur den finalen Aufruf, fehlen die teuersten Teile des Laufs.
- Unechte Testfälle. Demo-Fälle sind sauberer als Betrieb. Die Quote aus der Demo ist die Obergrenze, nicht der Erwartungswert.
- Vergleich ohne Stand-Datum. Preise und Tokenizer ändern sich; eine Kennzahl vom Vorquartal ist eine andere Kennzahl.
- Qualitätsschwelle vergessen. „Gelöst“ ohne Mindestqualität optimiert auf billig und falsch; erst die Schwelle macht die Kennzahl sicher.
Checkliste für die eigenen vier Schritte
- Aufgabe und „gelöst“-Regel schriftlich festgelegt, bevor gemessen wird?
- Testmenge aus echten Fällen, groß genug für ein brauchbares Konfidenzintervall?
- Tokenzählung über alle API-Aufrufe eines Versuchs, inklusive Denk- und Werkzeug-Token?
- Erfolgsquote mit Bedingungen dokumentiert (Aufgabenart, Modellversion, Stand-Datum)?
- Kosten pro gelöster Aufgabe und Grenzkosten je Modell verglichen, nicht nur Tokenpreise?
- Monitoring im Betrieb eingerichtet, damit die Kennzahl nach dem Start nicht veraltet? Dazu: LLM-Betrieb überwachen.
Mit dieser Kennzahl wird aus der Preislisten-Debatte eine Entscheidungsvorlage: Sie können Angebote normieren, Modellwechsel begründen und Budgets gegenrechnen. Wie die Rechnung in eine ROI-Betrachtung mit Personalkosten und Zeitgewinn mündet, zeigt KI-Kosten und ROI kalkulieren.
Methode
Gelesen wurden am 20. Oktober 2026 die Methodik- und Preisangaben von Artificial Analysis [1], die Preisdokumentation von Anthropic [2] und Google [3] sowie der METR-Bericht zum Zeithorizont [4]. Die Tokenkosten pro Versuch stammen aus den dort genannten Listenpreisen; die Erfolgsquoten in Tabelle und Grafik sind ausdrücklich Beispielwerte der Redaktion zur Demonstration des Rechenwegs, keine Messung.
Grenzen
Die Beispiel-Quoten sind keine Modellbewertung; reale Quoten hängen von Aufgabe, Prompt und Daten ab. Preise in US-Dollar ohne Steuern, Stand 20. Oktober 2026. Die Kennzahl ersetzt keine Qualitätsbeurteilung: Wer nur Kosten pro gelöster Aufgabe minimiert, kann auf „billig und knapp ausreichend“ optimieren; die Qualitätsschwelle aus Schritt 1 ist Teil der Messung, kein Zusatz.
Quellen
- Comparison of AI Models across Intelligence, Performance, and Price (Cost-per-Task-Methodik), Artificial Analysis (abgerufen 2026-10-20) ↩1 ↩2
- Pricing (Modellpreise, Werkzeug-Overhead, Tokenizer-Hinweis, Rechenbeispiele), Claude Docs / Anthropic (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- Gemini Developer API pricing (Ausgabepreise inklusive Denk-Token), Google AI for Developers (abgerufen 2026-10-20) ↩1 ↩2 ↩3
- Measuring AI Ability to Complete Long Software Tasks, METR (Thomas Kwa, Ben West, Joel Becker u. a., März 2025) (abgerufen 2026-10-20) ↩1 ↩2