 KI
Long-Horizon-Terminal-Bench 2.0 (LHTB 2.0) umfasst 77 Terminalaufgaben mit bis zu drei Stunden Laufzeit und prüft den Fortschritt alle 30 Minuten. Laut dem Preprint löst das stärkste von 15 Modellen 37 Aufgaben (48,1 Prozent) mit mindestens 95 Prozent der Punkte, aber zu geschätzten Kosten von rund 397 Dollar pro Aufgabe. Die Autoren zeigen drei Dinge: Ein reines Bestanden/Durchgefallen-Urteil übersieht viel Fortschritt, 42 Prozent aller Lösungen entstehen erst nach der ersten Stunde, und schnelle Modelle melden den Abschluss oft zu früh.
Warum ein weiterer Benchmark?
Agenten sollen Aufgaben erledigen, die nicht in einer Antwort Platz haben: Experimente reproduzieren, kaputte Analysepipelines reparieren, Systeme optimieren. Die meisten Tests bewerten das Ergebnis am Ende mit „bestanden“ oder „nicht bestanden“. Das hat zwei Schwächen, die das Paper von Li et al. benennt: Man erfährt nicht, ob der Agent Fortschritte gemacht, sich festgefahren oder Arbeit überschrieben hat. Und lange Aufgaben von Hand zu bauen ist teuer [1].
LHTB 2.0 ist die Erweiterung eines früheren Benchmarks mit 46 Aufgaben. Sie behält diese 46, behebt Fehler in Aufgaben und Prüfumgebung und ergänzt 31 weitere. Dazu kommen drei Änderungen an der Messung: Jeder Lauf darf bis zu drei Stunden dauern (vorher 90 Minuten), der Prüfer läuft alle 30 Minuten, und statt eines Endurteils gibt es eine abgestufte Punktzahl [1].
Aufbau: Aufgaben, Prüfung, Punkte
Aufgabenformat
Jede Aufgabe besteht aus einer Anweisung in natürlicher Sprache, einer Container-Umgebung mit Terminal, einer Konfiguration und einem deterministischen Prüfer oder Simulator. Der Agent sieht nur die Anweisung. Alles Weitere muss er über das Terminal erkunden, bis er fertig ist oder das Zeitbudget endet [1]. Das Format folgt Terminal-Bench und dem Harbor-Framework; als Agentenhülle dient Terminus-2 [1].
Zwei Aufgabenfamilien
Die 77 Aufgaben teilen sich in zwei Gruppen. Die freigegebenen Workflows (in der Auswertung 47 Aufgaben: die 46 ursprünglichen und eine zusätzliche Optimierungsaufgabe) decken Audit und Reparatur, Optimierung, Spiele, Experiment-Reproduktion, Logikrätsel, Berufsabläufe und Engineering ab. Die Rekonstruktionsaufgaben (30) sind neu und werden halbautomatisch erzeugt [1].
Zur Einordnung: Abschnitt 2.2 des Papers nennt die Gruppen „46“ und „31 Aufgaben“, die Ergebnisabschnitte und die Typentabelle rechnen mit 47 und 30. Der Text erklärt die Differenz mit der einen zusätzlichen Optimierungsaufgabe. Die Summe von 77 stimmt in beiden Fällen.
Wie Rekonstruktionsaufgaben entstehen
Ausgangspunkt ist ein funktionierendes wissenschaftliches oder technisches Programm, etwa zur Registrierung von LiDAR-Punktwolken, zu chemischen Reaktionsvorlagen oder zur Raumakustik. Eine parametrisierte Referenzimplementierung erzeugt viele Szenarien. Sechs davon sieht der Agent als Verhaltensbeleg, drei bleiben für die Bewertung verborgen. Der Agent soll das Verhalten nachbauen, ohne die Referenz zu kennen, und wird an den verborgenen Fällen gemessen [1]. So lässt sich nicht einfach auswendig lernen, was öffentlich sichtbar ist.
Qualitätssicherung
Drei Bedingungen gelten laut Paper für jede Aufgabe: Die Referenzlösung läuft reproduzierbar und erreicht auf allen verborgenen Fällen die volle Punktzahl, das Startmaterial ist unvollständig genug, damit echte Arbeit nötig ist, und ein Sprachmodell (DeepSeek-V4-Pro) prüft, ob Anweisung und Prüfer zusammenpassen [1]. Das ist praktisch, bringt aber eine Abhängigkeit mit: DeepSeek V4 Pro gehört selbst zu den bewerteten Modellen. Ob das Ergebnisse beeinflusst, untersucht das Paper nach unserer Lektüre nicht.
Härtung der Auswertung
Die Autoren korrigierten drei Fehler in Harness und Konfiguration, trennten die Prüfphasen vom laufenden Agentenprozess, löschten Prüfprotokolle vor dem Fortsetzen und prüften erfolgreiche Läufe darauf, ob der Agent an verborgene Testdaten kam. Nur saubere Läufe zählen [1]. Das ist für Agenten-Benchmarks keine Selbstverständlichkeit, weil Agenten mit Terminalzugriff Prüfartefakte finden können.
Einordnung: Terminal-Bench, Zeithorizonte und was hier neu ist
LHTB steht auf dem Terminal-Bench. Terminal-Bench 2.0 (Merrill et al.) besteht aus 89 Aufgaben in Terminalumgebungen, jede mit eigener Umgebung, menschlich geschriebener Lösung und Tests; laut Abstract erreichen Spitzenmodelle und -agenten dort weniger als 65 Prozent [4]. Das zugehörige Harbor-Paket führt Tests in Containern aus und lässt sich horizontal skalieren [5].
Der erste LHTB (46 Aufgaben, neun Kategorien) setzte auf fein abgestufte Teilaufgaben mit Teilpunkten und ein Budget von 90 Minuten [2]. Die Projektseite nennt dafür 18 getestete Modelle, das Abstract des arXiv-Eintrags 17 [2][3]; das Paper zu Version 2.0 nennt diese Differenz nicht. Neu in 2.0 ist vor allem die Kombination aus halbautomatischer Aufgabenerzeugung, drei Stunden Laufzeit und Prüfpunkten im 30-Minuten-Takt.
Ein anderer Ansatz zur Frage „wie lange können Agenten arbeiten?“ stammt von METR. Dort wird der 50-Prozent-Zeithorizont bestimmt: die Dauer, die Menschen typisch für Aufgaben brauchen, die ein Modell mit 50 Prozent Erfolg löst. Für Claude 3.7 Sonnet lag er laut der Arbeit bei rund 50 Minuten, und er habe sich seit 2019 etwa alle sieben Monate verdoppelt; die Autoren diskutieren selbst Grenzen der Übertragbarkeit [6]. Der Unterschied zu LHTB ist grundsätzlich: METR misst, wie lang die menschliche Bearbeitungszeit der lösbaren Aufgaben ist, LHTB misst, was ein Agent in seinem Zeitbudget schafft. Die Zahlen lassen sich deshalb nicht ineinander umrechnen.
Die Hauptergebnisse
Getestet wurden 15 Modelle bei höchster Denkstufe („xhigh“), mit drei Stunden Zeitlimit „aus Kostengründen“. Das Paper meldet 1.145 gewertete Modell-Aufgaben-Läufe [1]. Die Rangliste auf Basis der dichten Punktzahl mit Schwelle R ≥ 0,95:
| Modell (Bezeichnung laut Paper) | Gelöst | Anteil |
|---|---|---|
| GPT-6-astra | 37 | 48,1 % |
| GPT-5.6-sol | 32 | 41,6 % |
| Kimi K3 | 17 | 22,1 % |
| Hunyuan hy4 / Gemini 3.8 Flash | je 15 | je 19,5 % |
| GLM-5.3 | 12 | 15,6 % |
Die mittlere dichte Punktzahl liegt bei GPT-6-astra bei 0,69 und bei GPT-5.6-sol bei 0,67 [1]. Insgesamt bestehen nur 192 der 1.145 Läufe (16,8 %) [1]. Die Autoren schließen daraus, dass Langzeitausführung auch für Spitzenmodelle ein zentraler Engpass bleibt.
Der Vorsprung stammt fast vollständig aus einer Teilmenge. Auf den 30 Rekonstruktionsaufgaben erreicht GPT-6-astra 0,93 und löst 24 Aufgaben, GPT-5.6-sol kommt auf 0,84 und 18. Auf den 47 freigegebenen Workflows liegt GPT-5.6-sol knapp vorn (0,57 gegen 0,54) [1]. Wer aus der Gesamtrangliste auf „bestes Modell für alles“ schließt, liest mehr heraus, als die Daten tragen.
Nach Veröffentlichungsdatum geordnet: Das Paper beobachtet, dass offene Modelle grob mit dem Erscheinungsdatum besser werden, etwa Kimi K3 (16. Juli 2026) gegenüber Kimi K2.6 (20. April 2026) [1]. Das ist eine Beobachtung über wenige Modellpaare, kein Gesetz.
Daten als Tabelle
| Mittlere Punktzahl | |
|---|---|
| binär | 0,22 |
| dicht | 0,65 |
Quelle: Li et al., LHTB 2.0, Abstract und Abschnitt 1 [1]
Mittlere Punktzahl auf den 30 Rekonstruktionsaufgaben.
Wo Agenten scheitern
Systeme, Performance und Sicherheit sind die zugänglichste Kategorie (Mittelwert über alle Modelle 0,73). Jede Software- und Reverse-Engineering-Aufgabe wird von mindestens einem Modell gelöst; die am häufigsten gelöste Aufgabe, `riscv-core-debug`, schaffen 13 von 15 Modellen. Am schwersten sind wissenschaftliches Rechnen und Simulation (0,30) sowie multimodale Bildanalyse (0,31) [1].
24 Aufgaben löst kein Modell, 20 davon stammen aus den freigegebenen Workflows, 12 sind Audit-und-Reparatur-Aufgaben. Bei neun Aufgaben kommt kein Modell über 0,2, acht davon sind Audit und Reparatur. Das Paper folgert, die Schwierigkeit liege im ausdauernden Debuggen und Reparieren, nicht in einem fehlenden letzten Schritt [1].
Interessant ist die Analyse der Kommandos aus 1.135 Läufen mit vollständigem Verlauf. Zwei verschiedene Modelle teilen auf derselben Aufgabe im Schnitt nur 3 Prozent der exakten Befehle. Läufe mit mehr Dateibearbeitung erzielen tendenziell mehr Punkte, lange Wiederholungsschleifen tendenziell weniger. Unter den 800 Läufen, die auch nach drei Stunden scheitern, trennen diese Kennzahlen aber nicht gute von schlechten Fehlschlägen [1]. Es sind Korrelationen; ob mehr Bearbeitung zu Erfolg führt oder erfolgreiche Läufe einfach mehr bearbeiten, lässt sich daraus nicht ablesen.
Wie belastbar sind die Platzierungen? (eigene Rechnung)
Eine Rangliste aus 77 Aufgaben hat eine Stichprobengröße, die man ausrechnen kann. Wir haben für die sechs Modelle, deren Lösungszahl das Paper nennt, 95-Prozent-Konfidenzintervalle nach Wilson berechnet [1]. Das Ergebnis ist deutlicher, als die Rangfolge vermuten lässt:
| Modell | Gelöst | Anteil | Intervall |
|---|---|---|---|
| GPT-6-astra | 37 | 48,1 % | 37,3 bis 59,0 % |
| GPT-5.6-sol | 32 | 41,6 % | 31,2 bis 52,7 % |
| Kimi K3 | 17 | 22,1 % | 14,3 bis 32,5 % |
| Hunyuan hy4 | 15 | 19,5 % | 12,2 bis 29,7 % |
| Gemini 3.8 Flash | 15 | 19,5 % | 12,2 bis 29,7 % |
| GLM-5.3 | 12 | 15,6 % | 9,1 bis 25,3 % |
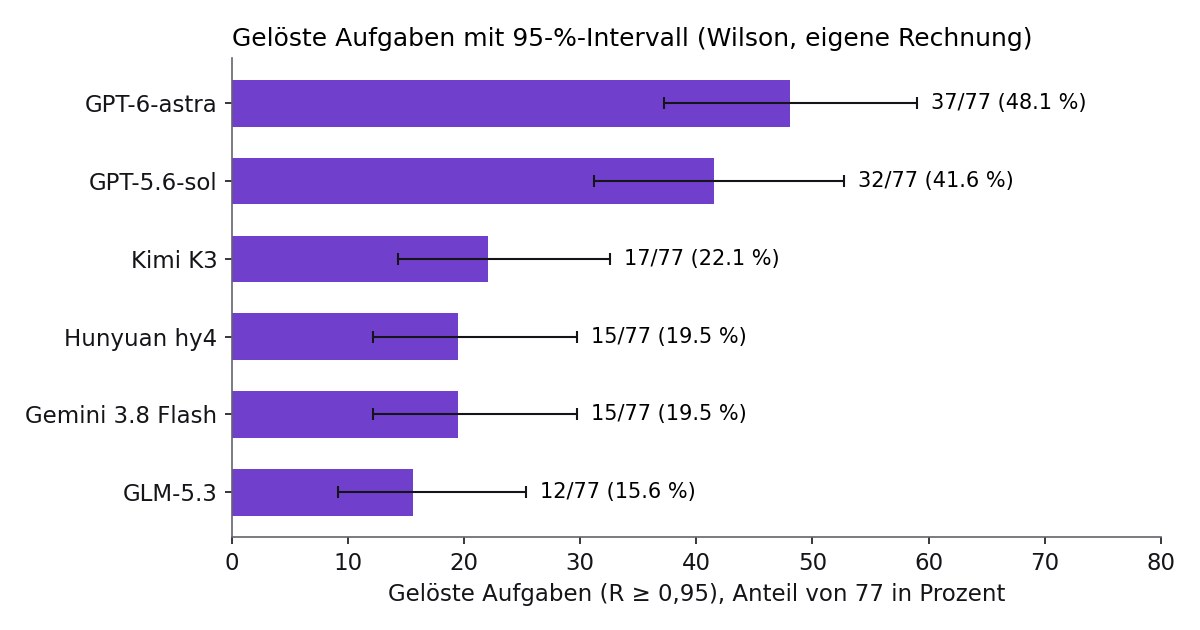
Die Intervalle von GPT-6-astra (37,3 bis 59,0 Prozent) und GPT-5.6-sol (31,2 bis 52,7 Prozent) überlappen auf großer Breite. Der Abstand von fünf Aufgaben liegt allein durch die Auswahl der 77 Aufgaben im Bereich des Zufalls. Beide Spitzenmodelle heben sich dagegen von der Mitte ab; die obere Grenze von Kimi K3 (32,5 Prozent) liegt aber knapp über der unteren von GPT-5.6-sol (31,2 Prozent). Zwischen Kimi K3, Hunyuan hy4, Gemini 3.8 Flash und GLM-5.3 trennt die Zählung praktisch nichts: Die Intervalle liegen fast vollständig übereinander.
Zwei Einschränkungen. Erstens behandelt das Wilson-Intervall die Aufgaben als zufällige Stichprobe aus allen denkbaren Aufgaben. Da alle Modelle dieselben 77 Aufgaben lösen, wäre ein gepaarter Vergleich schärfer, doch dafür bräuchte man die Ergebnisse je Aufgabe, die wir im gelesenen Text nicht gefunden haben. Zweitens enthält das Intervall keine Streuung zwischen wiederholten Läufen desselben Modells, weil das Paper nach unserer Lektüre nicht angibt, ob und wie oft wiederholt wurde. Die tatsächliche Unsicherheit ist also eher größer als hier dargestellt, nicht kleiner.
Zeit: Warum drei Stunden das Ranking verändern
Weil der Prüfer alle 30 Minuten läuft, lässt sich der Fortschritt innerhalb eines Laufs verfolgen. Die Autoren zählen eine Aufgabe als gelöst, sobald ein Prüfpunkt R ≥ 0,95 zeigt. Das ergibt 189 Lösungen in 1.143 Läufen [1].
- Die mittlere erfolgreiche Lösung dauert 57 Minuten. 42 % aller Lösungen entstehen nach der ersten Stunde, 21 % nach der zweiten.
- Die Spitze stabilisiert sich früh: GPT-6-astra löst 27 Aufgaben innerhalb von 30 Minuten und 34 seiner 36 gelösten innerhalb einer Stunde, Median 24 Minuten.
- Die Mitte nicht: Hunyuan hy4 (Median 121 Minuten) und DeepSeek V4 Pro (141 Minuten) lösen spät. Bei einem Stundenbudget läge hy4 auf Platz 9 statt 4, DeepSeek V4 Pro auf 13 statt 8.
- Die mittlere Punktzahl über alle Läufe steigt von 0,29 nach 30 Minuten auf 0,43 am Ende. 267 von 693 Läufen gewinnen nach 30 Minuten mehr als 0,05 hinzu, 60 überschreiten die Schwelle erst danach.
Die Praxisfolge: Ein Test mit kurzem Zeitbudget ist nicht einfach eine schnellere Version desselben Tests. Er misst teilweise etwas anderes, nämlich Tempo. Wie Tempo und Ausdauer zusammenhängen, hängt außerdem von der Latenz pro Schritt ab: Sie reicht von 23 Sekunden (MiniMax M3) bis 141 Sekunden (Hunyuan hy4), und je nach Modell warten Agenten 48 bis 76 Prozent der Laufzeit auf das Modell. hy4 braucht mit median 58 Schritten weniger Schritte als GPT-5.6-sol (68), schafft im Zeitrahmen aber weniger als 80 [1]. Wer pro Schritt langsam ist, verliert bei festem Zeitbudget, nicht unbedingt bei festem Schrittbudget.
Daten als Tabelle
| Minuten | |
|---|---|
| GPT-6-astra | 24 Min. |
| alle Modelle | 57 Min. |
| Hunyuan hy4 | 121 Min. |
| DeepSeek V4 Pro | 141 Min. |
Quelle: Li et al., LHTB 2.0, Abschnitt 4.3 [1]
Mediane Lösungszeit in Minuten.
Rückschritte
65 Läufe enden mehr als 0,05 unter ihrem 30- oder 60-Minuten-Stand; 54 davon erst am Zeitlimit. Sie konzentrieren sich auf Spiele und Rätsel, wo spätere Aktionen den Zustand zerstören können. Die Autoren sehen Rückschritt nicht als dominantes Muster [1].
Voreilige Fertigmeldungen
Der Harness prüft jede Abschlussmeldung des Agenten und setzt den Lauf bei Misserfolg fort. Dadurch ist messbar, wie oft ein Agent „fertig“ sagt. Die schnellen Spitzenmodelle melden erstmals nach median 7 (GPT-6-astra) bzw. 8 Minuten (GPT-5.6-sol) Abschluss und tun das in nicht gelösten Läufen im Schnitt 24- bzw. 17-mal; MiniMax M3 58-mal. Langsamere Modelle wie Hunyuan hy4, GLM-5.3, Grok-4.6 und DeepSeek V4 Pro warten oft 1,5 bis 2,5 Stunden und melden nur 3 bis 14-mal. Insgesamt fallen 92 Prozent aller Abschlussmeldungen in Läufe, die nie die Prüfung bestehen [1].
Für den Alltag heißt das: Die Selbstauskunft eines Agenten ist ein schwaches Signal. Ein unabhängiger Prüfer, der den Lauf bei falscher Fertigmeldung fortsetzt, war in diesem Aufbau Teil der Methode, nicht Zubehör.
Kosten: der Preis der Spitze
Die Kosten sind aus Tokenverbrauch und öffentlichen Listenpreisen geschätzt, nicht abgerechnet [1]. Im Schnitt entstehen 27,3 Millionen Tokens, 262,5 Modellaufrufe und 94,3 Minuten Modellzeit je Aufgabe, bei 48,41 Dollar. Die Spreizung ist groß:
| Modell | Kosten je Aufgabe [1] | Geschätzt für 77 Aufgaben | Pro gelöster Aufgabe (eigene Rechnung) |
|---|---|---|---|
| Hunyuan hy4 | 3,71 $ | ca. 286 $ | ca. 19 $ |
| GLM-5.3 | 18,83 $ | ca. 1.450 $ | ca. 121 $ |
| Kimi K3 | 32,09 $ | ca. 2.471 $ | ca. 145 $ |
| GPT-5.6-sol | 67,60 $ | ca. 5.205 $ | ca. 163 $ |
| GPT-6-astra | 397,16 $ | ca. 30.581 $ | ca. 826 $ |
Die letzte Spalte haben wir selbst gebildet: Gesamtkosten (Kosten je Aufgabe mal 77) geteilt durch die Zahl der Aufgaben mit R ≥ 0,95. Sie ist eine grobe Größenordnung, weil die Kosten geschätzt sind und Fehlversuche die Rechnung dominieren. Sie zeigt aber, warum die Autoren GPT-5.6-sol mit etwa einem Sechstel der Kosten als „zweite Stufe“ der Pareto-Grenze beschreiben [1]. Die Preise stammen laut Paper aus „nächstliegenden Listungen“, wo kein genauer Treffer existierte.
Kosten genauer: Preis je Token, nicht nur Verbrauch (eigene Rechnung)
Die Kostenspalte in Tabelle 2 des Papers lässt sich in zwei Faktoren zerlegen: wie viele Token ein Modell je Aufgabe verbraucht und was ein Token im Mittel kostet [1]. Teilt man die geschätzten Kosten je Aufgabe durch den Verbrauch in Millionen Token, ergibt sich ein Mischpreis, der Eingabe- und Ausgabetoken zusammenfasst. Er ist nur so genau wie die Kostenschätzung des Papers, zeigt aber die Größenordnungen.
Daten als Tabelle
| US-Dollar je Mio. Token | |
|---|---|
| GPT-6-astra | 10,08 $ |
| Gemini 3.1 Pro | 2,48 $ |
| Grok-4.6 | 2,02 $ |
| GPT-5.6-sol | 2,02 $ |
| Qwen 3.8 Max | 2,01 $ |
| Kimi K3 | 1,98 $ |
| Kimi K2.6 | 0,96 $ |
| GLM-5.3 | 0,92 $ |
| Hunyuan hy4 | 0,84 $ |
| Gemini 3.8 Flash | 0,77 $ |
| DeepSeek V4 Pro | 0,58 $ |
| GLM-5.2 | 0,55 $ |
| Doubao Seed 2.1 Pro | 0,51 $ |
| MiniMax M3 | 0,3 $ |
| DeepSeek V4 Flash | 0,22 $ |
Quelle: Eigene Rechnung nach Tabelle 2 in [1]; Kosten sind Schätzungen aus Listenpreisen
Eigene Rechnung: geschätzte Kosten je Aufgabe geteilt durch Token je Aufgabe.
GPT-6-astra verbraucht mit 39,4 Millionen Token je Aufgabe etwa 18 Prozent mehr als GPT-5.6-sol (33,5 Millionen), kostet aber das 5,9-Fache (397,16 gegen 67,60 Dollar). Der Mischpreis liegt bei rund 10,08 gegen 2,02 Dollar je Million Token, also beim Fünffachen. Der Kostenabstand zwischen den beiden Spitzenmodellen kommt damit zum größten Teil vom Preis je Token, nicht vom Verbrauch. Unter den anderen Modellen liegen Grok-4.6, GPT-5.6-sol, Qwen 3.8 Max und Kimi K3 bei etwa 2 Dollar, die günstigste Gruppe (DeepSeek V4 Flash, MiniMax M3, Doubao Seed 2.1 Pro, GLM-5.2, DeepSeek V4 Pro) bei 0,22 bis 0,58 Dollar. Dass MiniMax M3 mit 71 Millionen Token am meisten verbraucht und trotzdem unter 22 Dollar je Aufgabe bleibt, folgt aus seinem niedrigen Preis.
Im Durchschnitt über die Läufe ergibt sich außerdem, wie viel Kontext jeder Modellaufruf trägt: Teilt man Token je Aufgabe durch Aufrufe je Aufgabe, kommen GPT-5.6-sol und GPT-6-astra auf rund 191.000 und 185.000 Token je Aufruf, Hunyuan hy4 auf 56.000. Das sind Durchschnitte aus Eingabe und Ausgabe; weil jeder Aufruf den bisherigen Verlauf erneut als Eingabe enthält, sagen sie vor allem etwas über die Länge der Verläufe aus. Die Gemini-Zeilen weichen ab (13,3 Millionen Token bei 500 Aufrufen, nur 9,5 Minuten Modellzeit je Aufgabe). Das passt zur Angabe, dass die Gemini-Modelle unter einem anderen Harness liefen [1]; wir vergleichen sie deshalb nicht mit den übrigen.
Grenzkosten entlang der Frontier
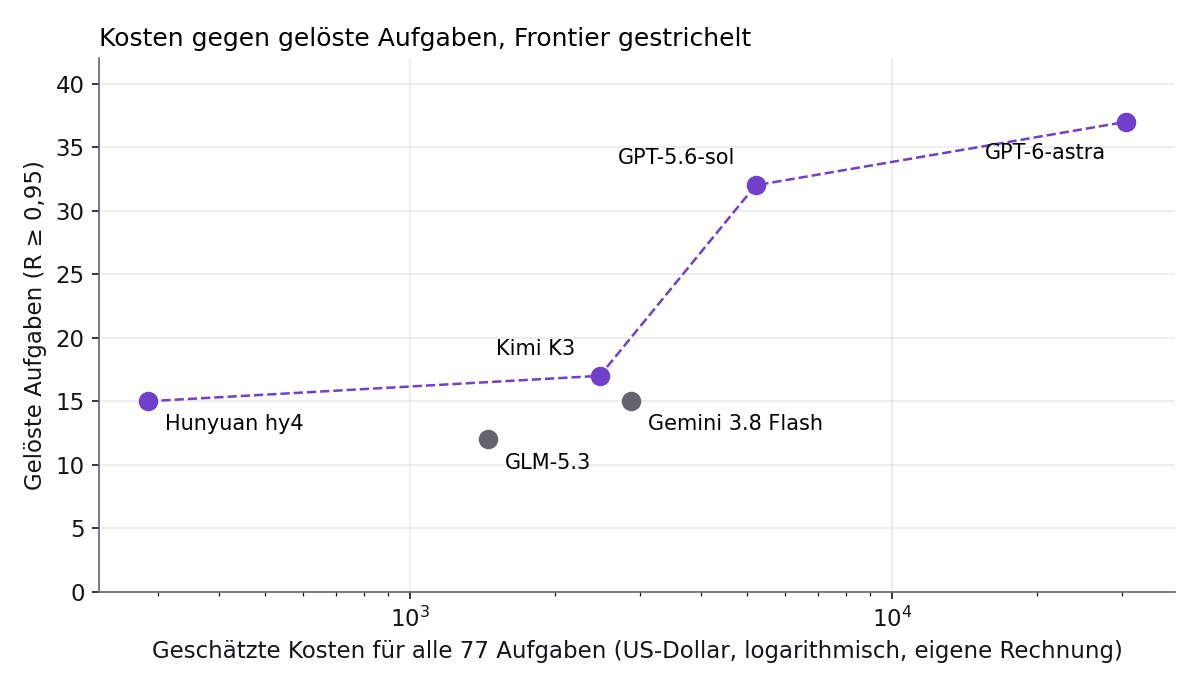
Für sechs Modelle kennen wir sowohl Kosten als auch die Zahl gelöster Aufgaben. Ordnet man sie nach Kosten, bleiben vier auf der Frontier: Hunyuan hy4, Kimi K3, GPT-5.6-sol und GPT-6-astra. GLM-5.3 (12 Aufgaben, rund 1.450 Dollar) und Gemini 3.8 Flash (15 Aufgaben, rund 2.873 Dollar) werden von hy4 (15 Aufgaben, rund 286 Dollar) unterboten oder gleichgezogen. Für die übrigen neun Modelle nennt der gelesene Text keine Lösungszahl, die Frontier ist also eine Teilmenge.
| Schritt | Zusätzlich gelöst | Zusatzkosten (77 Aufgaben) | Je zusätzlich gelöster Aufgabe |
|---|---|---|---|
| hy4 → Kimi K3 | +2 (15 → 17) | ca. 2.185 $ | ca. 1.090 $ |
| Kimi K3 → GPT-5.6-sol | +15 (17 → 32) | ca. 2.734 $ | ca. 182 $ |
| GPT-5.6-sol → GPT-6-astra | +5 (32 → 37) | ca. 25.376 $ | ca. 5.075 $ |
Die Zeilen der Tabelle zeigen, wie ungleich die Stufen sind. Von Kimi K3 auf GPT-5.6-sol kostet jede zusätzlich gelöste Aufgabe rund 182 Dollar. Die letzten fünf Aufgaben von GPT-5.6-sol auf GPT-6-astra kosten rund 5.075 Dollar je Aufgabe, fast das 28-Fache. Ob sich das lohnt, hängt davon ab, was eine gelöste Aufgabe wert ist. Eine Benchmark-Aufgabe ist dabei kein Arbeitsauftrag mit Preis, die Zahl taugt als Vergleichsmaßstab, nicht als Budget.
Was belegt ist, was offen bleibt
Belegt (nach Angabe des Papers)
- Auch die besten getesteten Modelle lösen weniger als die Hälfte der Aufgaben, und nur 16,8 % aller Läufe bestehen.
- Binäre Bewertung unterschätzt Fortschritt deutlich: 0,221 gegen 0,653 auf den Rekonstruktionsaufgaben.
- Zeitbudget ändert die Rangfolge im Mittelfeld.
Offen oder mit Vorsicht zu lesen
- Preprint, nicht nachgerechnet. Wir haben die Läufe nicht wiederholt und stützen uns auf die Angaben der Autoren.
- Interessenlage. Die erstgenannte Affiliation ist Tencent HY LLM Frontier; Tencents Hunyuan hy4 gehört zu den bewerteten Modellen [1]. Das Paper legt keine Ergebnisse vor, die darauf hindeuten, wir erwähnen es der Vollständigkeit halber.
- Uneinheitliche Hülle. Zwei Gemini-Modelle liefen laut Abbildungsunterschrift unter einem anderen Harness und fehlen in manchen Analysen [1]. Vergleiche mit ihnen sind schwächer.
- Modellnamen. Die Bezeichnungen (etwa GPT-6-astra) übernehmen wir so, wie das Paper sie nennt. Wir haben die zugehörigen Anbieterangaben nicht einzeln geprüft.
- Eine Hülle, ein Zeitlimit. Alle Ergebnisse gelten für Terminus-2, drei Stunden und höchste Denkstufe. Ob dieselbe Rangfolge mit anderen Agentenhüllen gilt, zeigt der Test nicht.
- Zahl der Wiederholungen. Wir haben keine Angabe gefunden, wie viele Wiederholungen je Modell und Aufgabe laufen. Ohne sie ist unklar, wie stark der Zufall einzelne Platzierungen bewegt.
Einordnung für die Praxis
- Zeitbudget als Parameter behandeln. Wer Agenten bewertet, sollte Prüfpunkte setzen und mehr als eine Messung nach dem Ende erheben.
- Fortschritt getrennt vom Endergebnis messen. Eine abgestufte Bewertung zeigt, wo ein Agent steckenbleibt. Sie ist aber nur so gut wie ihre Stufen.
- Fertigmeldungen nie ungeprüft glauben. Ein externer Test, der bei Fehlschlag weiterlaufen lässt, ist Teil eines belastbaren Aufbaus.
- Kosten pro gelöster Aufgabe ansehen, nicht nur die Erfolgsquote.
Das ersetzt keine eigene Evaluation auf den eigenen Aufgaben. Wie man eine kleine, faire Testmenge baut, steht in Evals: Testen statt Bauchgefühl; zu Kosten und Kontext hilft Tokens, Kontext, Kosten.
Checkliste: So lesen Sie einen Agenten-Benchmark
Aus der Auswertung ergibt sich eine Liste von Fragen, die wir an jeden Agenten-Benchmark stellen. Sie ist unsere redaktionelle Einordnung, keine Aussage des Papers.
- Wie viele Aufgaben, wie viele Läufe? Bei 77 Aufgaben bedeutet ein Abstand von fünf Aufgaben wenig. Ohne Wiederholungen ist unklar, wie viel der Zufall bewegt.
- Welches Zeitbudget? Das Ranking im Mittelfeld hängt vom Budget ab. Ein Test mit einer Stunde misst teils Tempo.
- Wer prüft „fertig“? Die Selbstmeldung des Agenten ist ein schwaches Signal, ein externer Prüfer ist Pflicht.
- Wie wird Fortschritt bewertet? Binär übersieht Teilergebnisse, dichte Leitern hängen an der Qualität ihrer Stufen.
- Welcher Aufbau? Dieselbe Agentenhülle für alle, oder nicht? Abweichungen (hier bei zwei Gemini-Modellen) schwächen den Vergleich.
- Was kostet ein Lauf, und womit wird gerechnet? Geschätzte Listenpreise sind keine Rechnung.
- Wer hat den Test gebaut und wer wird getestet? Überschneidungen sollten offengelegt sein, auch wenn sie keine Wirkung haben müssen.
Methode dieser Analyse
Alle Zahlen ohne Kennzeichnung stammen aus dem Preprint [1] und den in den Quellen genannten Seiten. Eigene Rechnungen sind im Text ausdrücklich so benannt und folgen diesen Formeln:
- Gesamtkosten für 77 Aufgaben = Kosten je Aufgabe (Tabelle 2) × 77; Kosten je gelöster Aufgabe = Gesamtkosten ÷ Zahl der Aufgaben mit R ≥ 0,95.
- Mischpreis = Kosten je Aufgabe ÷ Millionen Token je Aufgabe (Tabelle 2).
- Wilson-Intervall für den Anteil p = k/n mit z = 1,96 und n = 77, ohne Korrektur für gepaarte Aufgaben oder Wiederholungen.
- Grenzkosten = Differenz der Gesamtkosten zweier Frontier-Modelle ÷ Differenz der gelösten Aufgaben.
- Token je Aufruf = Token je Aufgabe ÷ Modellaufrufe je Aufgabe (Tabelle 2).
Wir haben keine Benchmark-Läufe wiederholt, den Quellcode des Benchmarks nicht ausgeführt und die Aufgaben nicht geprüft. Die Diagramme wurden mit Python (matplotlib) aus den hier genannten Zahlen erzeugt; zu jedem Diagramm gibt es eine Tabelle oder die Zahlen stehen im Text.
Glossar
- Agent: Ein Sprachmodell in einer Schleife mit Werkzeugen und Ziel, siehe Was ein KI-Agent wirklich ist.
- Harness: Die Umgebung um das Modell: Werkzeuge, Kontextverwaltung, Ausführung und Rückmeldung.
- Dichte Belohnung (Fortschrittsleiter): Abgestufte Punkte für Teilziele statt nur 0 oder 1 am Ende.
- R ≥ 0,95 („soft pass“): Aufgabe gilt als nahezu vollständig gelöst, wenn die normierte Punktzahl mindestens 0,95 beträgt.
- Pareto-Grenze: Die Menge an Modellen, die bei gegebenen Kosten nicht von einem anderen Modell mit höherer Leistung und geringeren Kosten übertroffen wird.
Methode
Dieser Beitrag wertet das genannte Preprint aus. Alle Zahlen stammen aus dem Paper, außer den ausdrücklich als „eigene Rechnung“ gekennzeichneten Umrechnungen. Wir haben keine Läufe selbst wiederholt. Der Text entstand mit KI-Unterstützung und wurde von der Redaktion verantwortet; Fehler bitte an die im Impressum genannte Adresse melden. Das Titelbild ist KI-generiert und im Bild gekennzeichnet.
Grenzen
Preprint ohne uns bekanntes abgeschlossenes Peer-Review; Zahlen nicht nachgerechnet; Kosten sind Schätzungen der Autoren; eine Agentenhülle (Terminus-2), ein Zeitlimit (drei Stunden). Eigene Wilson-Intervalle ignorieren Paarung der Aufgaben und Wiederholungen.
Quellen
- Long-Horizon-Terminal-Bench 2.0: Automating Diverse Task Construction and Measuring Sustained Agent Progress, arXiv (Li et al.) (abgerufen 2026-10-18)
- Long-Horizon-Terminal-Bench: Testing the Limits of Agents on Long-Horizon Terminal Tasks with Dense Reward-Based Grading, arXiv (Li et al.) (abgerufen 2026-10-18)
- Long-Horizon Terminal-Bench: Where Agents Run Out of Steam (Projektseite), Tencent HY LLM Frontier / zli12321.github.io (abgerufen 2026-10-18)
- Terminal-Bench: Benchmarking Agents on Hard, Realistic Tasks in Command Line Interfaces, arXiv (Merrill et al.) (abgerufen 2026-10-18)
- Terminal-Bench 2.0 and Harbor, tbench.ai (Merrill, Shaw) (abgerufen 2026-10-18)
- Measuring AI Ability to Complete Long Software Tasks, arXiv / NeurIPS 2025 (Kwa et al., METR) (abgerufen 2026-10-18)