 KI
Jeder große LLM-Anbieter veröffentlicht eine Preisliste, und keine sieht aus wie die andere. Anthropic staffelt nach Cache-Schreiben und Cache-Treffern [1], OpenAI zeigt Standard-, Batch- und Residency-Preise nebeneinander [2], Google verkündet Einführungspreise mit Ablaufdatum [3]. Wer nur die erste Zahl jeder Liste vergleicht, vergleicht nichts. Dieser Beitrag zeigt an den aktuellen Listen (Stand 20. Oktober 2026), wie man die Preise auf eine vergleichbare Größe bringt und welche Posten regelmäßig unterschätzt werden.
Die Grundpreise: Eingabe, Ausgabe, Cache
Alle Listenpreise gelten je eine Million Token (MTok) und verstehen sich in US-Dollar ohne Steuern. Die Ausgabe ist überall der teure Posten: Sie kostet das Vier- bis Sechsfache der Eingabe, weil das Erzeugen von Token seriell läuft und die teure Phase der Inferenz ist. Modelle mit sichtbarem Nachdenken erzeugen dabei viele Ausgabetoken, die der Nutzer nie sieht: Google weist Denk-Token ausdrücklich als Teil des Ausgabepreises aus [3].
| Modell | Eingabe | Ausgabe | Cache-Lesepreis |
|---|---|---|---|
| Claude Fable 5.1 | 10,00 $ | 50,00 $ | 0,25 $ (2,5 % der Eingabe) [1] |
| Claude Opus 5 | 5,00 $ | 25,00 $ | 0,50 $ (10 %) [1] |
| Claude Sonnet 5 | 2,00 $ | 10,00 $ | 0,20 $ (10 %) [1] |
| Claude Haiku 4.5 | 1,00 $ | 5,00 $ | 0,10 $ (10 %) [1] |
| GPT-5.6 Sol | 5,00 $ | 30,00 $ | 0,50 $ gecachte Eingabe [2] |
| GPT-5.6 Terra | 2,00 $ | 12,00 $ | 0,20 $ gecachte Eingabe [2] |
| GPT-5.6 Luna | 0,20 $ | 1,20 $ | 0,02 $ gecachte Eingabe [2] |
| Gemini 4 Argon (Einführungspreis) | 2,00 $ | 10,00 $ | 0,10 $ [3] |
| Gemini 3.8 Flash (Einführungspreis) | 0,75 $ | 3,75 $ | 0,075 $ [3] |
Blended Price: ein Vergleichsmaß mit offengelegter Annahme
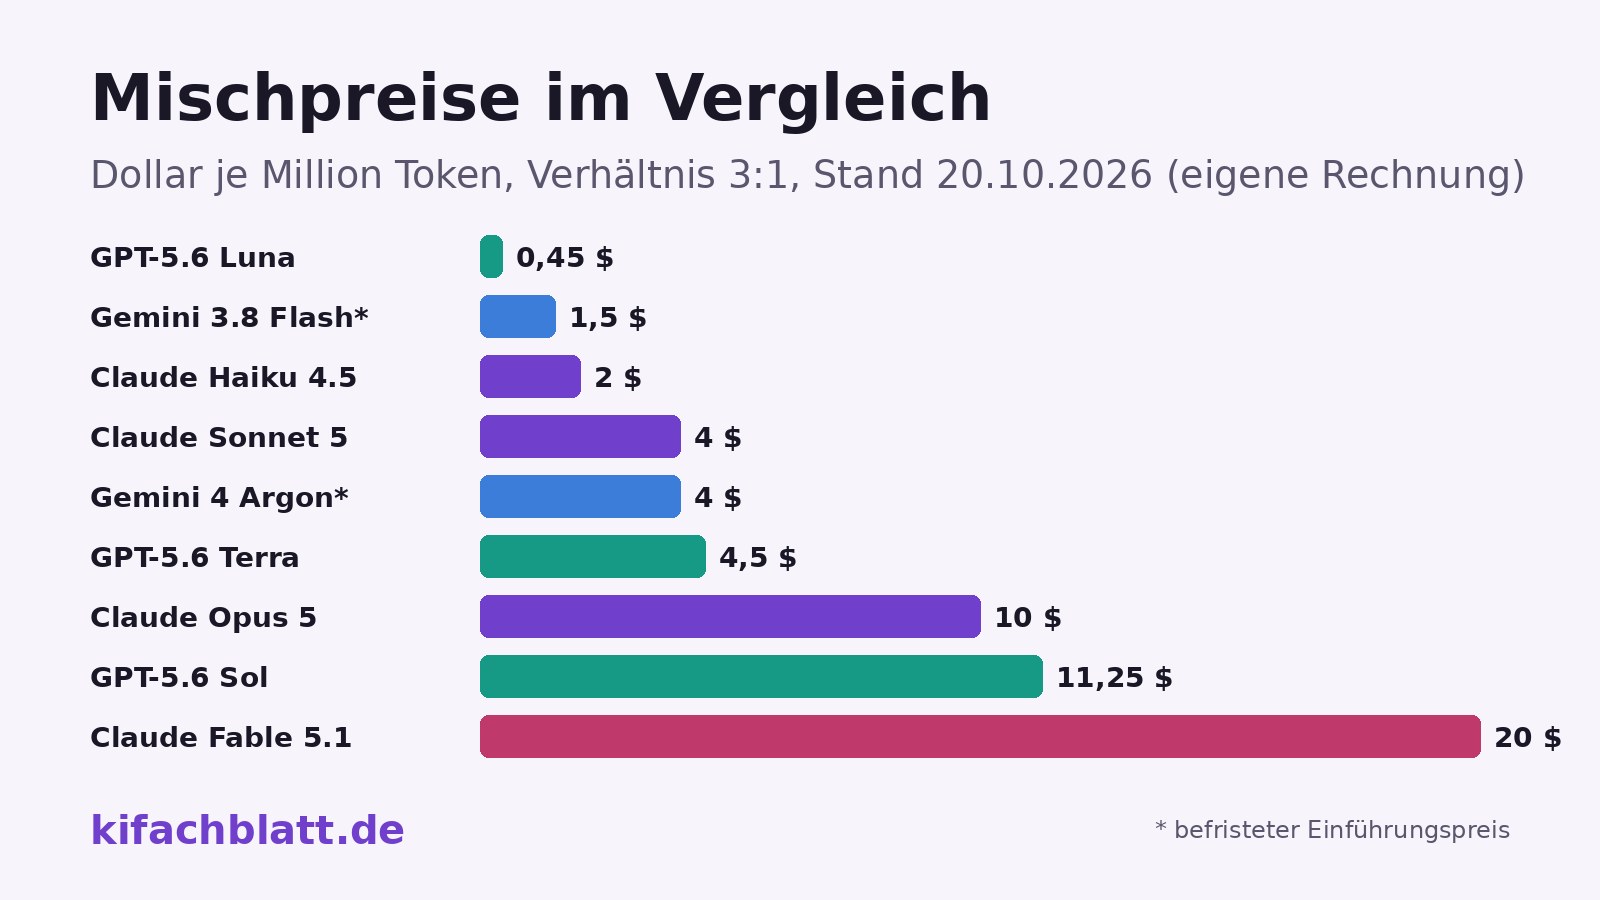
Der Blended Price mischt Eingabe- und Ausgabepreis zu einer einzigen Zahl, gewichtet nach dem erwarteten Verhältnis. Die Annahme gehört immer dazu: Für einen Chatbot mit langen Dokumenten in der Eingabe und kurzen Antworten rechnen wir hier mit drei zu eins. Die Formel: (3 × Eingabepreis + 1 × Ausgabepreis) geteilt durch 4. Ein anderes Verhältnis verändert die Reihenfolge; bei ausgeglichenem 1:1 rücken die Modelle mit hohem Ausgabepreis nach hinten.
Daten als Tabelle
| Dollar je Million Token (Mischpreis) | Mischpreis |
|---|---|
| Claude Fable 5.1 | 20 $ |
| GPT-5.6 Sol | 11,25 $ |
| Claude Opus 5 | 10 $ |
| GPT-5.6 Terra | 4,5 $ |
| Claude Sonnet 5 | 4 $ |
| Gemini 4 Argon* | 4 $ |
| Claude Haiku 4.5 | 2 $ |
| Gemini 3.8 Flash* | 1,5 $ |
| GPT-5.6 Luna | 0,45 $ |
Quelle: Eigene Rechnung aus [1] [2] [3]
Eigene Rechnung: (3 × Eingabe + 1 × Ausgabe) / 4, Listenpreise von [1] [2] [3]. Gemini-Modelle zum befristeten Einführungspreis. Das Verhältnis 3:1 ist eine Annahme und muss zur eigenen Last passen.
Zwei Lesarten sind wichtig. Erstens: Zwischen dem teuersten und dem billigsten Modell liegt hier ein Faktor von über 40, die Modellklasse entscheidet also mehr als der Anbieter. Zweitens: Günstig ist nicht automatisch passend. Ein Mischpreis sagt nichts über die Qualität; die Kennzahl, die beides verbindet, sind die Kosten pro gelöster Aufgabe.
Versteckte Posten, die Preislisten klein schreiben
- Werkzeug-Overhead. Wer Werkzeugaufrufe nutzt, zahlt für die Werkzeugbeschreibungen mit: Anthropic beziffert den Systemprompt für Werkzeugnutzung je nach Modell auf rund 300 bis 800 Eingabetoken pro Anfrage, ein einzelnes Bash-Werkzeug addiert weitere rund 250 bis 330 [1]. Bei kurzen Anfragen kann das den Grundpreis verdoppeln.
- Websuche und Grounding. OpenAI berechnet 10 $ je 1.000 Suchanfragen [2], Anthropic ebenfalls 10 $ je 1.000 Suchen [1], Google 14 $ je 1.000 Anfragen nach einem Freikontingent von 5.000 pro Monat [3]. Agenten, die viel recherchieren, bezahlen die Recherche extra.
- Langer Kontext. OpenAIs Standardpreise gelten nur bis 270.000 Kontexttoken [2]. Wer längere Fenster fährt, zahlt andere Sätze und sollte vor dem Skalieren nachsehen, nicht nach der ersten Rechnung.
- Tokenizer-Wechsel. Anthropic weist darauf hin, dass neuere Tokenizer bei Claude ab Version 4.7 rund 30 Prozent mehr Token für denselben Text erzeugen [1]. Ein Modellwechsel kann die Rechnung also auch dann ändern, wenn der Listenpreis gleich bleibt.
- Standortzuschläge. Datenverarbeitung in einer bestimmten Region kostet Aufschlag: OpenAI listet „Data Residency“ mit plus zehn Prozent [2], Anthropic einen Faktor 1,1 für US-only-Inferenz [1].
- Cache-Nebenkosten. Google berechnet für explizites Kontext-Caching künftig auch Speicherpreise je Million Token und Stunde [3]. Caching ist kein Gratis-Speicher.
Rabatte richtig lesen: Batch, Cache, Einführungspreise
Drei Rabattarten wiederholen sich bei allen Anbietern. Erstens Batch: Wer Anfragen asynchron bündelt und bis zu 24 Stunden warten kann, zahlt bei OpenAI, Anthropic und Google jeweils die Hälfte [1] [2] [3]. Zweitens Prompt-Caching: Wiederholte Prompt-Anfänge werden billiger gelesen, bei Anthropic mit dem Faktor 0,1 auf den Eingabepreis (0,025 bei Fable 5.1), dafür kostet das Schreiben in den Cache mehr als die normale Eingabe [1]; die Faustregel dort: Caching lohnt sich ab dem zweiten Lesen desselben Anfangs. Drittens Einführungspreise mit Verfallsdatum: Google verdoppelt die Preise von Gemini 4 Argon zum 1. Dezember 2026 und die von Gemini 3.8 Flash zum 1. Januar 2027 [3]. Umgekehrt wurde der Einführungspreis von Claude Sonnet 5 im Herbst 2026 zum dauerhaften Standardpreis [1]. Preislisten sind bewegliche Ziele; jede Kalkulation braucht ein Stand-Datum.
Eine vierte Form ist das Abo mit Guthaben: Mistral bündelt in seinen Plänen monatliches API-Guthaben, etwa 10 $ im kostenlosen und 30 $ im Pro-Plan [4]. Für schwankende kleine Lasten kann das die einfachste Rechnung sein.
Eigene Rechnung: 10.000 Support-Tickets
Wir rechnen ein Beispiel durch, Annahmen offengelegt: Ein Ticket verbraucht 3.000 Eingabetoken (Verlauf, Systemprompt, Kundentext) und 700 Ausgabetoken. Pro Anbieter ohne Cache und Batch, Standardpreise vom 20. Oktober 2026.
| Modell | Kosten je Ticket | Kosten je 10.000 Tickets |
|---|---|---|
| GPT-5.6 Luna | 0,0014 $ | 14,40 $ |
| Claude Haiku 4.5 | 0,0065 $ | 65,00 $ |
| Gemini 3.8 Flash (Einführungspreis) | 0,0049 $ | 48,75 $ |
| Claude Sonnet 5 | 0,0130 $ | 130,00 $ |
| GPT-5.6 Terra | 0,0144 $ | 144,00 $ |
| Claude Opus 5 | 0,0325 $ | 325,00 $ |
Zwei Lehren aus der Tabelle. Erstens entscheidet die Annahme über alles: Anthropic selbst rechnet in seiner Dokumentation ein ähnliches Support-Szenario mit Haiku 4.5 und kommt auf rund 37 $ je 10.000 Tickets, weil dort andere Token-Mengen und Anteile angesetzt werden [1]. Wer Annahmen nicht offenlegt, produziert Scheingenauigkeit. Zweitens wächst die Differenz mit dem Volumen: Der Sprung von Luna auf Opus 5 kostet in diesem Beispiel gut 310 $ pro 10.000 Tickets, bei einer Million Tickets im Jahr reden wir über gut 31.000 $. Wer mit solchen Volumina plant, rechnet deshalb nicht nur Modelle, sondern auch Betriebsmodelle gegenüber, etwa API gegen eigenes Hosting; die Systematik dazu liefert Build vs. Buy, und die Kostenrechnung im Unternehmenskontext KI-Kosten und ROI kalkulieren.
Checkliste für den Preisvergleich
- Mischpreis mit dem eigenen Eingabe-Ausgabe-Verhältnis rechnen, nicht mit dem der Beispiele anderer.
- Werkzeug- und Suchkosten je Anfrage schätzen und zum Tokenpreis addieren.
- Prüfen, bis zu welcher Kontextlänge der gezeigte Preis gilt.
- Batch- und Cache-Rabatte nur einpreisen, wenn der eigene Ablauf sie wirklich nutzt.
- Stand-Datum notieren und befristete Einführungspreise im Kalender markieren.
- Mit den Kosten pro gelöster Aufgabe gegenprüfen: Das billigste Modell ist das, das die Aufgabe am billigsten richtig löst, nicht das mit dem kleinsten Listenpreis.
Wer Vergleiche jenseits der eigenen Rechnung sucht, kann auf Auswertungen wie die Modellvergleiche von Artificial Analysis zurückgreifen, die Preise, Geschwindigkeit und Qualität gemeinsam betrachten [5]. Aber auch dort gilt: Die Methodik mitlesen, bevor man eine Rangfolge übernimmt.
Methode
Gelesen wurden am 20. Oktober 2026 die Preisseiten von Anthropic (Claude Docs) [1], OpenAI [2], Google (Gemini API) [3] und Mistral [4] sowie die Modellvergleichsseite von Artificial Analysis [5]. Mischpreise und die Ticket-Rechnung sind eigene Rechnungen der Redaktion aus den dort genannten Listenpreisen; Annahmen stehen jeweils am Text.
Grenzen
Alle Preise in US-Dollar ohne Steuern, Stand 20. Oktober 2026; Einführungspreise und Tokenizer-Regeln können sich jederzeit ändern. Die Beispielrechnung vergleicht nur Listenpreise, nicht Qualität: Ein teureres Modell kann pro gelöster Aufgabe billiger sein. Enterprise-Konditionen und Mengenrabatte sind individuell und hier nicht abgebildet.
Quellen
- Pricing (Modellpreise, Prompt Caching, Batch, Werkzeuge, Rechenbeispiele), Claude Docs / Anthropic (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- OpenAI API Pricing, OpenAI (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- Gemini Developer API pricing, Google AI for Developers (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- Pricing (Pläne und API-Guthaben), Mistral AI (abgerufen 2026-10-20) ↩1 ↩2
- Comparison of AI Models across Intelligence, Performance, and Price, Artificial Analysis (abgerufen 2026-10-20) ↩1 ↩2