 KI
Unternehmen haben 2025 rund 37 Mrd. US-$ für generative KI ausgegeben, nach 11,5 Mrd. im Vorjahr [3]. Gleichzeitig zeigt die Auswertung des MIT-Projekts NANDA, dass nur etwa 5 % der Pilotprojekte einen messbaren Effekt auf Gewinn oder Kosten erzielen [4]. Zwischen diesen beiden Zahlen liegt eine Lücke, die sich mit einem Werkzeug schließen lässt: einer ehrlichen Kostenrechnung. Diese Seite führt Schritt für Schritt vom Token-Preis zur Kosten-pro-Aufgabe-Rechnung und zur ROI-Formel – mit aktuellen Preisen und einer eigenen Beispielrechnung.
Stufe 1: Token-Preise richtig lesen
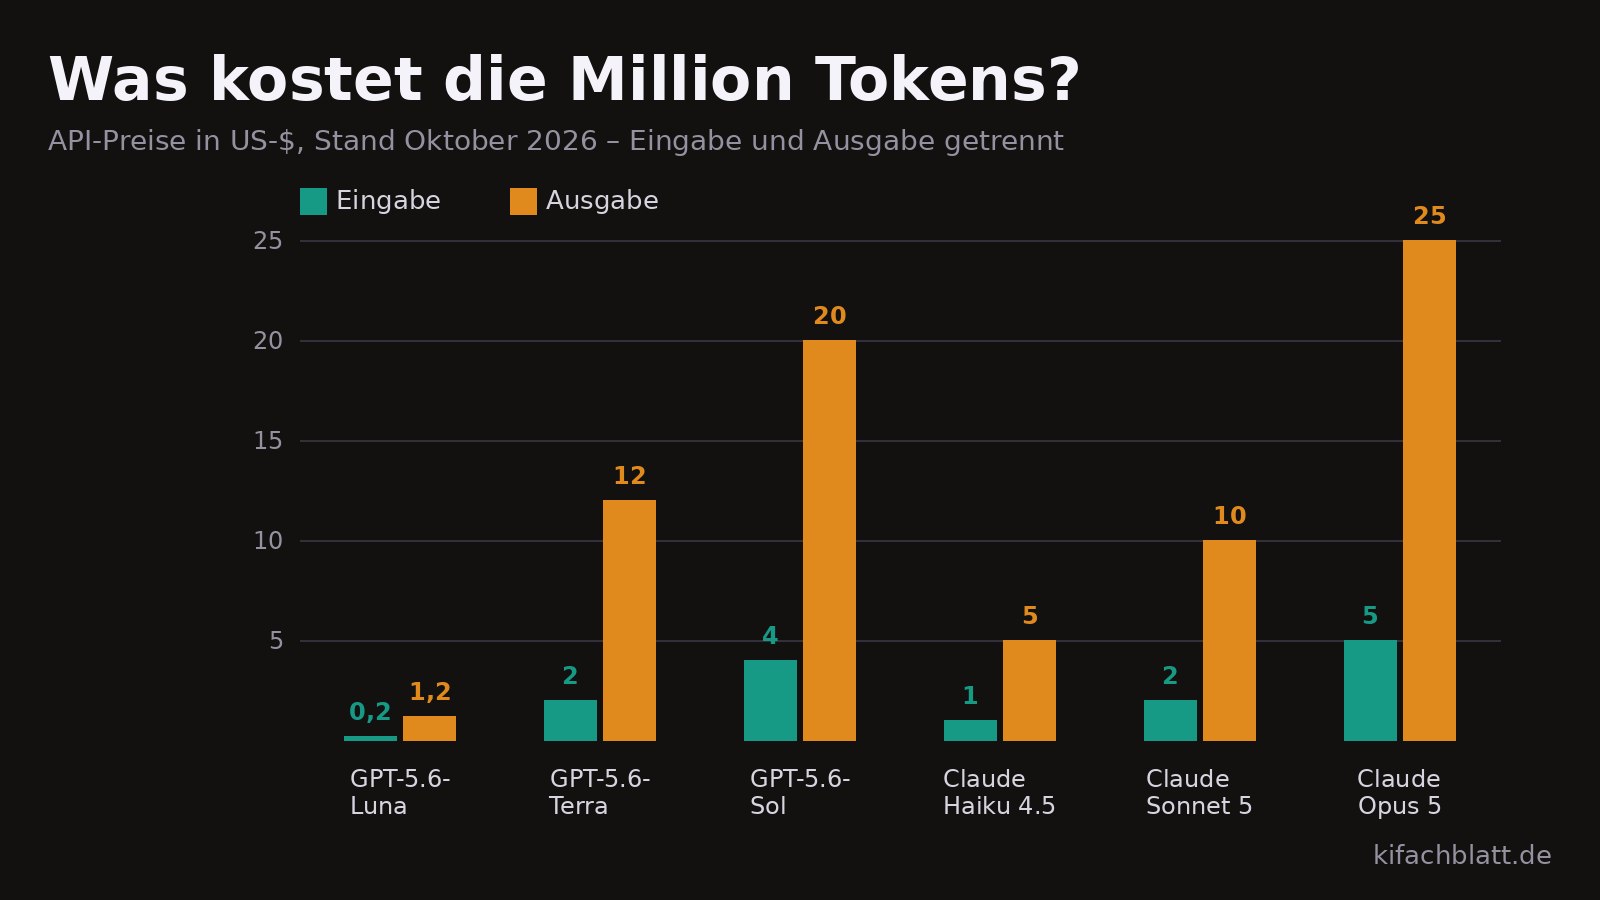
API-Preise werden pro Million Tokens angegeben, getrennt nach Eingabe (dein Prompt, Dokumente, Verlauf) und Ausgabe (die Antwort des Modells). Die Ausgabe ist fast immer deutlich teurer: Bei Claude Sonnet 5 kostet die Million Ausgabe-Tokens das Fünffache der Eingabe [2], bei GPT-5.6-Terra das Sechsfache [1]. Wer viele lange Dokumente einspeist und kurze Antworten erwartet, rechnet anders als jemand, der lange Texte generieren lässt. Zwei Rabatte sind zu kennen: Wiederkehrender Kontext kann über Prompt-Caching um den Faktor 10 billiger werden (bei Terra: 0,20 statt 2 US-$ je Million [1]), und zeitunkritische Aufgaben sind als Stapelverarbeitung (Batch) oft zum halben Preis zu haben [1].
- Eingabe
- Ausgabe
Daten als Tabelle
| Eingabe | Ausgabe | |
|---|---|---|
| GPT-5.6-Luna | 0,2 $ | 1,2 $ |
| GPT-5.6-Terra | 2 $ | 12 $ |
| GPT-5.6-Sol | 4 $ | 20 $ |
| Claude Haiku 4.5 | 1 $ | 5 $ |
| Claude Sonnet 5 | 2 $ | 10 $ |
| Claude Opus 5 | 5 $ | 25 $ |
Quelle: OpenAI API Pricing [1], Anthropic Pricing [2]
Standardpreise der Hersteller, kurzer Kontext, Stand 20. Oktober 2026. Die Spanne zwischen dem günstigsten und teuersten Modell beträgt Faktor 25 bei der Eingabe und rund Faktor 21 bei der Ausgabe (eigene Rechnung) [1][2].
Der Preisabstand ist kein Qualitätsurteil, aber eine Einladung zum Vergleichen: Für einfache, klar umrissene Aufgaben reicht oft ein günstigeres Modell; für Aufgaben mit hohen Fehlerfolgen kann ein teureres Modell die billigere Gesamtrechnung liefern, weil weniger Ergebnisse verworfen werden. Welches Modell für deine Aufgabe das beste Preis-Leistungs-Verhältnis hat, prüfst du am besten mit einer eigenen kleinen Testmenge – das Verfahren beschreibt Evals statt Bauchgefühl, und API-Preise vergleichen geht tiefer auf Blended Prices und versteckte Posten ein.
Stufe 2: Von Tokens zur Aufgabe
Ein Token-Preis allein sagt nichts über deine Kosten. Übersetze ihn in drei Schritten: Erstens die Token-Menge einer typischen Aufgabe messen (bei den Anbietern im Nutzungs-Dashboard oder mit zehn Testläufen). Zweitens die Quote der akzeptablen Ergebnisse bestimmen: Wie viele Ausgaben kannst du unverändert oder nach kleiner Korrektur verwenden? Drittens beides verbinden – die Kosten pro gelöster Aufgabe sind die API-Kosten je Versuch geteilt durch die Akzeptanzquote, plus die Prüfzeit.
Eigene Beispielrechnung mit Annahmen: Eine eingehende Kundenanfrage soll zusammengefasst und mit einem Antwortentwurf versehen werden. Ein Durchlauf verbraucht 2.000 Eingabe- und 800 Ausgabe-Tokens. Bei GPT-5.6-Terra [1] kostet das 0,004 + 0,0096 = rund 0,014 US-$. Akzeptanzquote nach Prüfung: 85 %. Die Kosten pro brauchbarer Antwort liegen damit bei rund 0,016 US-$ an Gebühren. Die menschliche Prüfung dauert 2 Minuten; bei 45 € internem Stundensatz sind das 1,50 €. Ein vollständig manuell geschriebener Entwurf braucht 15 Minuten, also 11,25 €. Ergebnis: Die KI-Strecke kostet pro Antwort rund 1,50 € plus Centbeträge statt 11,25 € – solange die Prüfzeit niedrig bleibt und die Quote hoch. Fällt die Akzeptanz auf 40 %, steigen nicht nur die Gebühren je brauchbarer Antwort, sondern vor allem die Prüf- und Nacharbeitszeit: Die Rechnung kippt über die Arbeitszeit, nicht über die Tokens.
Stufe 3: Vollkosten zusammensetzen
Für die Monats- und Jahresrechnung gehören auf die Kostenseite außer den API-Gebühren: Abos und Lizenzen, Einrichtung und Anbindung, laufende Pflege, Schulung, die Prüfzeiten und eine Reserve für Fehler und Nacharbeit. Das ist die TCO-Logik – die Gesamtbetriebskosten statt des Listenpreises [5]. Auf der Nutzenseite stehen eingesparte Arbeitszeit (bewertet mit echten Stundensätzen), schnellere Durchlaufzeiten (wenn sie Umsatz oder Zufriedenheit messbar verändern) und vermiedene Fehlerkosten. Fixe und variable Teile zu trennen lohnt sich: Die Grenzkosten einer zusätzlichen Aufgabe sind bei KI oft nur Cents – die Einrichtung ist der Batzen.
Stufe 4: ROI rechnen und ehrlich bleiben
Der Return on Investment ist eine einfache Formel: (Ertrag − Kosten) geteilt durch Kosten [6]. Auf das Beispiel oben angewendet: Spart die KI-Strecke pro Antwort rund 9,75 € an Arbeitszeit und werden monatlich 500 Anfragen bearbeitet, stehen etwa 4.875 € Ersparnis gegen vielleicht 800 € Vollkosten (Lizenz, Pflege, Prüfung) – ein monatlicher ROI von gut 500 %. Diese Zahl ist ehrlich, wenn die 15 Minuten Handarbeit real eingespart werden und die eingesparte Zeit anderweitig genutzt wird. Genau hier scheitern viele ROI-Rechnungen in der Praxis: Sie verbuchen Zeitersparnisse, die niemand freisetzt. Die NANDA-Zahlen [4] mahnen dasselbe aus der anderen Richtung: Wer weder Startwert noch Zielwert misst, kann den Ertrag nicht belegen.
| Ebene | Frage | Kennzahl |
|---|---|---|
| Modell | Was kostet die Million Tokens? | Eingabe-/Ausgabepreis [1][2] |
| Aufgabe | Was kostet ein Versuch, was ein brauchbares Ergebnis? | Kosten pro gelöster Aufgabe |
| Prozess | Was kostet der ganze Ablauf inklusive Prüfung und Pflege? | Vollkosten (TCO) |
| Unternehmen | Was bleibt nach Abzug aller Kosten? | ROI, Amortisationsdauer |
Zwei ehrliche Verzierungen gehören dazu. Erstens: Rechne konservativ – halbiere geschätzte Zeitersparnisse, bevor du sie ins Budget gibst. Zweitens: Lege die Amortisationsdauer offen (Einmalkosten geteilt durch monatlichen Überschuss). Ein Projekt, das sich nach vier Monaten trägt, ist ein anderes Gespräch als eines, das erst nach drei Jahren die schwarze Null sieht.
Methode
Gelesen wurden am 20. Oktober 2026 die Preisseiten von OpenAI und Anthropic, der Menlo-Ventures-Report (Ausgabensummen), der vollständige NANDA-Bericht als PDF, die TCO-Seite von IBM Think und der ROI-Grundlagenartikel von Investopedia. Alle Rechnungen in diesem Artikel (Cent-Kosten je Antwort, Prüfzeit-Bewertung, ROI-Beispiel, Preisfaktoren) sind eigene Rechnungen der Redaktion mit den im Text genannten Annahmen; die Token-Mengen und Akzeptanzquoten sind Beispielwerte, keine Messung an einem echten System.
Grenzen
API-Preise ändern sich häufig; alle Preise gelten für den 20. Oktober 2026. Die Beispielrechnung hängt an den angenommenen Token-Mengen, der Akzeptanzquote und dem Stundensatz – sie zeigt das Verfahren, nicht dein Ergebnis. Arbeitszeitersparnis ist nur dann ein Ertrag, wenn die Zeit tatsächlich freigesetzt und anderweitig genutzt wird; diese Annahme prüft keine Studie für dich ab. Die Menlo-Ventures-Ausgabenzahlen sind Schätzungen eines Investors, die NANDA-Zahlen haben Preprint-Charakter.
Quellen
- API Pricing (GPT-Modelle), OpenAI Developers, abgerufen am 20. Oktober 2026 (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- Model pricing (Claude-Modelle), Anthropic Docs, abgerufen am 20. Oktober 2026 (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4 ↩5
- 2025: The State of Generative AI in the Enterprise, Menlo Ventures, 9. Dezember 2025 (abgerufen 2026-10-20) ↩1 ↩2
- The GenAI Divide: State of AI in Business 2025, MIT Project NANDA, Juli 2025 (abgerufen 2026-10-20) ↩1 ↩2 ↩3
- What is total cost of ownership (TCO)?, IBM Think, 2025 (abgerufen 2026-10-20) ↩
- What Is Return on Investment (ROI) and How to Calculate It, Investopedia (abgerufen 2026-10-20) ↩