 KI
Wer ein Sprachmodell nutzt, sieht eine Frage und eine Antwort. Dahinter liegen Rechenarbeit und Speicher, und beides kostet Geld. Dieser Text erklärt, was passiert, wenn ein Modell antwortet, warum der Speicher das eigentliche Nadelöhr ist und aus welchen Posten sich ein Preis zusammensetzt. Ziel ist, dass Sie eine API-Rechnung, ein Hardwareangebot oder die Angabe „128K Kontext“ selbst einordnen können.
Tokens: die Recheneinheit
Ein Modell liest keine Buchstaben und keine ganzen Wörter, sondern Token: Wortteile, die ein Tokenizer festlegt. Gängig ist die Methode Byte Pair Encoding. Sie wurde für die maschinelle Übersetzung eingeführt, damit seltene Wörter in kleinere, bekannte Teile zerlegt werden können, etwa Namen, Komposita oder Lehnwörter [4]. Häufige Wörter bleiben ein Token, seltene zerfallen in mehrere.
Für Preis und Tempo zählt die Tokenzahl, nicht die Wortzahl. Metas Llama 3 nutzt ein Vokabular von 128.000 Token. Gegenüber dem Llama-2-Tokenizer stieg die Kompression auf einer Stichprobe englischer Texte von 3,17 auf 3,94 Zeichen pro Token. Das lässt das Modell bei gleichem Trainingsaufwand mehr Text „lesen“ [3]. Für Deutsch mit seinen langen Wortzusammensetzungen gilt: Dieselbe Seite Text braucht oft mehr Token als im Englischen. Eine belastbare Zahl dazu liefern die hier gelesenen Quellen nicht; das Zählwerkzeug des jeweiligen Anbieters gibt Auskunft.
Was beim Antworten passiert: zwei Phasen
Das PagedAttention-Paper beschreibt zwei Phasen [1]. In der Prompt-Phase verarbeitet das Modell die gesamte Eingabe und berechnet das erste neue Token. Weil alle Eingabetoken schon bekannt sind, lässt sich das parallel erledigen. In der Generierungsphase entsteht der Rest der Antwort Token für Token: Das Modell nimmt jeweils das zuletzt erzeugte Token und rechnet das nächste aus. Dieser sequentielle Ablauf macht die Arbeit speicherlastig [1].
Das erklärt zwei Kennzahlen, die in Vergleichen auftauchen: die Wartezeit bis zum ersten Zeichen (Time to First Token) hängt vor allem an der Prompt-Phase, die Geschwindigkeit danach (Time per Output Token) an der Generierungsphase. Analogie: Das Einlesen der Aufgabe geht schnell, das Schreiben der Antwort Wort für Wort dauert.
Der KV-Cache: das Gedächtnis während der Antwort
Für jedes Token, das das Modell schon gesehen hat, merkt es sich zwei Zahlenreihen, Schlüssel (Key) und Wert (Value), damit es sie beim nächsten Token nicht neu berechnen muss. Diese Merkliste heißt KV-Cache. Sie wächst mit jedem Token und mit jeder gleichzeitigen Anfrage. Das PagedAttention-Paper rechnet für das 13-Milliarden-Modell OPT vor: Ein einzelnes Token braucht 800 KB (2 Vektoren × 5.120 Dimensionen × 40 Schichten × 2 Byte in FP16). Bei 2.048 Token Länge sind das bis zu 1,6 GB für eine einzige Anfrage [1].
Auf einer 40-GB-GPU gehen im selben Beispiel rund 65 Prozent des Speichers an die Modellgewichte und knapp 30 Prozent an den KV-Cache. Von dessen Verwaltung hängt ab, wie viele Anfragen gleichzeitig laufen können [1]. Der KV-Cache begrenzt also den Durchsatz, nicht nur die Länge einer einzelnen Antwort.
Eigene Rechnung: KV-Cache bei Llama 3
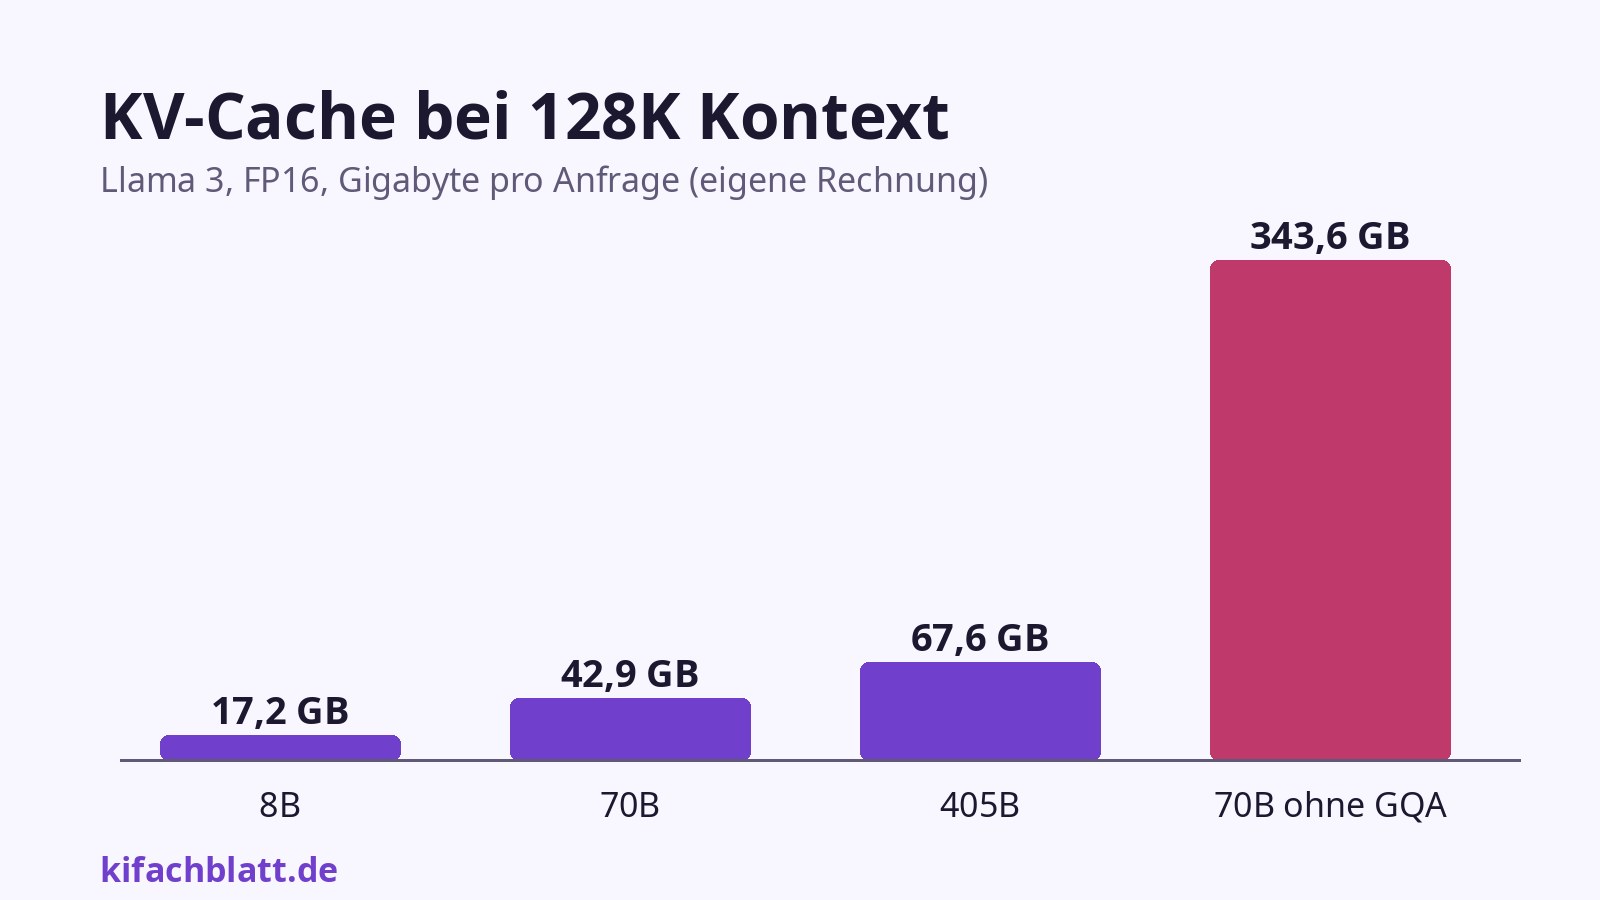
Die Formel lautet: 2 (Key und Value) × Schichten × KV-Köpfe × Kopfgröße × Bytes pro Zahl. Metas Tabelle der Architektur nennt für Llama 3 mit 8B, 70B und 405B Parametern 32, 80 und 126 Schichten und jeweils 8 Key/Value-Köpfe bei einer Modelldimension von 4.096, 8.192 und 16.384 [3]. Die Kopfgröße ergibt sich als Modelldimension geteilt durch die Zahl der Attention-Köpfe (32, 64, 128), also jeweils 128 (eigene Rechnung). Mit 2 Byte pro Zahl (FP16) folgt:
| Modell | KV-Cache pro Token | bei 8K Kontext | bei 128K Kontext |
|---|---|---|---|
| Llama 3 8B | 128 KiB | 1,1 GB | 17,2 GB |
| Llama 3 70B | 320 KiB | 2,7 GB | 42,9 GB |
| Llama 3 405B | 504 KiB | 4,2 GB | 67,6 GB |
Zum Vergleich: Die 70-Milliarden-Gewichte brauchen in FP16 140 GB (Parameter × 2 Byte, eigene Rechnung). Ein einziger 128K-Kontext fügt dann noch einmal rund 43 GB hinzu, und jede weitere gleichzeitige Anfrage bringt ihren eigenen Cache mit. Daraus erklärt sich, warum lange Kontexte teuer sind, selbst wenn die Preisliste sie nicht eigens ausweist.
Warum Llama 3 so wenig Cache braucht: GQA
Llama 3 setzt Grouped-Query-Attention (GQA) mit 8 Key/Value-Köpfen ein, um Inferenz zu beschleunigen und den KV-Cache zu verkleinern [3]. Das GQA-Paper erklärt die Idee: Multi-Query-Attention nutzt nur einen einzigen Key/Value-Kopf und beschleunigt das Dekodieren stark, kann aber die Qualität mindern. GQA wählt eine Zwischenlösung mit mehr als einem, aber weniger Key/Value-Köpfen als Query-Köpfen und kommt der Qualität von Multi-Head-Attention nahe, bei einer Geschwindigkeit wie Multi-Query [2].
Wie groß der Unterschied ist, zeigt die Rechnung für Llama 3 70B mit 64 statt 8 Key/Value-Köpfen (ein Szenario ohne GQA, rein rechnerisch): 2560 KiB pro Token und 343,6 GB bei 128K Kontext, also das Achtfache (eigene Rechnung).
Daten als Tabelle
| Modell | KV-Cache |
|---|---|
| 8B | 17,2 GB |
| 70B | 42,9 GB |
| 405B | 67,6 GB |
| 70B ohne GQA | 343,6 GB |
Quelle: Eigene Rechnung
Eigene Rechnung aus den Architekturangaben des Llama-3-Berichts [3]: 2 × Schichten × KV-Köpfe × 128 × 2 Byte × 131.072 Token. Die letzte Säule ist ein reines Rechenbeispiel mit 64 KV-Köpfen.
Wie Server den Cache verwalten: PagedAttention
Wird der Cache naiv reserviert, geht viel Platz durch Fragmentierung und Doppelungen verloren. PagedAttention lehnt sich an die Speicherseiten von Betriebssystemen an: Der Cache wird in Blöcke zerlegt, nach Bedarf zugeteilt und lässt sich zwischen Anfragen teilen. Das System vLLM erreichte damit nach Angabe der Autoren nahezu verlustfreie Cache-Nutzung und 2 bis 4 mal höheren Durchsatz bei gleicher Latenz im Vergleich zu FasterTransformer und Orca, besonders bei langen Sequenzen und großen Modellen [1]. Im Glossar: PagedAttention, Continuous Batching und Batching.
Quantisierung: kleiner rechnen
Quantisierung speichert die Gewichte (und teils den Cache) mit weniger Bit pro Zahl. 4 Bit statt 16 Bit bedeuten ein Viertel des Speichers für die Gewichte: Aus 140 GB für ein 70-Milliarden-Modell werden 35 GB (eigene Rechnung, ohne Overhead). Wie die Verfahren von GPTQ bis BitNet funktionieren, was sie an Qualität kosten und wo ihre Grenzen liegen, steht ausführlich in unserem Beitrag Quantisierung von Sprachmodellen: Verfahren, Zahlen, Grenzen. Kurz gesagt: Quantisierung ist der schnellste Hebel, ein Modell auf kleinere oder weniger Karten zu bekommen, und senkt damit die Kosten pro Anfrage.
Woraus sich ein API-Preis zusammensetzt
Anbieter rechnen in Dollar je Million Token (MTok) und trennen Eingabe und Ausgabe. Die Preisseite von Anthropic (Stand 20. Oktober 2026) nennt zum Beispiel für Claude Sonnet 5 2 Dollar je Million Eingabetoken und 10 Dollar je Million Ausgabetoken [5]. Die Ausgabe ist dort bei allen aktuell gelisteten Modellen fünfmal so teuer wie die Eingabe (eigener Vergleich der Tabelle [5]). Das passt zur Technik: Die Eingabe wird in der Prompt-Phase parallel verarbeitet, die Ausgabe entsteht Token für Token [1]. Nehmen Sie diese Zahlen als Beispiel für die Struktur, nicht als Dauerpreis; Preise ändern sich.
- Eingabe
- Ausgabe
Daten als Tabelle
| Dollar je Million Token | Eingabe | Ausgabe |
|---|---|---|
| Haiku 4.5 | 1 $ | 5 $ |
| Sonnet 5 | 2 $ | 10 $ |
| Opus 5 | 5 $ | 25 $ |
| Fable 5.1 | 10 $ | 50 $ |
Quelle: Anthropic, Pricing (20.10.2026)
Basispreise je Million Token laut Anthropic-Preisseite [5]; die Ausgabe kostet jeweils das Fünffache der Eingabe.
Die Preistreiber im Überblick
- Modellklasse. Zwischen kleinem und größtem Modell derselben Familie liegt in der Preisliste ein Faktor 10 (Haiku 4.5 gegenüber Fable 5.1, eigener Vergleich nach [5]).
- Ausgabelänge. Jedes Ausgabetoken kostet das Fünffache eines Eingabetokens. Modelle, die lange „nachdenken“, erzeugen viele Ausgabetoken, siehe Test-Time Compute und Reasoning-Modell.
- Kontextlänge. Bei neueren Claude-Modellen kostet ein Token im langen Kontext laut Preisseite dasselbe wie im kurzen: Eine Anfrage mit 900.000 Token wird zum gleichen Tokenpreis berechnet wie eine mit 9.000 [5]. Die Rechnung steigt trotzdem mit der Tokenzahl.
- Wiederverwendete Eingaben. Prompt-Caching senkt den Preis für Wiederholtes, siehe unten.
- Asynchrone Verarbeitung. Die Batch-Schnittstelle gibt bei Anthropic 50 Prozent Rabatt auf Eingabe und Ausgabe, dafür wird nicht sofort geantwortet [5].
- Werkzeuge. Bei Tool-Aufrufen zählen die Tokens der Werkzeugdefinitionen als Eingabe, und serverseitige Werkzeuge wie die Websuche können zusätzlich nutzungsabhängig kosten [5].
Prompt-Caching, durchgerechnet
Bei Anthropic kostet das Schreiben in den Cache (5 Minuten Laufzeit) das 1,25-Fache des Eingabepreises, ein Treffer nur das 0,1-Fache [5]. Das passt zum KV-Cache: Gleiche Anfangsstücke eines Prompts müssen nicht neu verarbeitet werden. Beispielrechnung mit Claude Sonnet 5 (2 Dollar Eingabe, 2,50 Dollar Cache-Schreiben, 0,20 Dollar Cache-Treffer, 10 Dollar Ausgabe je MTok, alle nach [5]). Ein Assistent schickt 20-mal denselben Systemprompt mit 50.000 Token plus je 500 Ausgabetoken, alle Anfragen innerhalb der Cache-Laufzeit:
| Variante | Eingabe | Ausgabe | Summe |
|---|---|---|---|
| Ohne Cache: 20 × 50.000 Token zu 2 $/MTok | 2,00 $ | 0,10 $ | 2,10 $ |
| Mit Cache: 1 × Schreiben (0,125 $) + 19 × Treffer (0,19 $) | 0,315 $ | 0,10 $ | 0,415 $ |
Das sind knapp 80 Prozent weniger (eigene Rechnung: 0,415 geteilt durch 2,10 ergibt rund 20 Prozent). Der Vorteil entfällt, wenn der Cache zwischen den Anfragen abläuft oder der Prompt-Anfang sich ändert. Prüfen Sie dafür die Bedingungen des Anbieters.
Eigene Hardware: wofür man tatsächlich zahlt
Wer ein lokales Modell betreibt, sieht dieselben Posten in anderer Form: Der Speicher der Grafikkarte muss Gewichte und KV-Cache aufnehmen, die Speicherbandbreite bestimmt das Tempo der Generierung (siehe Speicherbandbreite-Grenze), und die Parallelität hängt am freien Speicher. Quantisierung und GQA verkleinern beide Posten. Mehr dazu auf unserer Seite Lokale Modelle.
Eine Checkliste für den Alltag
- Tokens statt Wörter schätzen: Das Zählwerkzeug des Anbieters nutzen.
- Die Ausgabe begrenzen: Sie ist der teurere Posten und braucht die langsame Phase.
- Gleiche Anfangsstücke (Systemprompt, Dokument) vorn halten, damit Caching greift.
- Nicht jede Aufgabe braucht das größte Modell: Eine kleinere Klasse kostet in der Preisliste bis zu ein Zehntel.
- Lange Kontexte kosten Speicher und Geld, auch wenn die Preisliste keinen Aufschlag nennt.
- Nicht dringende Massenaufgaben über Batch-Schnittstellen laufen lassen, sofern der Anbieter sie anbietet.
Methode
Gelesen wurden am 20. Oktober 2026 die arXiv-Seiten und Texte von PagedAttention (vLLM), GQA, Byte Pair Encoding (Abstract), Teile des Llama-3-Berichts (Architektur, Tokenizer) und die Anthropic-Preisseite. Alle Umrechnungen (KV-Cache pro Token, bei 8K und 128K Kontext, Speicher der Gewichte, Caching-Beispiel, Preisverhältnisse) sind eigene Rechnungen mit den genannten Eingangswerten; die Kopfgröße 128 ergibt sich aus Modelldimension geteilt durch Attention-Köpfe [3]. Der Text entstand mit KI-Unterstützung und wurde von der Redaktion verantwortet.
Grenzen
Der Cache-Bedarf ist ohne Overhead und ohne Quantisierung des Caches gerechnet, reale Systeme weichen ab. Preise sind der Stand vom 20. Oktober 2026 eines einzelnen Anbieters und ändern sich; andere Anbieter rechnen anders. Die Beispielrechnung setzt voraus, dass alle Anfragen in die Cache-Laufzeit fallen und der Präfix identisch ist. Zur Tokenzahl deutscher Texte liegt keine belastbare Zahl aus den gelesenen Quellen vor.
Quellen
- Efficient Memory Management for Large Language Model Serving with PagedAttention, arXiv:2309.06180 (Kwon u. a., SOSP 2023, vLLM) (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints, arXiv:2305.13245 (Ainslie u. a., Google Research) (abgerufen 2026-10-20) ↩1 ↩2
- The Llama 3 Herd of Models, arXiv:2407.21783 (Meta, 2024) (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- Neural Machine Translation of Rare Words with Subword Units, arXiv:1508.07909 (Sennrich u. a., ACL 2016) (abgerufen 2026-10-20) ↩
- Pricing - Claude API Docs, Anthropic, abgerufen am 20.10.2026 (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6