 KI
Große Sprachmodelle scheitern in der Praxis oft nicht an ihrer Qualität, sondern an einer banalen Frage: Passt das Modell in den Speicher meiner Hardware? Quantisierung ist die Antwort der letzten vier Jahre. Sie bildet die Gewichte eines Modells von 16-Bit-Fließkommazahlen auf ganze Zahlen mit 8, 4, 2 oder sogar 1,58 Bit ab und macht damit Modelle lauffähig, die sonst Serverhardware bräuchten. Dieser Artikel erklärt die wichtigsten Verfahren, rechnet die Speicherersparnis nach und trennt Paperangaben von dem, was man in der Praxis erwarten darf.
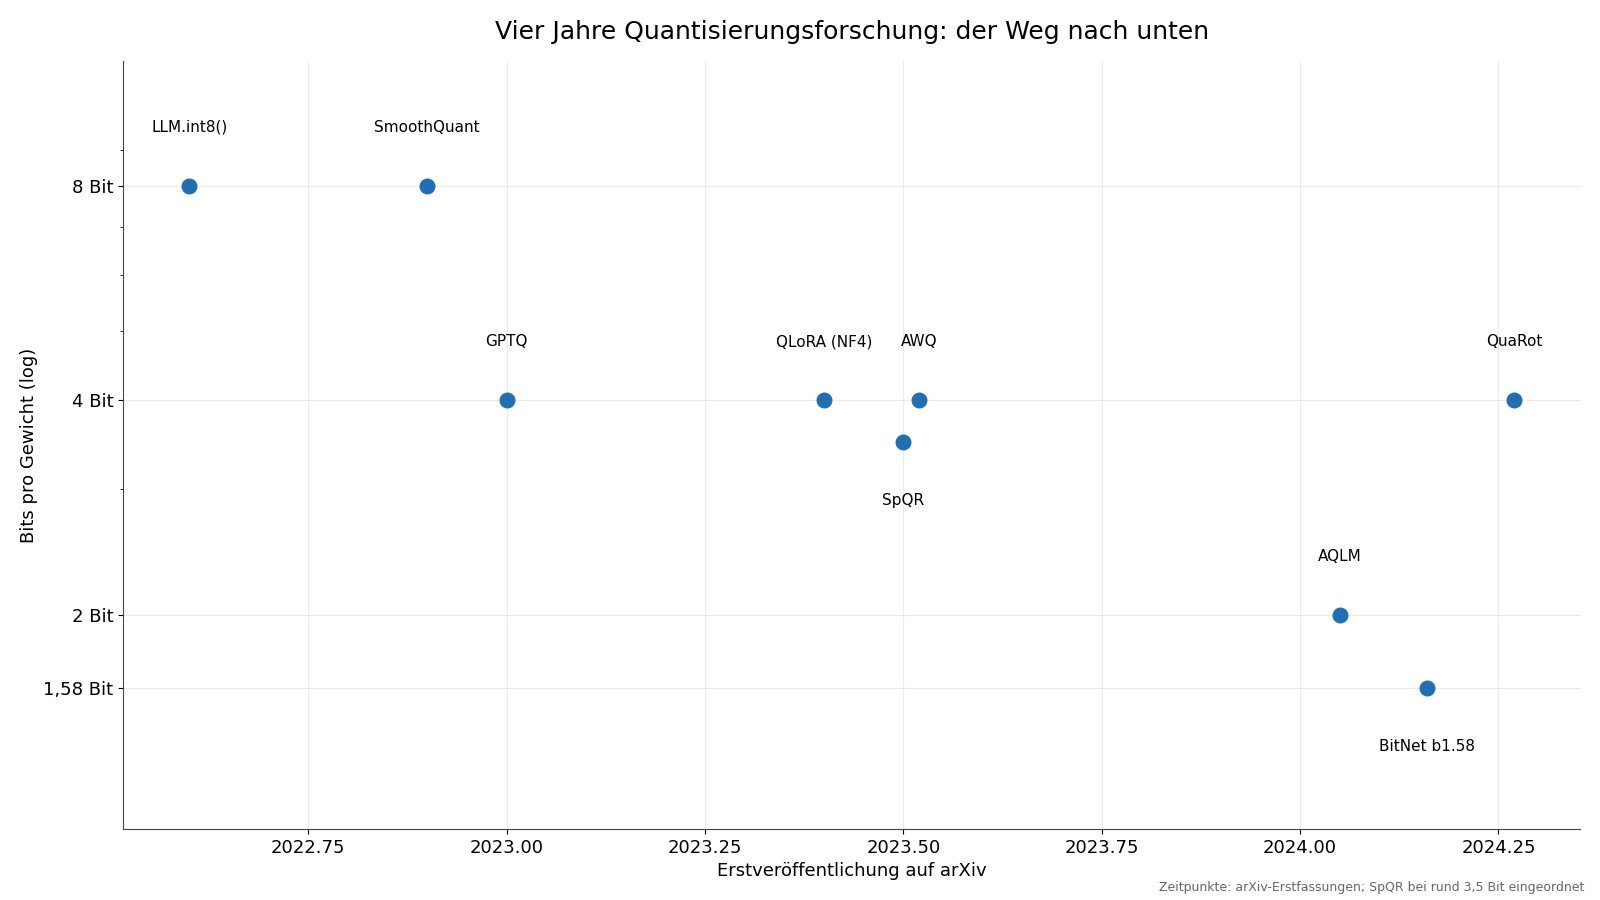
Der rote Faden durch die Forschung ist ein einziges Hindernis: Ausreißer. Wenige, sehr große Werte in Gewichten und Aktivierungen bestimmen, wie stark ein quantisiertes Modell an Qualität verliert. Jedes der hier vorgestellten Verfahren ist im Kern eine andere Strategie im Umgang mit diesen Ausreißern: sie auslagern (LLM.int8()), verschieben (SmoothQuant), schützen (AWQ, SpQR), wegrotieren (QuaRot) oder gar nicht erst entstehen lassen (BitNet).
Warum Speicher das erste Problem ist
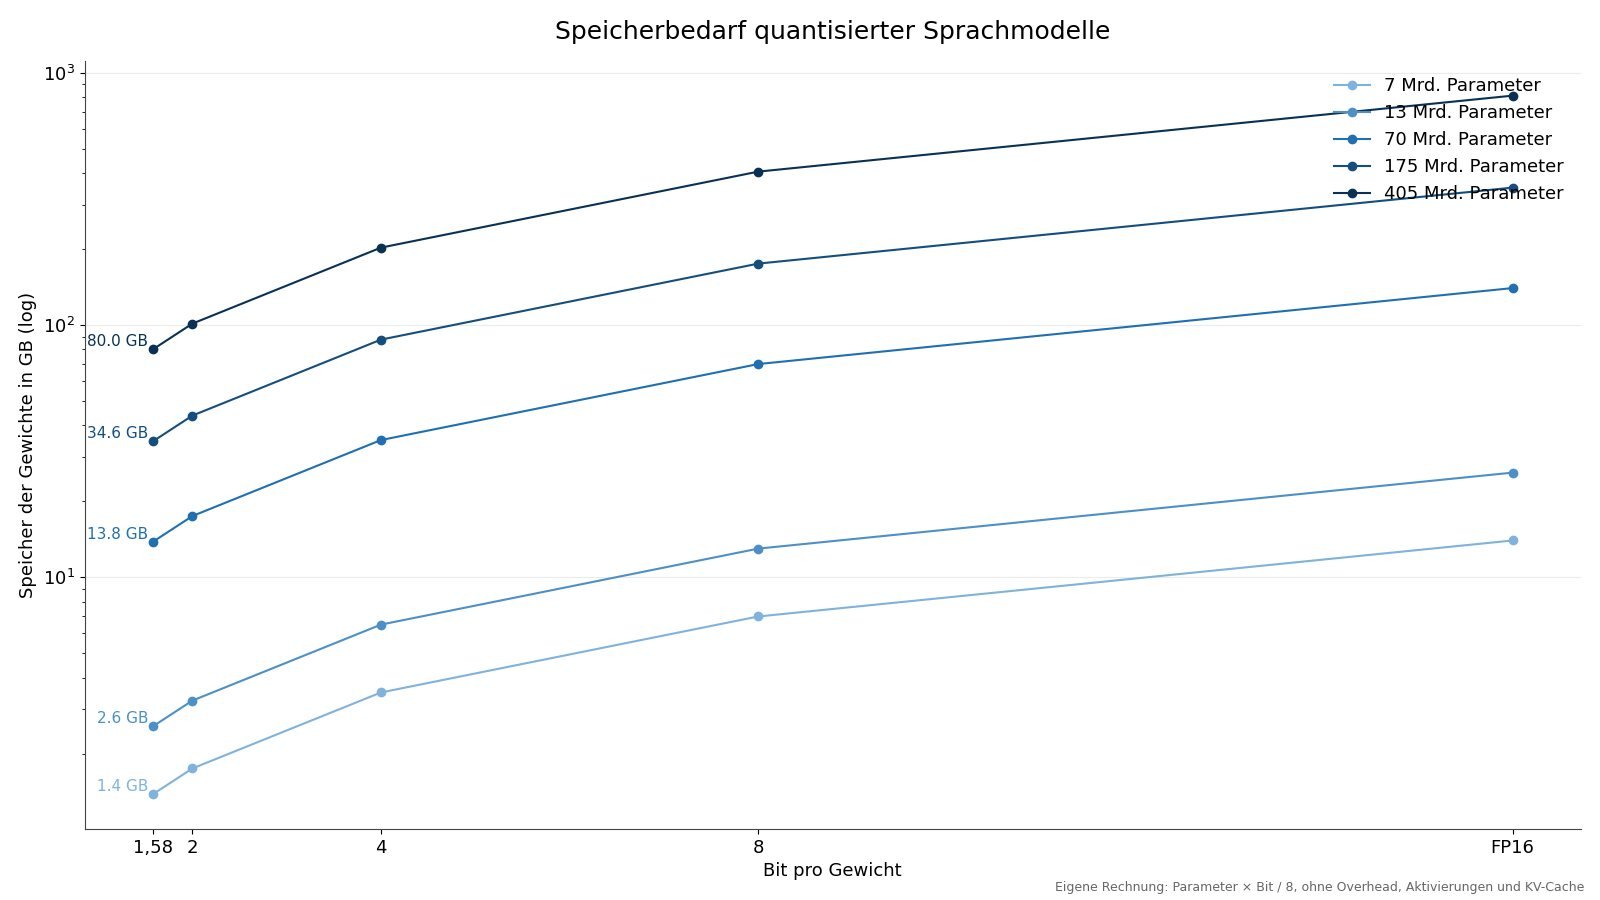
Der Speicherbedarf der Gewichte folgt einer einfachen Formel: Parameterzahl mal Bits pro Gewicht geteilt durch acht. Das GPTQ-Paper nennt das Beispiel GPT-3 mit 175 Milliarden Parametern: 326 GiB in FP16, mehr als jede einzelne GPU seinerzeit fasste [2]. SmoothQuant ergänzt: 350 GB bedeuteten acht 48-GB-A6000-GPUs oder fünf 80-GB-A100-GPUs allein für die Inferenz [3].
Die folgende Tabelle rechnet die Formel für gängige Modellgrößen durch (eigene Rechnung, ohne Overhead für Skalierungsfaktoren, ohne Aktivierungen und KV-Cache):
| Modellgröße | FP16 | 8 Bit | 4 Bit | 2 Bit | 1,58 Bit |
|---|---|---|---|---|---|
| 7 Mrd. | 14,0 GB | 7,0 GB | 3,5 GB | 1,75 GB | 1,4 GB |
| 13 Mrd. | 26,0 GB | 13,0 GB | 6,5 GB | 3,3 GB | 2,6 GB |
| 70 Mrd. | 140 GB | 70 GB | 35 GB | 17,5 GB | 13,8 GB |
| 175 Mrd. | 350 GB | 175 GB | 87,5 GB | 43,8 GB | 34,6 GB |
| 405 Mrd. | 810 GB | 405 GB | 202,5 GB | 101,3 GB | 80,0 GB |
Daten als Tabelle
| Bit pro Gewicht | 70-Mrd.-Modell |
|---|---|
| FP16 | 140 GB |
| 8 Bit | 70 GB |
| 4 Bit | 35 GB |
| 2 Bit | 17,5 GB |
| 1,58 Bit | 13,8 GB |
Quelle: Eigene Rechnung
Eigene Rechnung: 70 Mrd. Parameter mal Bitzahl geteilt durch 8; ohne Skalierungs-Overhead, Aktivierungen und KV-Cache.
Drei Lesarten dieser Zahlen. Erstens: Der Sprung von FP16 auf 8 Bit halbiert, der auf 4 Bit viertelt, 2 Bit achteln, 1,58 Bit zehenteln ungefähr. Zweitens: Erst 4 Bit bringt ein 70-Milliarden-Modell in den Bereich einer einzelnen Workstation-GPU mit 48 GB, erst 2 Bit in den Bereich hochwertiger Grafikkarten mit 24 GB. Drittens: Diese Zahlen betreffen nur die Gewichte. Aktivierungen, KV-Cache und Skalierungsfaktoren kommen hinzu, darum geht es weiter unten.
Grundlagen: Was n Bit pro Gewicht bedeuten
Bei der gängigsten Form, der affinen Quantisierung, wird ein Block von Gewichten auf ganze Zahlen abgebildet: Man bestimmt einen Skalierungsfaktor und einen Nullpunkt, bildet jeden Fließkommawert auf die nächste ganze Stufe ab und speichert nur diese Stufen plus die beiden Faktoren. Bei 4 Bit gibt es 16 Stufen. Zur Laufzeit wird zurückgerechnet: Stufe mal Skalierung plus Nullpunkt. Der Fehler entsteht beim Runden auf die Stufen.
Die Gruppengröße entscheidet über Genauigkeit und Overhead. Wird für jeweils 128 Gewichte ein eigener 16-Bit-Skalierungsfaktor gespeichert, kostet das 16 geteilt durch 128, also 0,125 Bit pro Gewicht zusätzlich (eigene Rechnung). Aus nominalen 4 Bit werden so 4,125 Bit; das 70-Milliarden-Modell belegt statt 35,0 dann 36,1 GB, ein Aufschlag von 3,2 Prozent. Kommt ein 16-Bit-Nullpunkt pro Gruppe hinzu, sind es 4,25 Bit und 37,2 GB. SpQR geht noch weiter und quantisiert mit Gruppen von nur 16 Werten, dafür werden die Skalierungen selbst wieder auf 3 Bit quantisiert [6].
Gemessen wird der Qualitätsverlust meist in Perplexity, der Unsicherheit des Modells bei der Vorhersage des nächsten Tokens auf einem Referenztext wie WikiText-2. Perplexity ist praktisch, weil sie ohne aufwendige Aufgabenbewertung auskommt, aber sie ist ein Näherungsmaß: Ein Modell kann in Perplexity fast unverändert sein und trotzdem in einer einzelnen Fähigkeit, etwa Mehrschritt-Mathematik, spürbar verlieren. Alle Papiere in diesem Artikel berichten Perplexity, die meisten zusätzlich Einzelaufgaben; beides sind Angaben der jeweiligen Autoren.
Das Kernproblem: Outlier
Warum ist Quantisierung bei Sprachmodellen überhaupt schwierig? Die Autoren von LLM.int8() fanden 2022 die Ursache: Ab einer bestimmten Modellgröße treten systematisch einzelne Feature-Dimensionen auf, deren Werte um ein Vielfaches größer sind als der Rest [1]. Diese emergenten Ausreißer dominieren die Vorhersagequalität. Quantisiert man sie grob mit, reicht die Auflösung der Stufen für die normalen Werte nicht mehr aus, und der Fehler wächst überproportional. Das erklärt, warum naive Rundung auf 8 Bit bei großen Modellen sichtbar scheitert, während sie bei kleinen durchgeht.
Ausreißer gibt es zweimal: in den Gewichten und in den Aktivierungen. Gewichte lassen sich in Ruhe offline untersuchen; Aktivierungen entstehen erst zur Laufzeit und hängen von der Eingabe ab. SmoothQuant formuliert die Konsequenz daraus so: Gewichte sind leicht zu quantisieren, Aktivierungen nicht [3]. Genau daraus entstand die Familie der Verfahren, die Schwierigkeit zwischen beiden Seiten hin- und herschieben.
Die Verfahren im Überblick
| Verfahren (Jahr) | Bit | Ansatz | Kernaussage |
|---|---|---|---|
| LLM.int8() (2022) [1] | 8 | Vektorweise Quantisierung plus 16-Bit-Ausnahme für Outlier | 175B verlustfrei in Int8; über 99,9 % der Werte in 8 Bit |
| SmoothQuant (2022) [3] | 8 | Schiebt Quantisierungs-Schwierigkeit von Aktivierungen auf Gewichte | Bis 1,56x schneller, halber Speicher, 530B auf einem Knoten |
| GPTQ (2022/23) [2] | 3-4 | One-Shot-Gewichtsquantisierung mit Näherung zweiter Ordnung | 175B in etwa 4 GPU-Stunden; 3,25x bis 4,5x schneller |
| QLoRA (2023) [5] | 4 | Feintuning über ein eingefrorenes 4-Bit-Modell mit NF4-Format | 65B-Feintuning auf einer 48-GB-GPU |
| AWQ (2023/24) [4] | 4 | Schützt 1 % saliente Gewichte, ausgewählt nach Aktivierung | Mehr als 3x schneller auf Desktop- und Mobil-GPUs |
| SpQR (2023) [6] | 3-4 | Speichert Outlier-Gewichte separat in hoher Präzision | Unter 1 % relativer Perplexity-Verlust |
| AQLM (2024) [7] | 2-3 | Additive Quantisierung mit gelernten Codebüchern | Referenz im 2-Bit-Bereich |
| QuaRot (2024) [8] | 4 | Rotiert das Modell, bis keine Outlier mehr auftreten | Alles in 4 Bit, inklusive KV-Cache; max. 0,47 Perplexity-Verlust |
| BitNet b1.58 (2024) [9] | 1,58 | Ternäre Gewichte, von Anfang an so trainiert | Gleiche Qualität wie FP16 bei gleicher Größe und Datenmenge |
LLM.int8(): der Anfang (2022)
Tim Dettmers und Kollegen lösten das Outlier-Problem 2022 mit einer Hybride [1]. Fast alle Werte werden vektorweise quantisiert: Jede Zeile und Spalte der Matrixmultiplikation bekommt eine eigene Normierungskonstante, was den Fehler klein hält. Die wenigen emergenten Outlier-Dimensionen, deutlich unter einem Promille aller Werte, werden herausgelöst und in 16 Bit gerechnet. Das Ergebnis: Mehr als 99,9 Prozent der Multiplikationen laufen in 8 Bit, und Modelle bis 175 Milliarden Parameter zeigen im Paper keine messbare Verschlechterung gegenüber dem 16-Bit-Original [1].
Die praktische Wirkung war erheblich: Ein 175-Milliarden-Checkpoint, der in FP16 350 GB braucht, passt in Int8 in 175 GB (eigene Rechnung) und damit laut Paper auf einen einzelnen Server mit Consumer-GPUs [1]. LLM.int8() wurde zum Standardbaustein in der bitsandbytes-Bibliothek und ist bis heute die Referenz dafür, dass 8 Bit verlustfrei sein können, wenn man die Ausreißer ernst nimmt.
SmoothQuant: die Schwierigkeit verschieben (2022/23)
SmoothQuant aus dem MIT HAN Lab geht einen Schritt weiter: nicht nur die Gewichte, auch die Aktivierungen sollen in 8 Bit, denn nur dann laufen alle Matrixmultiplikationen auf den schnellen Int8-Einheiten [3]. Das Problem: Aktivierungen enthalten die Outlier. Die Lösung ist eine mathematisch äquivalente Umformung: Die Aktivierungen werden pro Kanal herunterskaliert, die Gewichte der nächsten Schicht um denselben Faktor hochskaliert. Das Produkt bleibt gleich, aber die Schwierigkeit der Quantisierung wandert von den Aktivierungen zu den Gewichten, wo sie leichter zu tragen ist [3].
Das Paper berichtet bis zu 1,56-fache Beschleunigung und halbierten Speicher bei vernachlässigbarem Genauigkeitsverlust, getestet auf Modellfamilien von OPT und BLOOM über Llama bis Mistral und Mixtral, und demonstriert den Betrieb eines 530-Milliarden-Modells auf einem einzigen Knoten [3]. Wichtig ist die Art der Methode: trainingfrei, ohne Rekonstruktion, mit einer kleinen Kalibrierungsmenge zur Bestimmung der Skalierungsfaktoren.
GPTQ: Gewichte in 4 Bit mit Näherung zweiter Ordnung (2022/23)
GPTQ von Elias Frantar und Kollegen war der Durchbruch unter 8 Bit [2]. Das Verfahren quantisiert die Gewichte schichtweise und korrigiert nach jedem quantisierten Gewicht die noch nicht quantisierten Restgewichte, und zwar mithilfe approximierter Krümmungsinformation zweiter Ordnung (eine Verallgemeinerung des Optimal-Brain-Surgeon-Gedankens). Der Fehler eines einzelnen gerundeten Gewichts wird also sofort durch die Nachbargewichte teilkompensiert.
Die Kennzahlen: Ein 175-Milliarden-Modell ist in etwa vier GPU-Stunden quantisiert, bei 3 oder 4 Bit pro Gewicht mit laut Paper vernachlässigbarer Verschlechterung; auch 2 Bit und ternäre Stufen liefern noch brauchbare Ergebnisse [2]. Die gemessenen Beschleunigungen gegenüber FP16 liegen bei 3,25x auf einer A100 und 4,5x auf der günstigeren A6000 [2].
Zur Einordnung (eigene Rechnung): Die Gewichte schrumpfen von 326 GiB auf rund 82 GiB, also exakt auf ein Viertel. Der gemessene Tempogewinn von 3,25x bleibt dahinter zurück, weil Inferenz mehr ist als Gewichtstransport: Das Entpacken der 4-Bit-Werte kostet Rechenzeit, und Aktivierungen sowie der KV-Cache laufen weiter in höherer Präzision. Wer aus der Kompression einen Vierfach-Speedup erwartet, überliest den Unterschied zwischen Speicherbandbreite und Gesamtsystem.
QLoRA: Quantisierung trifft Feintuning (2023)
QLoRA beantwortet eine andere Frage: nicht „wie bekomme ich das Modell klein?", sondern „wie bekomme ich es feingetunt, ohne einen Serverschrank zu mieten?" [5]. Die Antwort: Das Basismodell wird auf 4 Bit quantisiert und eingefroren; trainiert werden nur kleine Adaptermatrizen (LoRA), deren Gradienten durch das quantisierte Modell hindurchgerechnet werden. So ließ sich ein 65-Milliarden-Modell auf einer einzigen GPU mit 48 GB feintunen, bei laut Paper voller 16-Bit-Feintuning-Qualität [5].
Drei Details machen das möglich. Erstens NF4, ein 4-Bit-Datentyp, dessen Stufen informationstheoretisch optimal für normalverteilte Gewichte gelegt sind; Gewichte neuronaler Netze sind näherungsweise normalverteilt, also wird die begrenzte Zahl von 16 Stufen dort konzentriert, wo die Masse der Werte liegt. Zweitens doppelte Quantisierung: Auch die Skalierungskonstanten werden quantisiert, was den Overhead der 4-Bit-Darstellung weiter drückt. Drittens ausgelagerte Optimiererzustände (paged optimizers), die Speicherspitzen abfangen [5].
Zur Plausibilität (eigene Rechnung): 65 Milliarden Parameter in 4 Bit belegen 32,5 GB. Auf einer 48-GB-GPU bleiben rund 15 GB für Adapter, Gradienten der Adapter, Aktivierungen und Puffer. Eng, aber stimmig mit der Papierangabe. Der Erfolg des Ansatzes zeigt sich auch daran, dass die Autoren über 1.000 Modelle feintunten und mit der Guanaco-Familie auf dem Vicuna-Benchmark 99,3 Prozent des damaligen ChatGPT-Niveaus erreichten, nach 24 Stunden auf einer GPU [5]. Eine Nebenbefund des Papers sollte man mitnehmen: Die Autoren warnen, dass gängige Chatbot-Benchmarks die Qualität von Chatbots nicht verlässlich messen [5].
AWQ: Aktivierungen entscheiden, welche Gewichte wichtig sind (2023/24)
AWQ, ausgezeichnet mit dem Best-Paper-Preis der MLSys 2024, dreht die Frage um: Statt alle Gewichte gleich zu behandeln, identifiziert es die etwa 1 Prozent salienten Gewichtskanäle und schützt sie [4]. Bemerkenswert ist, wie die Auswahl fällt: nicht nach den Gewichten selbst, sondern nach der Verteilung der Aktivierungen, die durch diese Kanäle laufen. Der Schutz erfolgt ohne Mischpräzision, also ohne dass einzelne Kanäle in 16 Bit gespeichert werden müssten; stattdessen skaliert AWQ die salienten Kanäle per äquivalenter Umformung hoch, was den relativen Quantisierungsfehler verkleinert [4].
Weil AWQ weder Rückwärtsrechnung noch Rekonstruktion braucht, überträgt es sich gut auf neue Domänen. Das Paper enthält dazu ein aufschlussreiches Experiment: Kalibriert man auf PubMed-Abstracts und prüft auf Enron-E-Mails (oder umgekehrt), steigt die Perplexity bei AWQ nur um 0,5 bis 0,6 Punkte, bei GPTQ dagegen um 2,3 bis 4,9 [4]. Für die Praxis heißt das: Wer keine Kalibrierungsdaten aus der Zieldomäne hat, fährt mit AWQ sicherer.
Zum Verfahren gehört TinyChat, ein eigenes Inferenzsystem für 4-Bit-Modelle auf Desktop- und Mobilgeräten. Die Tabellen des Papers berichten unter anderem für VILA-7B auf einer RTX 4090 einen Durchsatz von 168,1 gegenüber 58,5 Tokens pro Sekunde in FP16 (Quotient 2,87x, eigene Rechnung) und für VILA-13B auf derselben Karte 99,0 Tokens pro Sekunde, wo FP16 gar nicht in den Speicher passt [4]. Auf einem Jetson Orin Nano mit 8 GB und 15 Watt läuft ein 4-Bit-Modell mit 35,6 Tokens pro Sekunde [4]. Die stärkste Aussage ist dabei nicht der Tempogewinn, sondern das Umschalten von „läuft nicht" auf „läuft".
SpQR: Ausreißer in höherer Präzision konservieren (2023)
SpQR verfolgt die konsequenteste Variante des Outlier-Gedankens: Statt die Ausreißer zu umschiffen, werden sie identifiziert und einzeln in hoher Präzision gespeichert, während alle anderen Gewichte auf 3 bis 4 Bit gehen [6]. Dazu kommen sehr kleine Gruppen von 16 Werten, deren Skalierungen selbst wieder auf 3 Bit quantisiert werden. Das Ergebnis laut Paper: weniger als 1 Prozent relativer Perplexity-Verlust gegenüber dem Original, über alle Modellgrößen hinweg [6].
Die Praxiszahl: Ein 33-Milliarden-Modell läuft damit ohne messbare Einbuße auf einer einzigen 24-GB-Consumer-GPU, bei 15 Prozent Tempogewinn gegenüber dem 16-Bit-Betrieb und mehr als vierfacher Speicherkompression [6]. Plausibilitätskontrolle (eigene Rechnung): 33 Milliarden Parameter bei effektiv rund 3,5 Bit belegen etwa 14,4 GB; für Aktivierungen und Cache auf einer 24-GB-Karte bleibt damit genug Raum.
AQLM: Codebücher statt Stufen (2024)
AQLM verlässt die Idee fester Quantisierungsstufen. Stattdessen werden Gewichte durch Summen aus Einträgen gelernten Codebücher angenähert, eine Technik aus dem Umfeld der Vektorquantisierung für die Informationssuche [7]. Zwei Neuerungen: Die Codebücher werden eingabeabhängig gelernt, und sie werden über alle Schichten eines Transformer-Blocks gemeinsam optimiert. Das Paper meldet als Erstes eine Pareto-optimale Front zwischen Modellgröße und Genauigkeit unter 3 Bit und deutliche Verbesserungen im 2-Bit-Regime [7].
Warum das relevant ist: Unter 3 Bit versagen Stufenquantisierer zunehmend, weil 4 bis 8 Stufen einfach zu wenig Information tragen. Codebücher können die verbleibende Auflösung gezielter verteilen. AQLM liefert dazu schnelle GPU- und CPU-Kernel, die nach Angaben der Autoren mit optimierten FP16-Implementierungen beim Tempo mithalten oder sie schlagen, bei deutlich kleinerem Speicher [7].
QuaRot: das Modell rotieren, bis die Outlier verschwinden (2024)
QuaRot wählt die mathematisch eleganteste Strategie: Das Modell wird mit orthogonalen Matrizen so rotiert, dass die Outlier im versteckten Zustand verschwinden, ohne dass sich die Ausgabe ändert [8]. Rotationen lassen sich verlustfrei in die umliegenden Gewichtsmatrizen einrechnen. Danach ist die Verteilung so glatt, dass schlichte Rundung auf die nächste Stufe genügt: 6- und 8-Bit-Modelle entstehen laut Paper verlustfrei ganz ohne Kalibrierungsdaten [8].
Der eigentliche Beitrag liegt woanders: QuaRot quantisiert erstmals die gesamte Inferenzkette auf 4 Bit, also Gewichte, Aktivierungen und den KV-Cache. Alle Matrixmultiplikationen laufen in 4 Bit. Für LLaMa2-70B berichtet das Paper maximal 0,47 WikiText-2-Perplexity-Punkte Verlust und 99 Prozent verbleibende Zero-Shot-Leistung [8]. Der KV-Cache-Anteil wird mit wachsendem Kontextfenster wichtiger: Bei langen Eingaben ist der Cache oft größer als die Gewichte, und Verfahren, die nur die Gewichte anfassen, lassen diesen Speicher unangetastet.
BitNet b1.58: von Anfang an 1,58 Bit (2024)
Alle bisherigen Verfahren komprimieren nachträglich. BitNet b1.58 aus Microsoft Research dreht das um: Das Modell wird von vornherein mit ternären Gewichten trainiert, jedes Gewicht ist minus eins, null oder eins, was 1,58 Bit entspricht [9]. Die zentrale Aussage des Papers: Bei gleicher Modellgröße und gleicher Trainingsdatenmenge erreicht b1.58 die Perplexity und die Aufgabenleistung des FP16-Vergleichsmodells, bei deutlich geringeren Kosten für Latenz, Speicher, Durchsatz und Energie [9].
Die Konsequenz (eigene Rechnung): Ein 70-Milliarden-Modell in 1,58 Bit belegt 13,8 GB und passt damit in den Speicher einer 16-GB-Grafikkarte, ohne jede Nachbearbeitung. Multiplikationen werden weitgehend durch Additionen ersetzt, was die Autoren als Türöffner für Spezialhardware beschreiben [9]. Der Haken: Das Verfahren setzt ein von Grund auf neues Training voraus. Für bestehende Modelle bleibt die nachträgliche Quantisierung der einzige Weg; für künftige Modelle zeigt BitNet, wie stark sich Architektur und Zahlenformat gemeinsam entwerfen lassen. Es sei ergänzt, dass das Paper sich selbst als laufende Arbeit bezeichnet.
GGUF und der Praxisalltag
Wer heute ein quantisiertes Modell herunterlädt, begegnet meist GGUF: ein Binärformat, das Tensoren und Metadaten gemeinsam speichert und auf schnelles Laden optimiert ist [10]. Es stammt von Georgi Gerganov, dem Entwickler von llama.cpp, und wird von llama.cpp, LM Studio, GPT4All und Ollama gelesen [10]. Die Dokumentation listet die Quantisierungstypen von F16 über Q8_K bis zu den 2-Bit-Varianten; bei Q8_K etwa trägt jeder Block 256 Gewichte [10]. Auf Hugging Face lassen sich Modelle gezielt nach dem GGUF-Tag filtern, und mit dem Werkzeug ggml-org/gguf-my-repo wandelt man eigene Gewichte um [10].
Praktisch heißt das: Die Verfahren aus den Papers stecken längst in Standardwerkzeugen. Wer ein Modell für den eigenen Rechner sucht, wählt zwischen den GGUF-Stufen; wer feintunen will, nutzt QLoRA über gängige Bibliotheken; wer auf einem Server Durchsatz braucht, greift zu AWQ- oder GPTQ-Artefakten in den Inferenz-Frameworks. Die Forschungsnamen verschwinden dabei hinter Abkürzungen in Dateinamen, die Mechanik bleibt dieselbe.
Geschwindigkeit: Was die gemeldeten Tempogewinne bedeuten
Die Papers berichten Beschleunigungen zwischen 1,15x und 4,5x gegenüber FP16 [2][3][4][6]. Die folgende Grafik stellt sie nebeneinander, mit einer ausdrücklichen Warnung: Die Messungen stammen von unterschiedlicher Hardware (A100, A6000, RTX 4090, Jetson Orin), mit unterschiedlichen Modellen und Implementierungen. Sie sind keine Rangliste, sondern zeigen die Größenordnung des Möglichen.
Daten als Tabelle
| Verfahren und Hardware | Tempogewinn |
|---|---|
| GPTQ (A100) | 3,25x |
| GPTQ (A6000) | 4,5x |
| SmoothQuant | 1,56x |
| AWQ/TinyChat (4090) | 2,87x |
| SpQR | 1,15x |
Quelle: Paperangaben [2][3][4][6], eigene Rechnung
Angaben der Papers [2][3][4][6]; der AWQ-Wert ist eine eigene Rechnung aus der TinyChat-Tabelle (168,1 / 58,5). Unterschiedliche Hardware und Modelle, keine Rangliste.
Warum die Unterschiede so groß ausfallen, lässt sich ohne neue Messungen erklären: Inferenz ist bei der Textgenerierung meist speicherbandbreitenbegrenzt, jede Sekunde müssen die Gewichte einmal aus dem Speicher zur Recheneinheit wandern. Vierfache Kompression kann daher bis zu vierfache Geschwindigkeit bedeuten, aber nur, wenn das Entpacken der Werte nicht selbst zum Flaschenhals wird. Genau das sieht man bei GPTQ: aus 4,0-facher Kompression werden 3,25x gemessen (eigene Rechnung der Verhältnisse). Auf schwächerer Hardware wie der A6000 fällt der Speicherflaschenhals enger aus, darum wächst der relative Gewinn dort auf 4,5x [2].
Die eigenen Rechnungen im Überblick
- Speicher der Gewichte: Parameter mal Bit geteilt durch 8. Ein 70-Milliarden-Modell: 140 GB (FP16), 70 GB (8 Bit), 35 GB (4 Bit), 17,5 GB (2 Bit), 13,8 GB (1,58 Bit).
- Overhead der Gruppenskalierung: 16-Bit-Skala pro 128 Gewichte kostet 0,125 Bit pro Gewicht; aus 4 Bit werden 4,125 Bit, aus 35,0 GB werden 36,1 GB (plus 3,2 Prozent).
- Kompression gegen Speedup bei GPTQ: 4,0-fache Kompression der Gewichte, 3,25x gemessene Beschleunigung auf A100; die Differenz steckt in Entpacklogik, Aktivierungen und KV-Cache.
- QLoRA-Plausibilität: 65 Mrd. Parameter in 4 Bit sind 32,5 GB und passen mit Adaptern und Puffern auf eine 48-GB-GPU.
- SpQR-Plausibilität: 33 Mrd. Parameter bei etwa 3,5 Bit sind 14,4 GB und passen mit Reserve auf eine 24-GB-Karte.
- AWQ-Tempo: 168,1 geteilt durch 58,5 Tokens pro Sekunde ergibt 2,87x auf der RTX 4090.
Drei häufige Missverständnisse
Erstens: Quantisierung ist weder Destillation noch Pruning. Destillation trainiert ein kleineres Modell auf die Ausgaben eines großen, Pruning entfernt Teile des Netzes, Quantisierung behält Struktur und Gewichte und ändert nur deren Zahlenformat. Die Verfahren lassen sich kombinieren, sind aber verschiedene Werkzeuge.
Zweitens: Halbe Bitzahl heißt nicht halbe Qualität und nicht doppeltes Tempo. Die Genauigkeit hängt davon ab, wie gut ein Verfahren mit Ausreißern umgeht: 4 Bit mit GPTQ oder AWQ schlagen 8 Bit mit naiver Rundung. Und das Tempo hängt an der Speicherbandbreite des Gesamtsystems, nicht am Kompressionsfaktor allein, wie der Vergleich von 4,0-facher Kompression und 3,25-fach gemessenem Tempo bei GPTQ zeigt [2].
Drittens: „Quantisiert" ist kein Gütesiegel. Zwei Dateien mit derselben Bitangabe können sich stark unterscheiden, je nach Verfahren, Gruppengröße, Kalibrierungsdaten und davon, ob der KV-Cache mitquantisiert ist. Die Angabe „4-Bit" auf einer Modellkarte sagt ohne diese Kontextdaten fast nichts über die zu erwartende Qualität aus.
Grenzen und offene Fragen
Erstens das Messproblem. Perplexity auf WikiText-2 ist der gemeinsame Nenner aller Papers, aber sie beantwortet nicht, ob ein quantisiertes Modell noch sauberen Code schreibt oder mehrschrittig folgerichtig denkt. QLoRA warnt explizit, dass gängige Chatbot-Benchmarks unzuverlässig seien [5]. Wer ein quantisiertes Modell produktiv einsetzt, sollte auf den eigenen Aufgaben nachmessen.
Zweitens die Kalibrierung. Fast alle Verfahren brauchen Beispieldaten, um Skalen oder Codebücher zu bestimmen. Der AWQ-Vergleich zeigt, wie empfindlich das sein kann: falsche Domäne kostet GPTQ mehrere Perplexity-Punkte, AWQ nur Bruchteile [4]. QuaRot umgeht das Problem in 6 und 8 Bit ganz ohne Kalibrierung, für 4 Bit aber nicht [8].
Drittens der KV-Cache. Mit wachsenden Kontextfenstern verschiebt sich der Speicherdruck von den Gewichten zum Cache. QuaRot adressiert ihn mit 4 Bit [8]; aktuelle Modelle wie DeepSeek V4.1 Flash gehen im Betrieb bereits zu FP4-Caches über. Wer heute eine Langkontext-Anwendung plant, sollte auf beide Zahlen achten: Gewichte und Cache.
Viertens die Frage, ab welcher Bitzahl sich Kompression überhaupt noch lohnt. Unter 2 Bit fallen auch die besten Verfahren sichtbar ab; BitNet b1.58 umgeht das nur, weil das Modell von Anfang an so trainiert wurde [9]. Die Grenze zwischen „nachträglich tragbar" und „muss mittrainiert werden" liegt nach heutigem Stand irgendwo zwischen 3 und 2 Bit.
Welches Verfahren für welchen Zweck
| Vorhaben | Naheliegende Wahl | Warum |
|---|---|---|
| Bestehendes Modell auf einer GPU betreiben | GPTQ oder AWQ (4 Bit) | Ausgereift, breite Werkzeugunterstützung, viertelt den Speicher |
| Keine passenden Kalibrierungsdaten | AWQ | Verzeiht fremde Domänen deutlich besser (0,5-0,6 statt 2,3-4,9 Perplexity-Punkte) [4] |
| Modell feintunen auf einer GPU | QLoRA | 65 Mrd. Parameter auf 48 GB, volle 16-Bit-Feintuning-Qualität [5] |
| Lokaler Betrieb auf Laptop oder Edge-Gerät | GGUF-Artefakte über llama.cpp/Ollama | Format und Werkzeuge sind dafür gebaut [10] |
| Maximale Kompression unter 3 Bit | SpQR oder AQLM | Referenzverfahren für 2- bis 3,5-Bit mit kleinsten Verlusten [6][7] |
| Langer Kontext, Cache im Blick | Verfahren mit KV-Cache-Quantisierung (QuaRot) | Erst Verfahren dieser Art drücken den wachsenden Cache [8] |
| Neues Modellprojekt von Grund auf | BitNet-Architektur prüfen | Ternäre Gewichte ohne nachträgliche Kompression [9] |
Zum Abschluss die nüchterne Zusammenfassung: 8 Bit sind gelöst, 4 Bit sind Alltag, 2 Bit sind Forschungsfront mit brauchbaren Ergebnissen, und 1,58 Bit sind ein Architekturversprechen. Wer nur merken will, welche Zahl auf der Modellkarte zählt: Bits pro Gewicht mal Parameter geteilt durch acht ist der Speicher, und alles andere ist Verhandlungssache zwischen Genauigkeit, Tempo und Aufwand.
Methode
Gelesen wurden am 20. Oktober 2026 die arXiv-Seiten der neun genannten Verfahren, bei LLM.int8(), GPTQ, SmoothQuant und AWQ einschließlich der dort eingebetteten Papiertexte, sowie die GGUF-Dokumentation von Hugging Face. Alle Umrechnungen von Bitzahl in Speicherbedarf, alle Overhead-Rechnungen und die Quotienten aus den TinyChat-Durchsatztabellen sind eigene Überschläge und im Text gekennzeichnet. Wir haben keines der Verfahren selbst ausgeführt. Der Text entstand mit KI-Unterstützung und wurde von der Redaktion verantwortet.
Grenzen
Alle Genauigkeits- und Geschwindigkeitszahlen stammen aus den Papers der jeweiligen Autoren, auf deren Hardware und mit deren Testdaten; sie sind nicht unabhängig reproduziert. Perplexity als Maß sagt wenig über einzelne Fähigkeiten aus. Die Auswahl der Verfahren ist redaktionell und nicht vollständig; neuere Arbeiten (etwa zu FP4-Formaten) sind nicht Teil dieser Übersicht. Die GGUF-Formatliste wurde nur auszugsweise gelesen. Keine eigenen Messungen.
Quellen
- LLM.int8(): 8-bit Matrix Multiplication for Transformers at Scale, arXiv:2208.07339 (Dettmers u. a., NeurIPS 2022) (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers, arXiv:2210.17323 (Frantar u. a., ICLR 2023) (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- SmoothQuant: Accurate and Efficient Post-Training Quantization for Large Language Models, arXiv:2211.10438 (Xiao u. a., MIT HAN Lab) (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- QLoRA: Efficient Finetuning of Quantized LLMs, arXiv:2305.14314 (Dettmers u. a., NeurIPS 2023) (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- AWQ: Activation-aware Weight Quantization for LLM Compression and Acceleration, arXiv:2306.00978 (Lin u. a., MLSys 2024, Best Paper) (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- SpQR: A Sparse-Quantized Representation for Near-Lossless LLM Weight Compression, arXiv:2306.03078 (Dettmers u. a.) (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- Extreme Compression of Large Language Models via Additive Quantization (AQLM), arXiv:2401.06118 (Egiazarian u. a., ICML 2024) (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- QuaRot: Outlier-Free 4-Bit Inference in Rotated LLMs, arXiv:2404.00456 (Ashkboos u. a.) (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- The Era of 1-bit LLMs: All Large Language Models are in 1.58 Bits (BitNet b1.58), arXiv:2402.17764 (Ma u. a., Microsoft Research) (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- GGUF (Dokumentation), Hugging Face (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4 ↩5