 KI
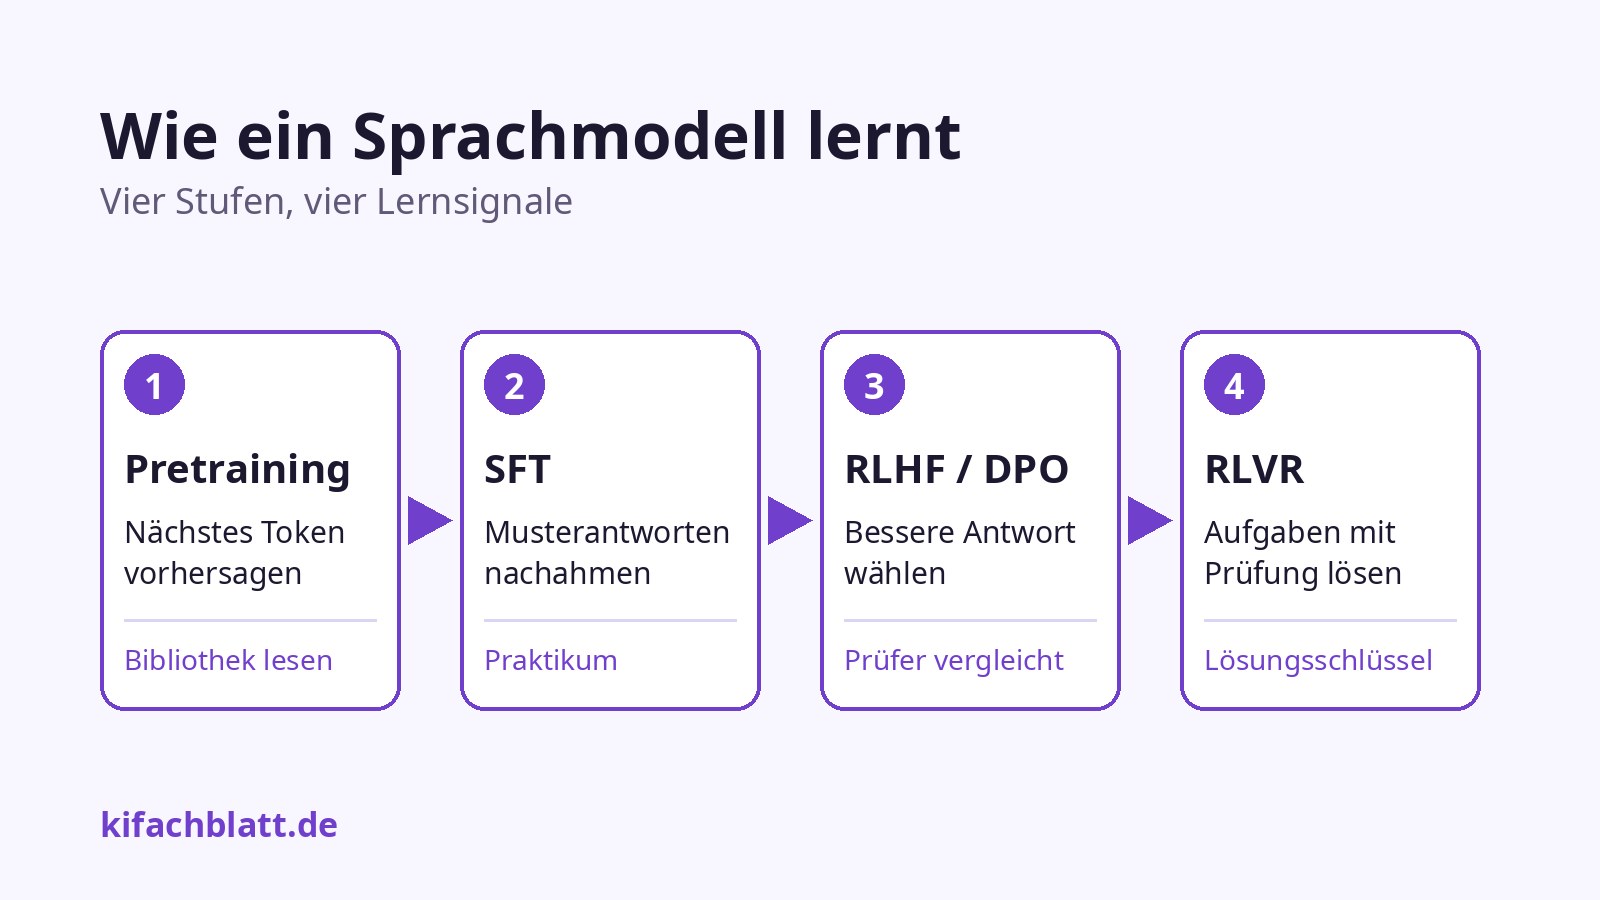
Ein Sprachmodell wird nicht in einem Rutsch „klug“. Es durchläuft Stufen, und jede Stufe löst ein anderes Problem. Erst lernt es Sprache und Weltwissen, dann lernt es, wie ein Assistent zu antworten, dann, welche Antworten Menschen besser finden, und zuletzt, Aufgaben zu lösen, deren Ergebnis sich automatisch prüfen lässt. Wer diese Reihenfolge kennt, versteht, warum Modelle mit gleicher Größe so unterschiedlich wirken und was Begriffe wie RLHF, DPO oder RLVR in Modellkarten bedeuten.
Dieser Text erklärt die vier Stufen ohne Vorwissen. Jede bekommt eine Alltagsanalogie, die Zahlen stammen aus den Originalpapieren, und eigene Rechnungen sind als solche markiert.
Stufe 1: Pretraining, das große Lesen
Im Pretraining (Vortraining) sieht das Modell riesige Textmengen und soll immer nur eines tun: das nächste Token vorhersagen. Aus „Der Himmel ist“ soll „blau“ wahrscheinlicher werden als „Kartoffel“. Dabei muss es Grammatik, Fakten, Stil und Zusammenhänge verinnerlichen, denn nur wer sie kennt, rät gut. Meta beschreibt diese Stufe für Llama 3 so: Das Modell lerne die Struktur der Sprache und viel Wissen über die Welt aus dem Text, den es „liest“ [3].
Das Ergebnis heißt Basismodell. Es kann Texte fortsetzen, aber es ist noch kein Assistent. Eine Frage beantwortet es nicht zuverlässig, es setzt den Text eher fort. Meta sagt dazu: Das vortrainierte Modell habe ein reiches Sprachverständnis, folge aber noch nicht Anweisungen und verhalte sich nicht wie ein Assistent [3].
Wie groß ist „groß“?
Das größte Llama-3-Modell hat 405 Milliarden Parameter und wurde mit 15,6 Billionen Token vortrainiert. Der Rechenaufwand lag bei 3,8 × 10²⁵ Gleitkommaoperationen, fast 50-mal so viel wie beim größten Llama-2-Modell [3]. Teilt man die Tokenzahl durch die Parameterzahl, kommt man auf rund 38,5 Token pro Parameter (eigene Rechnung: 15,6 Billionen geteilt durch 405 Milliarden).
Zur Plausibilitätsprüfung eine zweite eigene Rechnung mit der gängigen Faustformel „Rechenaufwand ≈ 6 × Parameter × Token“ (die Formel stammt nicht aus den hier gelesenen Quellen): 6 × 405 Milliarden × 15,6 Billionen ergibt etwa 3,8 × 10²⁵ und deckt sich mit der Angabe von Meta.
Mehr Daten oder größeres Modell? Die Skalierungsgesetze
Die Forschung zu Scaling Laws fand 2020, dass der Fehler (die Cross-Entropy-Loss) wie ein Potenzgesetz mit Modellgröße, Datenmenge und Rechenaufwand sinkt, über mehr als sieben Größenordnungen hinweg. Architekturdetails wie Breite oder Tiefe spielen innerhalb eines weiten Bereichs kaum eine Rolle [1].
2022 korrigierte DeepMind den Rat zur Verteilung des Budgets. Die Chinchilla-Studie trainierte über 400 Modelle und kam zu dem Ergebnis, dass Modellgröße und Tokenzahl gleich schnell wachsen sollten: Verdoppelt man das Modell, sollte man auch die Daten verdoppeln. Das 70-Milliarden-Modell Chinchilla, mit vierfacher Datenmenge bei gleichem Rechenbudget wie das 280-Milliarden-Modell Gopher trainiert, schlug Gopher, GPT-3, Jurassic-1 und Megatron-Turing NLG in einer breiten Auswahl von Aufgaben [2]. Mehr dazu im Glossar unter Chinchilla-Skalierung.
Meta geht für Llama 3 einen Schritt weiter. Das Flaggschiff liege ungefähr bei der rechnerisch optimalen Größe für das Budget, die kleineren Modelle trainiere man aber „viel länger, als es compute-optimal wäre“. Sie seien dadurch bei gleichem Inferenzbudget besser als compute-optimale Modelle [3]. Das ist die wichtigste Verbindung zur Praxis: Wer ein Modell millionenfach betreibt, zahlt die Laufzeit viel öfter als das Training und lässt es lieber länger lernen. Wie die Laufzeitkosten entstehen, erklärt unsere Seite Inferenz und Kosten verstehen.
Stufe 2: Supervised Fine-Tuning, das Praktikum
Supervised Fine-Tuning (SFT) zeigt dem Basismodell Beispiele für gutes Verhalten: eine Anweisung und eine Musterantwort, geschrieben von Menschen oder (zunehmend) von anderen Modellen. Das Modell lernt, diese Antworten nachzuahmen. Das Prinzip heißt auch Instruction Tuning. Aus dem Textfortsetzer wird ein Gesprächspartner, der Anweisungen als Aufträge versteht.
Im InstructGPT-Papier von OpenAI sammelten Labeler (Beschriftende) zunächst Demonstrationen des gewünschten Verhaltens, und GPT-3 wurde damit per überwachtem Lernen nachtrainiert. Erst danach folgte die Stufe mit menschlichem Feedback [4]. SFT hat eine Grenze: Das Modell kann nur nachahmen, was in den Beispielen steht. Was „besser“ heißt, wenn mehrere Antworten möglich sind, sagen Beispiele schlecht.
Ein bekanntes Risiko beim Nachtrainieren ist das Vergessen früher gelernter Fähigkeiten, im Glossar unter Catastrophic Forgetting erklärt.
Stufe 3: Präferenzen lernen mit RLHF und DPO
Bei offenen Fragen gibt es keine einzige richtige Antwort, aber meist erkennt ein Mensch schnell, welche von zwei Antworten besser ist. Genau das nutzen RLHF (Reinforcement Learning from Human Feedback) und DPO (Direct Preference Optimization). Das Ziel nennt man Alignment: Das Modell soll das tun, was die Nutzer wollen, und dabei wahrheitsgemäß und harmlos bleiben.
RLHF: erst Prüfer bauen, dann üben
InstructGPT zeigt den klassischen Ablauf in drei Schritten. Erst Demonstrationen für SFT. Dann Menschen, die mehrere Modellantworten auf dieselbe Frage nach Qualität ordnen. Aus diesen Rangfolgen entsteht ein zweites Modell, das Belohnungsmodell, das Antworten mit einer Punktzahl bewertet. Zuletzt wird das Sprachmodell mit Verstärkungslernen darauf trainiert, höhere Punktzahlen zu erzielen [4]. Die Analogie: Ein Prüfer lernt aus Hunderten Vergleichen, was die Menschen mögen, und gibt dann dem Schüler bei jeder Übungsantwort sofort eine Note.
Das Ergebnis war deutlich: In Bewertungen durch Menschen zogen die Prüfer die Antworten des 1,3 Milliarden Parameter kleinen InstructGPT denen des 175 Milliarden großen GPT-3 vor, trotz hundertfach weniger Parametern. Wahrhaftigkeit stieg, giftige Ausgaben sanken [4]. Die Autoren betonen selbst, dass das Modell weiter einfache Fehler macht [4].
DPO: den Umweg über den Prüfer sparen
RLHF gilt als aufwendig und instabil: erst ein Belohnungsmodell anpassen, dann Verstärkungslernen, bei dem das Modell nicht zu weit vom Ausgangspunkt abdriften soll. Die DPO-Autoren zeigen, dass sich dasselbe Ziel mit einer einfachen Klassifikationsverlustfunktion lösen lässt. Man gibt dem Modell Paare aus „besser“ und „schlechter“, und es lernt direkt, die bessere Antwort wahrscheinlicher zu machen. Während des Feintunings muss das Modell dafür keine eigenen Antworten erzeugen und kaum Hyperparameter austarieren [5]. Nach ihren Experimenten hält DPO mit PPO-basiertem RLHF mit oder übertrifft es, bei deutlich einfacherer Umsetzung [5].
In der Praxis ist das verbreitet: Meta richtet Llama 3 in mehreren Runden mit SFT auf Instruktionsdaten und DPO aus [3]. Das offene Tülu-3-Rezept nutzt SFT, DPO und eine dritte, neuere Methode [6].
Stufe 4: RLVR, Üben mit Lösungsschlüssel
Bei Matheaufgaben, Programmierwettbewerben oder Logikrätseln braucht es keinen menschlichen Prüfer. Das Ergebnis lässt sich automatisch kontrollieren: Stimmt die Zahl, laufen die Tests durch? Das Tülu-3-Team nennt die Methode Reinforcement Learning with Verifiable Rewards (RLVR) und führt sie als neuen Baustein neben SFT und DPO ein [6]. Die Belohnung kommt hier nicht aus einer Präferenz, sondern aus einer Prüfung mit eindeutigem Ergebnis.
Die bekannteste Anwendung ist DeepSeek-R1. Die Autoren berichten, dass sich Denkfähigkeit durch reines Verstärkungslernen anregen lässt, ohne von Menschen beschriftete Lösungswege. Dabei seien Muster wie Selbstreflexion, Überprüfung und das Wechseln der Strategie von allein entstanden. Die besten Ergebnisse gebe es bei überprüfbaren Aufgaben wie Mathematik, Wettbewerbsprogrammierung und MINT-Fächern [8]. Verwandt ist das Stichwort Reasoning-Modell: Solche Modelle schreiben lange Zwischenschritte, bevor sie antworten.
Technisch nutzt DeepSeek dafür das Verfahren GRPO (Group Relative Policy Optimization), das DeepSeekMath eingeführt hat. Es verzichtet auf das zweite große Hilfsmodell, den „Critic“ des PPO-Verfahrens, und schätzt die Vergleichsbasis aus den Punktzahlen einer Gruppe von Antworten auf dieselbe Aufgabe. Das spart laut den Autoren erheblich Trainingsressourcen [7]. Analogie: Statt einen Lehrer für jede Antwort zu bezahlen, vergleicht man eine Gruppe von Versuchen und belohnt die überdurchschnittlichen.
Alle Stufen im Überblick
| Stufe | Was das Modell lernt | Lernsignal | Analogie |
|---|---|---|---|
| Pretraining | Sprache, Wissen, Muster | Nächstes Token in riesigen Textmengen | Jahrelang in einer Bibliothek lesen |
| SFT | Anweisungen befolgen, Antwortformat | Musterantworten von Menschen oder Modellen | Praktikum mit Musterlösungen |
| RLHF / DPO | Welche Antwort Menschen besser finden | Vergleichspaare (besser, schlechter) | Prüfer vergleicht zwei Antworten |
| RLVR | Aufgaben lösen, die sich prüfen lassen | Automatische Prüfung (Ergebnis, Tests) | Übungsaufgaben mit Lösungsschlüssel |
Was das für Modellkarten und Vergleiche heißt
- Steht in einer Modellkarte nur „Base“, hat das Modell vermutlich nur Stufe 1 hinter sich und folgt Anweisungen unzuverlässig. „Instruct“ oder „Chat“ weist auf Stufe 2 und 3 hin.
- Zwei Modelle mit gleicher Parameterzahl können sich stark unterscheiden, weil Datenmenge, Datenqualität und Nachtraining sich unterscheiden. Parameter sind nur eine von drei Stellgrößen [1][2].
- Ein kleines, lange trainiertes Modell kann im Betrieb günstiger sein als ein großes, das gerade eben rechnerisch optimal trainiert wurde [3].
- Begriffe wie RLVR oder GRPO deuten auf Denkmodelle hin, die vor der Antwort lange nachdenken und deshalb mehr Token verbrauchen. Das schlägt sich in Preis und Wartezeit nieder; siehe Inferenz und Kosten verstehen.
- Wer ein offenes Modell selbst anpassen will, setzt meist bei Stufe 2 an, etwa mit LoRA oder QLoRA. Die Speicherfrage dazu beantwortet unser Beitrag zur Quantisierung.
Häufige Missverständnisse
- „Das Modell schlägt Fakten nach.“ Nein, Pretraining legt Wissen in den Parametern ab. Ohne zusätzliche Suche gibt es keine Quellenprüfung zur Laufzeit; deshalb entstehen Halluzinationen.
- „RLHF macht ein Modell wahrhaftig.“ Es verbessert Wahrhaftigkeit in Tests, aber nicht auf null; InstructGPT macht laut seinen Autoren weiter einfache Fehler [4].
- „Mehr Parameter heißt immer besser.“ Chinchilla zeigt das Gegenteil bei fester Rechenmenge: Ein kleineres Modell mit mehr Daten gewann [2].
Methode
Gelesen wurden am 20. Oktober 2026 die arXiv-Seiten (Abstracts) von Kaplan u. a., Chinchilla, InstructGPT, DPO, Tülu 3, DeepSeekMath und DeepSeek-R1 sowie Teile des Llama-3-Berichts (Einleitung, Architektur, Skalierungsgesetze). Die Verhältnisse und die Plausibilitätsrechnung mit 6 × Parameter × Token sind eigene Überschlagsrechnungen und im Text gekennzeichnet. Der Text entstand mit KI-Unterstützung und wurde von der Redaktion verantwortet.
Grenzen
Von InstructGPT, DPO, Tülu 3, DeepSeekMath und DeepSeek-R1 wurden die Abstracts gelesen, nicht die Volltexte; Details zu Verfahren, Datenmengen und Ergebnissen in den Papieren können über das Berichtete hinausgehen. Die Praxis kommerzieller Modelle (OpenAI, Anthropic, Google) ist nur teilweise öffentlich, die Stufen sind hier an Papieren und offenen Modellen erklärt. Die Analogien vereinfachen bewusst.
Quellen
- Scaling Laws for Neural Language Models, arXiv:2001.08361 (Kaplan u. a., 2020) (abgerufen 2026-10-20) ↩1 ↩2
- Training Compute-Optimal Large Language Models, arXiv:2203.15556 (Hoffmann u. a., DeepMind, 2022) (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4
- The Llama 3 Herd of Models, arXiv:2407.21783 (Meta, 2024) (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- Training language models to follow instructions with human feedback, arXiv:2203.02155 (Ouyang u. a., OpenAI, 2022) (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- Direct Preference Optimization: Your Language Model is Secretly a Reward Model, arXiv:2305.18290 (Rafailov u. a., 2023) (abgerufen 2026-10-20) ↩1 ↩2 ↩3
- Tulu 3: Pushing Frontiers in Open Language Model Post-Training, arXiv:2411.15124 (Lambert u. a., Allen Institute for AI) (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4
- DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models, arXiv:2402.03300 (Shao u. a., DeepSeek) (abgerufen 2026-10-20) ↩
- DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning, arXiv:2501.12948 (DeepSeek-AI) (abgerufen 2026-10-20) ↩1 ↩2 ↩3