KI
Grundlagen
Inferenz und Kosten verstehen: Tokens, KV-Cache, Quantisierung
Was beim Antworten passiert, warum der KV-Cache so viel Speicher frisst und woraus sich ein API-Preis ergibt, mit eigenen Rechnungen zu Llama 3.
Lesen →
Was beim Antworten passiert, warum der KV-Cache so viel Speicher frisst und woraus sich ein API-Preis ergibt, mit eigenen Rechnungen zu Llama 3.
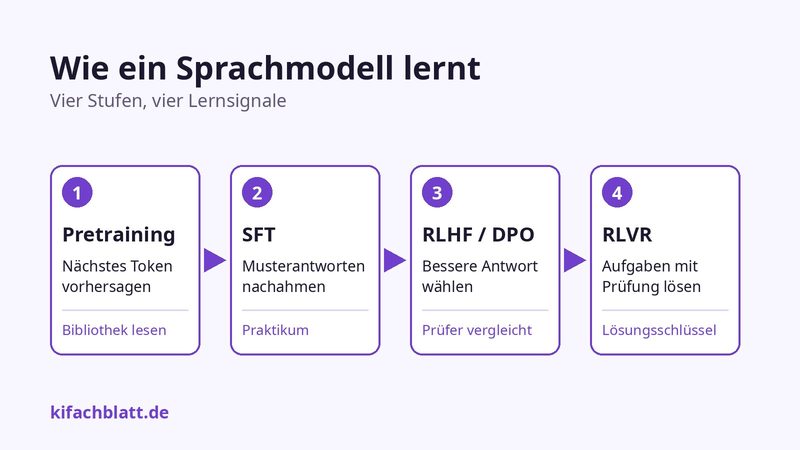
Pretraining, SFT, RLHF, DPO und RLVR einfach erklärt: Was jede Stufe leistet, warum Modelle so verschieden wirken und was die Begriffe in Modellkarten bedeuten.
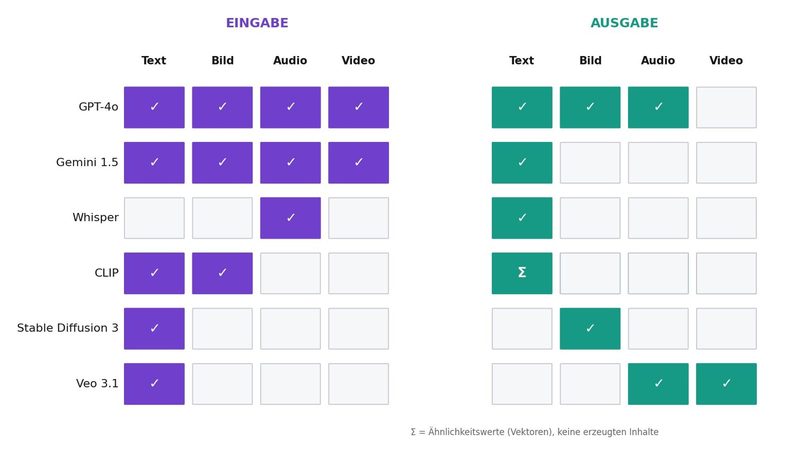
Multimodal klingt nach eierlegender Wollmilchsau. Die Matrix zeigt, welche Modelle Text, Bild, Audio und Video tatsächlich einlesen, und was sie ausgeben.
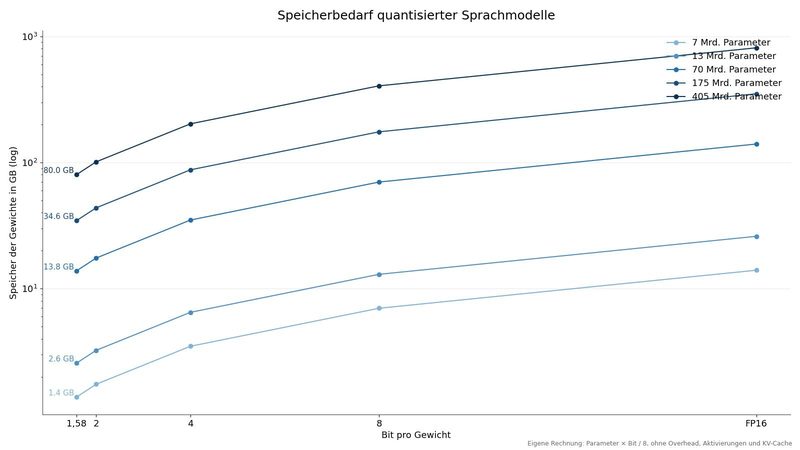
Wie viel Speicher 4 Bit pro Gewicht wirklich sparen, welche Verfahren von LLM.int8() bis BitNet b1.58 was taugen und wo die Grenzen liegen.
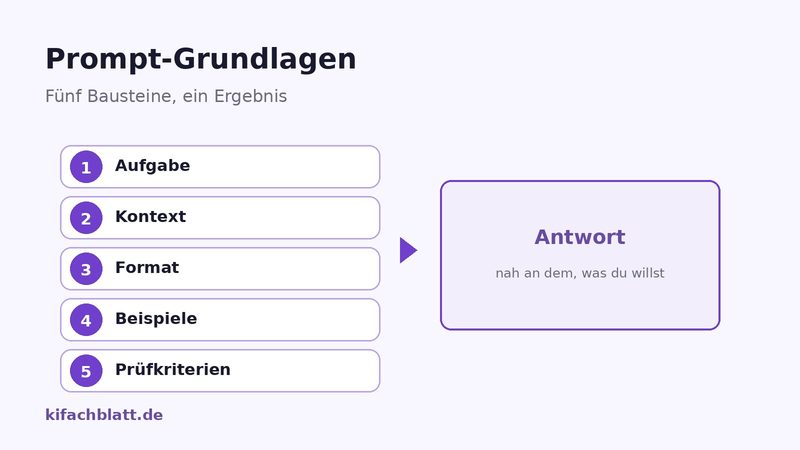
Was ein Prompt ist, aus welchen Bausteinen gute Anweisungen bestehen, was Few-Shot bedeutet und warum Iteration wichtiger ist als der perfekte erste Satz.
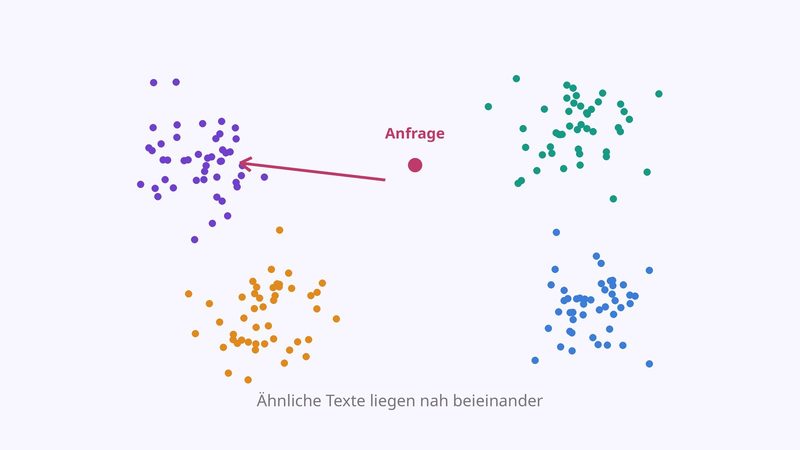
Wie aus Wörtern und Sätzen Zahlenreihen werden, was Kosinus-Ähnlichkeit misst, wie HNSW und FAISS Millionen von Vektoren durchsuchen und was MTEB verrät.
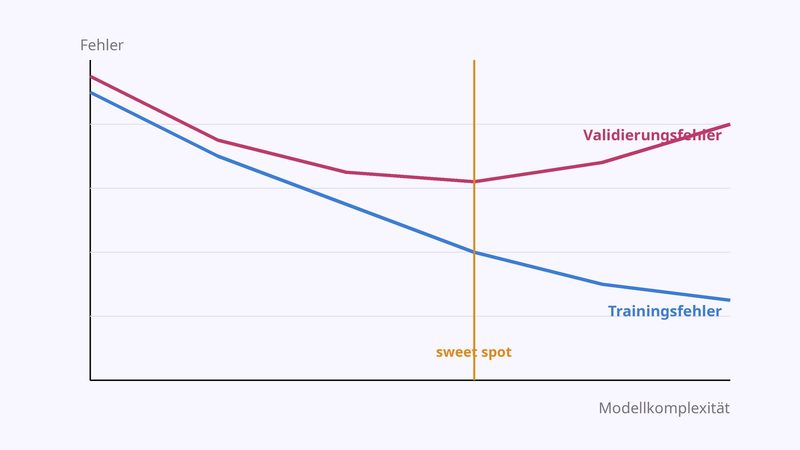
Trainings-, Validierungs- und Testdaten, warum Modelle auswendig lernen statt zu verstehen und wie Kreuzvalidierung die Leistung auf neuen Fällen schätzt.
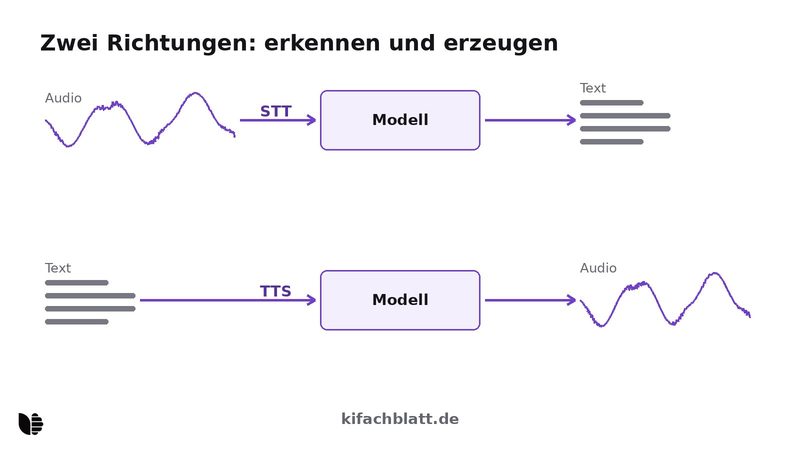
Wie Maschinen Sprache in Text verwandeln und umgekehrt, was hinter Stimmklonen steckt und wo Grenzen und Risiken liegen - von Whisper bis ElevenLabs.
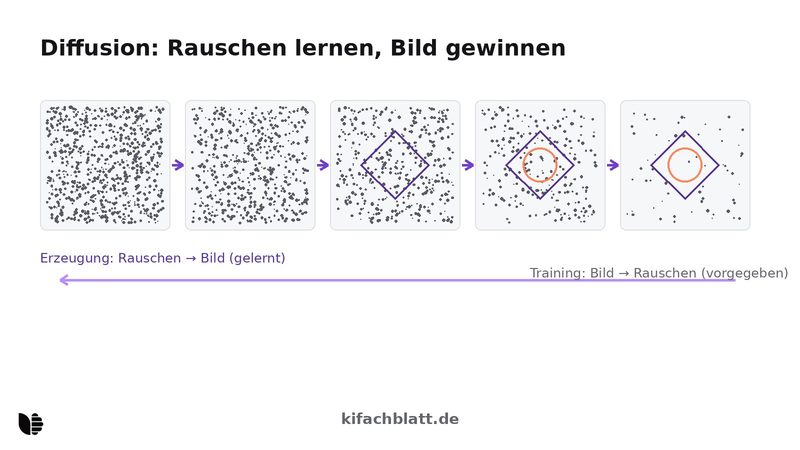
Vom Rauschen zum Bild: Wie Diffusionsmodelle Text in Bilder übersetzen, was ein Bild-Tokenizer tut und warum die Modelle Stile können, aber nichts verstehen.