 KI
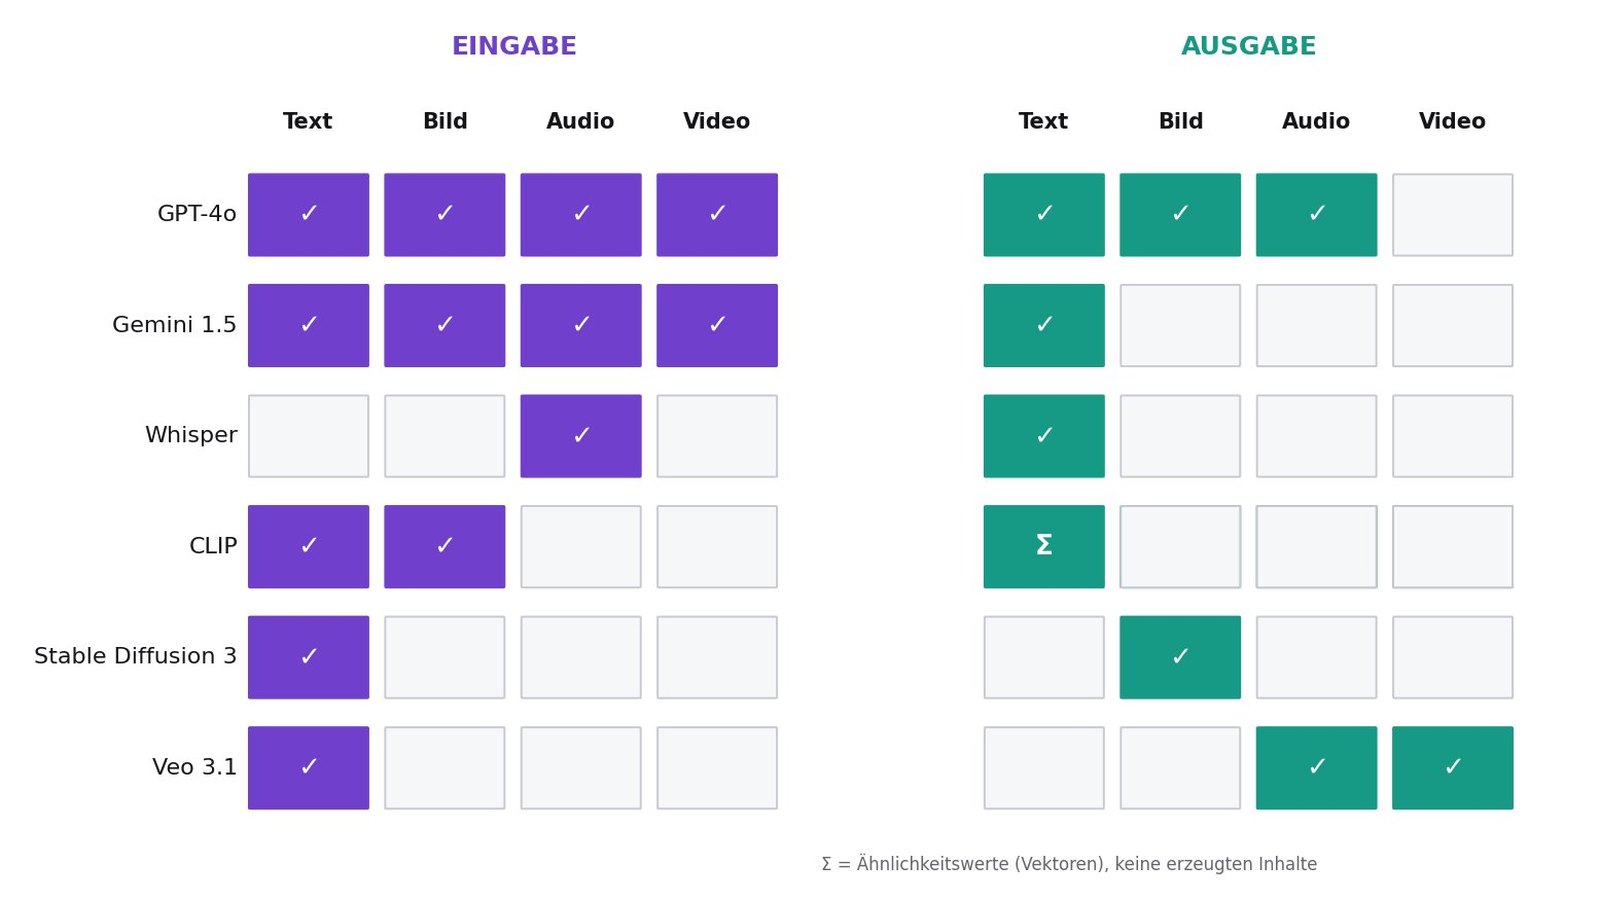
Wer KI-Modelle vergleichen will, stolpert früh über das Wort „multimodal“. Es verspricht, ein Modell könne alles: lesen, sehen, hören, sprechen, zeichnen. In Wahrheit steckt dahinter eine einfache, aber selten klar beantwortete Frage: Welche Datentypen gehen hinein, und welche kommen heraus? Diese Seite legt die Antwort als Matrix an: sechs bekannte Modelle, vier Datentypen, zwei Richtungen. Jede Zeile ist mit der Originalquelle belegt, jede Zelle wurde gegen die Anbieterangabe oder das Paper geprüft.
Was eine Modalität ist
Modalität meint den Datentyp einer Information: Text, Bild, Audio, Video. Der Begriff klingt akademisch, beschreibt aber etwas Alltägliches, nämlich den Unterschied zwischen einem Brief, einem Foto, einer Sprachnachricht und einem Film. Ein Modell, das mehrere dieser Typen verarbeitet, heißt multimodal. Dabei zählen zwei Richtungen getrennt: die Eingabe, was das Modell verstehen kann, und die Ausgabe, was es erzeugen kann. Beides zusammen ergibt die ehrliche Antwort auf „Was kann das Modell?“.
Intern wird jede Modalität zuerst in Zahlen übersetzt. Text wird zu Tokens, Bilder werden in Patches zerlegt oder als verdichtete Latenzen verarbeitet (der Bild-Tokenizer leistet das), Audio landet als Spektrogramm oder Audio-Token im Modell. Erst nach dieser Übersetzung kann dieselbe Art von Netz alle Typen verarbeiten, meist ein Transformer. Deshalb ist Multimodalität weniger Magie als Übersetzungsarbeit am Eingang und Ausgang.
Die Matrix
| Modell | Eingabe | Ausgabe | Quelle |
|---|---|---|---|
| GPT-4o (OpenAI) | Text, Bild, Audio, Video | Text, Audio, Bild | [1] |
| Gemini 1.5 Pro / Flash (Google) | Text, Bild, Audio, Video | Text | [2] |
| Whisper (OpenAI) | Audio | Text | [3] |
| CLIP (OpenAI) | Text und Bild (gepaart) | Ähnlichkeitswerte, keine Inhalte | [4] |
| Stable Diffusion 3 (Stability AI) | Text | Bild | [5] |
| Veo 3.1 (Google DeepMind) | Text | Video mit Audio | [6] |
Drei Zeilen fallen auf. Erstens GPT-4o: OpenAI beschreibt es als ein einziges Modell, das „jede Kombination aus Text, Audio, Bild und Video“ als Eingabe akzeptiert und „jede Kombination aus Text, Audio und Bild“ ausgibt. Die Mindest-Antwortzeit auf Sprache liegt bei 232 Millisekunden, im Schnitt bei 320, in etwa menschlichem Gesprächstempo [1]. Zweitens Gemini 1.5: Es verarbeitet nach dem technischen Bericht Millionen von Tokens Kontext, einschließlich mehrerer langer Dokumente und „Stunden von Video und Audio“. Als Demonstration lernte es aus einem Grammatikbuch im Kontext, Englisch in die Sprache Kalamang zu übersetzen, die weniger als 200 Sprecher hat. Die Ausgabe bleibt aber Text [2]. Drittens CLIP: Es erzeugt gar nichts, sondern misst nur, wie gut ein Text zu einem Bild passt, gelernt aus 400 Millionen Bild-Text-Paaren aus dem Netz [4].
Die Spezialisten komplettieren das Bild. Whisper ist ein reines Speech-to-Text-Modell, trainiert mit 680.000 Stunden mehrsprachiger, schwach überwachter Audiodaten, und erreicht laut Paper ohne aufgabenspezifisches Feintuning Ergebnisse nahe menschlicher Genauigkeit [3]. Stable Diffusion 3 geht den umgekehrten Weg vom Text zum Bild und nutzt dafür eine Transformer-Architektur, in der Text- und Bildinformationen bidirektional fließen, was unter anderem die Typografie in erzeugten Bildern verbesserte [5]. Veo 3.1 schließlich erzeugt aus Textanweisungen Videos, in der aktuellen Version mit nativem Ton [6].
- Eingabe
- Ausgabe
Daten als Tabelle
| Modell | Eingabe | Ausgabe |
|---|---|---|
| GPT-4o | 4 | 3 |
| Gemini 1.5 | 4 | 1 |
| Whisper | 1 | 1 |
| CLIP | 2 | 1 |
| SD 3 | 1 | 1 |
| Veo 3.1 | 1 | 2 |
Quelle: Eigene Zählung aus den Quellen [1] bis [6]; CLIP-Ausgabe als ein Kanal (Embeddings) gezählt.
Anzahl der Modalitäten pro Richtung und Modell, gezählt aus den Quellen [1] bis [6]. Nur GPT-4o erzeugt mehr als einen Datentyp; bei Gemini 1.5, Whisper, CLIP und Stable Diffusion 3 bleibt die Ausgabe auf einen Kanal beschränkt.
Ein Modell für alles oder viele Spezialisten?
Hinter der Matrix steckt ein Richtungsstreit. Der eine Weg baut ein einziges Modell, das alle Typen intern verarbeitet, GPT-4o ist das Referenzbeispiel: Dieselbe Maschine hört eine Frage, sieht ein Foto und antwortet mit Stimme [1]. Der andere Weg kettet Spezialisten: Ein Modell transkribiert, eines versteht, eines spricht. Solche Ketten funktionieren, verlieren aber an den Übergaben Nuancen, etwa Ironie in der Stimme oder Zögern. OpenAI begründete den Bau von GPT-4o genau mit diesem Verlust: Frühere Sprachmodi ketteten drei Modelle und verloren dabei Tonfall, Hintergrundgeräusche und Mehrsprecher-Information [1].
Für die Einordnung hilft die Familiensprache aus dem Glossar: Ein Vision-Language-Modell verbindet Bild und Text, ein Audio-Language-Modell Klang und Text, ein Text-to-Image-Modell erzeugt aus Worten Bilder, ein Text-to-Video-Modell aus Worten Filme. Die Namen verraten schon die Richtung: Was vor dem „to“ steht, geht hinein, was dahinter steht, kommt heraus.
Warum die Richtung über Kosten und Qualität entscheidet
Für die Praxis zählt die Matrix aus drei Gründen. Erstens Kosten: Ein Modell, das Video einliest, verarbeitet enorme Datenmengen; Gemini 1.5 wirbt deshalb nicht zufällig mit „compute-effizient“ für seine Millionen-Token-Kontexte [2]. Zweitens Qualität: Wer Audio direkt versteht statt es zu transkribieren, behält Betonung und Pausen, die in der Übersetzung zu Text verloren gehen [1]. Drittens Erwartungsmanagement: Ein Modell, das Bilder „versteht“, kann meist keine erzeugen. Wer das verwechselt, bucht Sehschärfe und erwartet Malerei.
Die Matrix verändert sich schnell
Zum Schluss eine Warnung vor dem eigenen Dokument: Diese Matrix ist eine Momentaufnahme vom 20. Oktober 2026. Modellgrenzen verschieben sich mit jeder Veröffentlichung. Ein Beispiel, wie schnell: OpenAIs Text-zu-Video-Modell Sora, 2024 noch als Vorschau mit bis zu einer Minute Filmlänge vorgestellt, ist als Produkt laut Anbieterseite seit dem 26. April 2026 nicht mehr verfügbar [7]. Wer eine Kauf- oder Architekturentscheidung trifft, prüft die Matrix deshalb am besten an den verlinkten Originalquellen nach, statt sich auf eine Zusammenstellung zu verlassen, auch auf diese hier. Wer die Bauprinzipien hinter den Zeilen verstehen will, findet sie im Architektur-Überblick, und wie aus verstehenden Modellen handelnde Agenten werden, erklären die Agenten-Fundamente.
Methode
Gelesen wurden am 20. Oktober 2026 die Ankündigungsseiten von OpenAI zu GPT-4o und Sora, die Produktseite von Google DeepMind zu Veo sowie die arXiv-Seiten der Papers zu Gemini 1.5, Whisper, CLIP und Stable Diffusion 3 einschließlich der eingebetteten Volltexte. Jede Zeile der Matrix ist mit genau der Quelle belegt, aus der die Ein- und Ausgaben hervorgehen. Die Säulengrafik ist eine eigene Zählung aus denselben Quellen und als solche gekennzeichnet. Der Text entstand mit KI-Unterstützung und wurde von der Redaktion verantwortet.
Grenzen
Die Matrix zeigt sechs Referenzmodelle, nicht den Markt. Anbieter schalten Funktionen schrittweise frei; die tatsächlich verfügbaren Ein- und Ausgaben können je nach Produkt, Tarif und Region enger sein als die hier dokumentierten Modellfähigkeiten. Video-Eingabe bei GPT-4o wurde zum Zugriffszeitpunkt laut Ankündigung nur für eine kleine Partnergruppe ausgerollt. Die Modalitätenzählung in der Grafik ist eine redaktionelle Vereinfachung (CLIP-Embeddings als ein Ausgabekanal). Keine eigenen Messungen oder Modelltests.
Quellen
- Hello GPT-4o, OpenAI, 13. Mai 2024 (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- Gemini 1.5: Unlocking multimodal understanding across millions of tokens of context, arXiv:2403.05530 (Gemini Team, Google, 2024) (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4
- Robust Speech Recognition via Large-Scale Weak Supervision (Whisper), arXiv:2212.04356 (Radford u. a., OpenAI, 2022) (abgerufen 2026-10-20) ↩1 ↩2
- Learning Transferable Visual Models From Natural Language Supervision (CLIP), arXiv:2103.00020 (Radford u. a., OpenAI, ICML 2021) (abgerufen 2026-10-20) ↩1 ↩2 ↩3
- Scaling Rectified Flow Transformers for High-Resolution Image Synthesis (Stable Diffusion 3), arXiv:2403.03206 (Esser u. a., Stability AI, ICML 2024) (abgerufen 2026-10-20) ↩1 ↩2
- Veo (Produktseite), Google DeepMind (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4 ↩5
- Creating video from text (Sora), OpenAI (abgerufen 2026-10-20) ↩