 KI
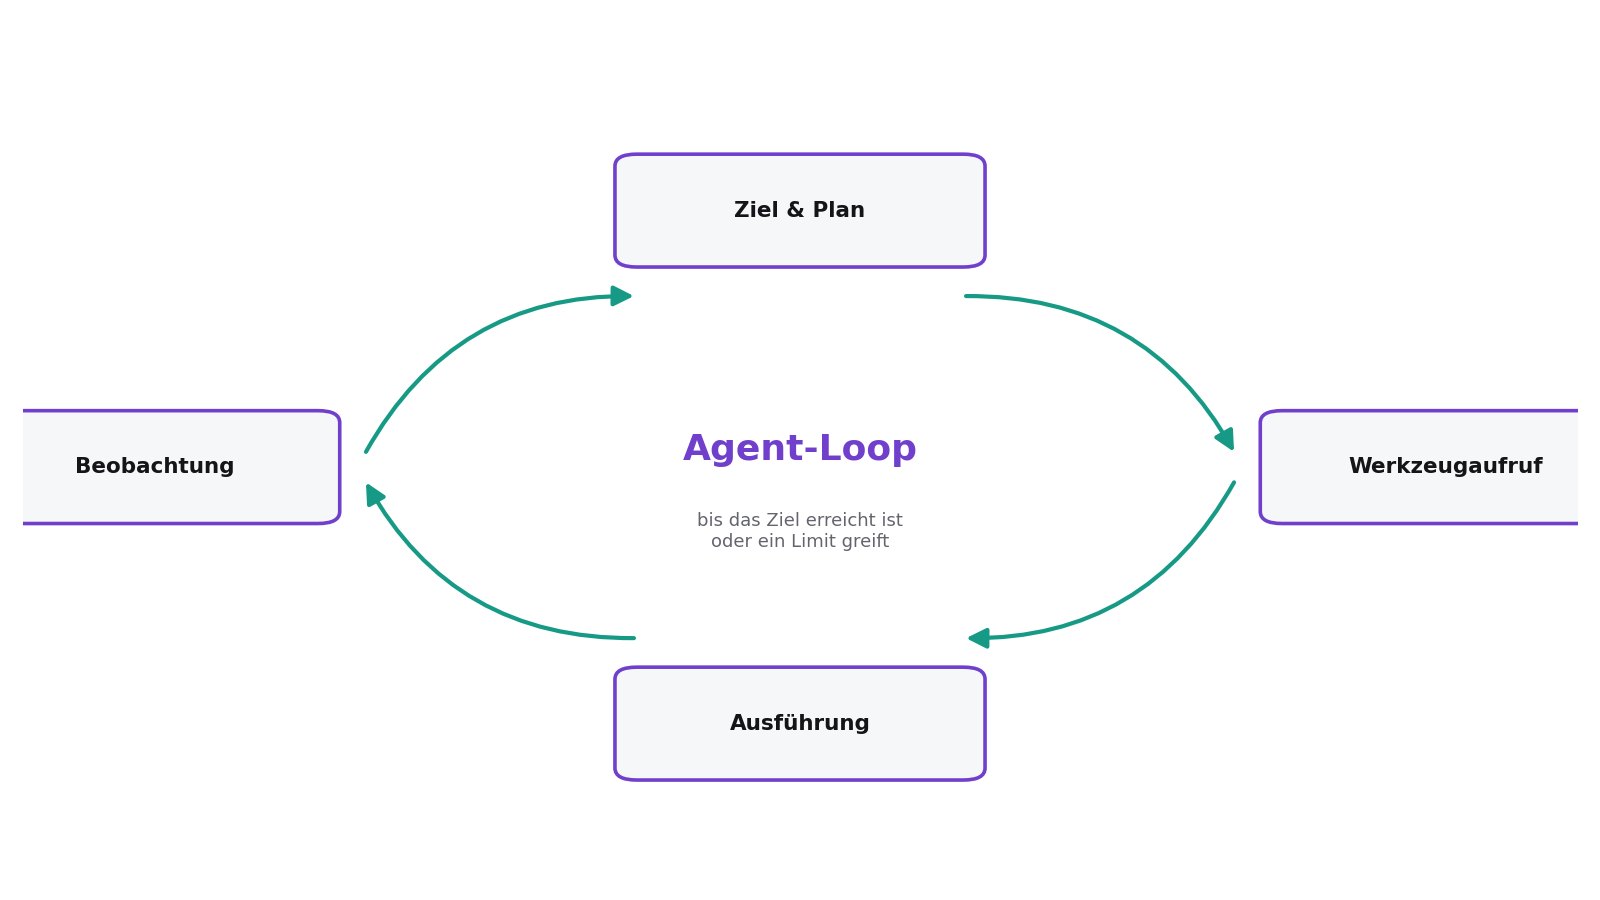
Ein Chatbot antwortet. Ein Agent handelt. Der Unterschied sitzt nicht im Modell, sondern drumherum: Der Agent bekommt ein Ziel, überlegt den nächsten Schritt, ruft ein Werkzeug auf, liest das Ergebnis und entscheidet neu, bis die Aufgabe erledigt ist oder ein Limit greift. Das haben wir in Was ein KI-Agent wirklich ist skizziert. Diese Seite geht eine Etage tiefer und zerlegt den Bauplan in fünf Bausteine: die Schleife, die Werkzeuge, das Gedächtnis, die Planung und MCP, das Protokoll, das die Werkzeugwelt gerade standardisiert. Wer nur die Alltagsversion sucht, findet sie dort; wer baut oder kauft, bekommt hier die Prüfpunkte dazu.
Baustein 1: Die Schleife
Die Agent-Loop lässt sich mit Kochen erklären. Ein Chatbot ist wie jemand, der ein Rezept einmal komplett aufsagt. Ein Agent ist der Koch, der zwischendurch abschmeckt: Er probiert, stellt fest, dass Salz fehlt, korrigiert und schmeckt erneut ab. Das Papier, das dieses Muster für Sprachmodelle prägte, heißt ReAct: Das Modell erzeugt abwechselnd Denkspuren und Handlungen. Die Denkspuren helfen, Pläne zu bilden, zu verfolgen und zu korrigieren; die Handlungen holen Informationen aus der Außenwelt, etwa aus einer Wissensdatenbank [1].
Der gemessene Unterschied ist beachtlich. Auf den Wissensaufgaben HotpotQA und Fever überwand ReAct laut Paper die üblichen Probleme von Halluzination und Fehlerfortpflanzung, weil das Modell Fakten per Wikipedia-Abfrage nachschlug statt sie zu raten. In den interaktiven Umgebungen ALFWorld und WebShop schlug ReAct Imitations- und Verstärkungslernen um 34 beziehungsweise 10 Prozentpunkte absolute Erfolgsquote, mit nur ein oder zwei Beispielen im Prompt [1]. Die Schleife macht aus einem Antwortautomaten ein System, das seinen Weg korrigieren kann.
Baustein 2: Werkzeuge und Function Calling
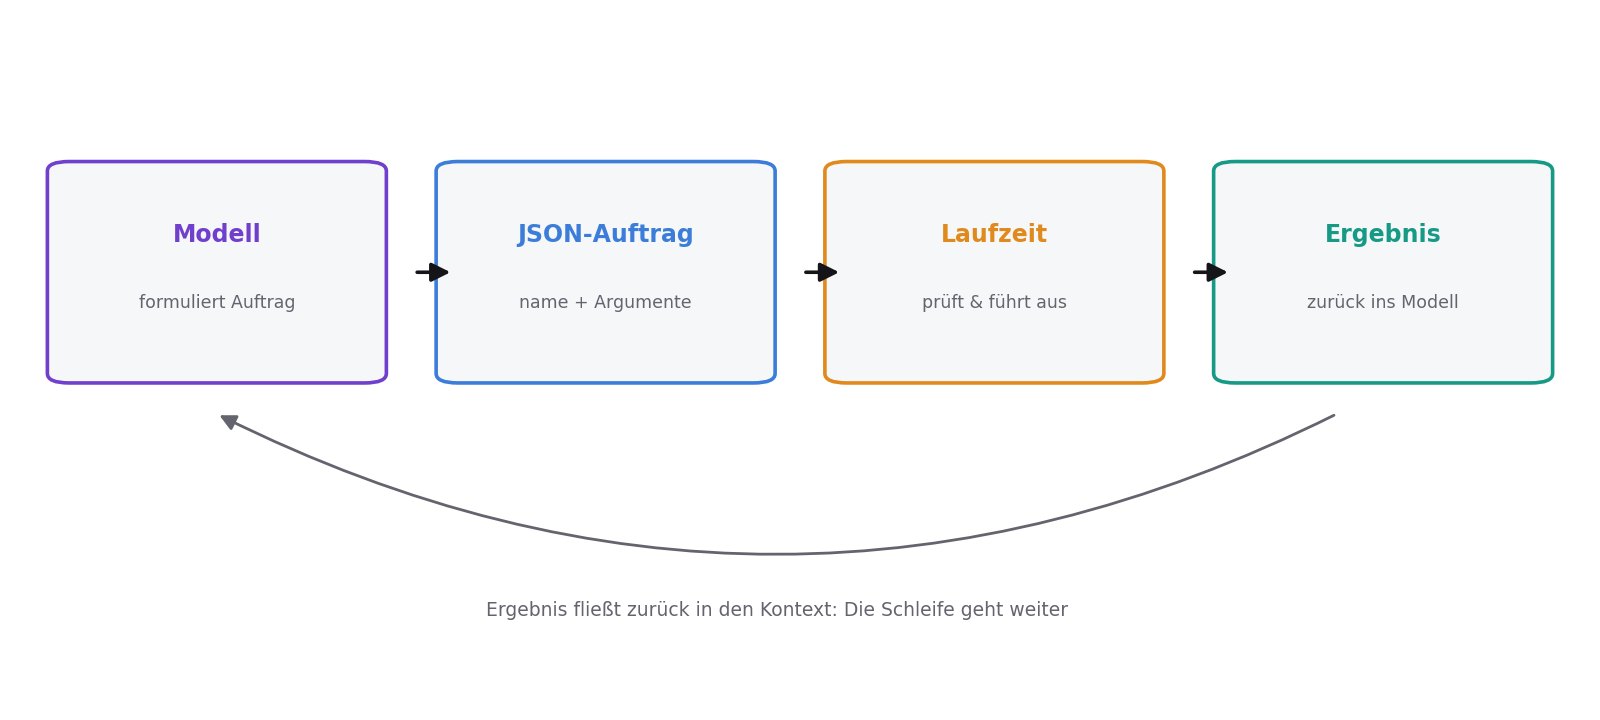
Ein Werkzeug ist eine Funktion, die der Agent anfordern darf: eine Suche, ein Kalender, eine Datenbank, ein Taschenrechner. Der entscheidende Punkt wird gern übersehen: Das Modell führt das Werkzeug nie selbst aus. Beim Function Calling formuliert es einen strukturierten Auftrag, typischerweise ein kleines JSON-Dokument mit Name und Argumenten des Werkzeugs. Ein gewöhnliches Programm prüft diesen Auftrag, führt ihn aus und reicht das Ergebnis zurück in den Kontext. Anthropic nennt dieses Grundmuster das „augmented LLM“, ein Sprachmodell mit Abruf, Werkzeugen und Gedächtnis als Grundbaustein jedes agentischen Systems [2].
{
  "name": "wetter_abfragen",
  "arguments": { "ort": "Bonn", "tag": "heute" }
}
Das stark vereinfachte Beispiel zeigt die Idee: Das Modell produziert nur den Auftrag oben. Ob `wetter_abfragen` existiert, ob „Bonn“ erlaubt ist und ob das Ergebnis stimmt, entscheidet die Laufzeitumgebung. Darin liegt die wichtigste Sicherheitsgrenze des ganzen Aufbaus: Was ein Agent kann, bestimmen die Werkzeuge, die man ihm gibt, und die Rechte dahinter. Ein Agent mit reinem Lesezugriff kann nichts löschen. Ein Agent mit Schreibzugriff auf alles kann sich gründlich irren, deshalb gehört vor unumkehrbaren Schritten ein Human-in-the-Loop-Freigabepunkt, und um den Rest kümmern sich Guardrails.
Baustein 3: Gedächtnis
Das Kontextfenster ist die Arbeitsfläche des Modells: Alles, woran es sich „erinnert“, muss dort hineinpassen. Memory bei Agenten bedeutet deshalb fast nie, dass das Modell selbst etwas dazulernt. Es bedeutet, dass Information außerhalb abgelegt und bei Bedarf wieder in den Kontext geholt wird: Notizen aus früheren Schritten, Dateien, Datenbankeinträge. Das MemGPT-Paper hat das konsequent zu Ende gedacht und die Speicherhierarchie von Betriebssystemen kopiert: Wie ein Rechner zwischen Arbeitsspeicher und Festplatte seitenweise hin- und herschiebt, schiebt das System Information zwischen Kontext und externem Speicher und erzeugt so die Illusion eines fast unbegrenzten Gedächtnisses [3].
Die Analogie zum Schreibtisch trägt weit: Ein großes Kontextfenster ist eine größere Tischplatte, aber auch dort verliert sich Wichtiges in der Mitte des Stapels (Lost in the Middle). Gutes Gedächtnis ist deshalb keine Frage der Größe, sondern der Buchführung: Was wird aufgeschrieben, wann wird es wieder hervorgeholt, und wer räumt auf.
Baustein 4: Planung
Planung bei Agenten klingt nach dem kompliziertesten Baustein, ist aber vor allem eine Frage der Demut. Anthropic zieht nach der Arbeit mit Dutzenden Kundenteams eine klare Linie: Workflows sind Systeme, in denen Modelle und Werkzeuge über vorher festgelegte Codepfade laufen; Agenten dagegen steuern ihren Prozess und ihre Werkzeugnutzung selbst. Die Praxisempfehlung ist erstaunlich konservativ: Baue die einfachste Lösung, die funktioniert, und erhöhe die Komplexität nur, wenn nötig, denn agentische Systeme tauschen Latenz und Kosten gegen bessere Aufgabenlösung [2].
Für die Mitte zwischen starrem Ablauf und freiem Agenten beschreibt derselbe Bericht bewährte Muster: Aufgaben in feste Schrittfolgen zerlegen (Prompt Chaining), Eingaben an Spezialpfade verteilen (Routing), mehrere Modellaufrufe parallel laufen lassen oder einen Koordinator auf Unterarbeiter ansetzen (Orchestrator-Workers). Ein freier Agent lohnt sich erst, wenn das Problem offen ist und die Zahl der Schritte nicht vorhersehbar, und selbst dann braucht er Vertrauen in seine Entscheidungen und einen Boden, auf dem er sich bewegen darf [2].
Baustein 5: MCP, der gemeinsame Stecker
Bis vor Kurzem war jedes Werkzeug eine Sonderanfertigung: Wer ein Modell an Kalender, Dateien oder Datenbanken anschließen wollte, baute für jede Quelle und jedes Modell eine eigene Integration. Das Model Context Protocol (MCP) greift genau diesen Flaschenhals an. Anthropic stellte es am 25. November 2024 als offenen Standard vor, der KI-Assistenten mit den Systemen verbindet, in denen Daten leben, mit Spezifikation und SDKs, lokaler Server-Unterstützung und einem offenen Verzeichnis von Servern [4].
Die offizielle Dokumentation benutzt den treffendsten Vergleich: MCP ist wie ein USB-C-Anschluss für KI-Anwendungen. So wie USB-C Geräte standardisiert ans Strom- und Datennetz bringt, verbindet MCP Anwendungen standardisiert mit Datenquellen, Werkzeugen und Arbeitsabläufen. Die Architektur ist dabei schlicht: Wer Daten bereitstellen will, baut einen MCP-Server; wer eine KI-Anwendung baut, implementiert einen MCP-Client, der sich mit diesen Servern verbindet [5]. Für Agenten heißt das: Der Werkzeugkasten wird austauschbar, und eine einmal gebaute Anbindung funktioniert überall dort, wo MCP gesprochen wird.
Wo Agenten scheitern und was das kostet
Agenten scheitern selten spektakulär, sie driften: Ein früher Fehler wird als Tatsache weitergetragen, die Schleife dreht Runden, die Aufgabe verschiebt sich. Je länger die Kette, desto mehr multiplizieren sich kleine Fehlerquoten. Die Gegenmittel sind unspektakulär: kurze, klar begrenzte Aufgaben, sichtbare Zwischenstände, dokumentierte Denkspuren wie bei ReAct [1], und eine menschliche Freigabe vor allem, was sich nicht rückgängig machen lässt. Anthropic bringt die Kostenfrage auf den Punkt: Agentische Systeme tauschen Latenz und Geld gegen Qualität, diese Rechnung sollte vor dem Bau stehen, nicht danach [2]. Wer die Leistung von Langzeit-Agenten in Zahlen sehen will, findet sie in unserer Analyse der Long-Horizon-Terminal-Bench. Und die Bausteine dahinter, vom Transformer bis zur Modalität, erklären der Architektur-Überblick und die Modalitäten-Matrix.
Methode
Gelesen wurden am 20. Oktober 2026 die arXiv-Seiten zu ReAct und MemGPT einschließlich der eingebetteten Volltexte, der Engineering-Bericht und die MCP-Ankündigung von Anthropic sowie die offizielle MCP-Dokumentation. Alle Zahlen (Erfolgsquoten, Prozentpunkte) und Zitate stammen aus diesen Quellen und sind im Text belegt. Das JSON-Beispiel ist ein didaktisches, stark vereinfachtes Beispiel und kein Protokollauszug. Der Text entstand mit KI-Unterstützung und wurde von der Redaktion verantwortet.
Grenzen
Die fünf Bausteine sind eine redaktionelle Gliederung, keine Norm; andere Lehrbücher schneiden den Bauplan anders. Die Erfolgsquoten aus dem ReAct-Paper beziehen sich auf die dortigen Testumgebungen und Prompts und sind nicht auf beliebige Agenten übertragbar. Der Werkzeug- und MCP-Markt verändert sich schnell; Anthropic weist inzwischen selbst darauf hin, dass sich die beschriebene Werkzeuglandschaft seit Dezember 2024 gewandelt hat. Keine eigenen Messungen, kein selbst gebauter Agent als Beleg.
Quellen
- ReAct: Synergizing Reasoning and Acting in Language Models, arXiv:2210.03629 (Yao u. a., ICLR 2023) (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4
- Building effective agents, Anthropic, 19. Dezember 2024 (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4 ↩5
- MemGPT: Towards LLMs as Operating Systems, arXiv:2310.08560 (Packer u. a., UC Berkeley, 2023) (abgerufen 2026-10-20) ↩1 ↩2
- Introducing the Model Context Protocol, Anthropic, 25. November 2024 (abgerufen 2026-10-20) ↩1 ↩2
- What is the Model Context Protocol (MCP)?, MCP-Dokumentation (modelcontextprotocol.io) (abgerufen 2026-10-20) ↩1 ↩2 ↩3