 KI
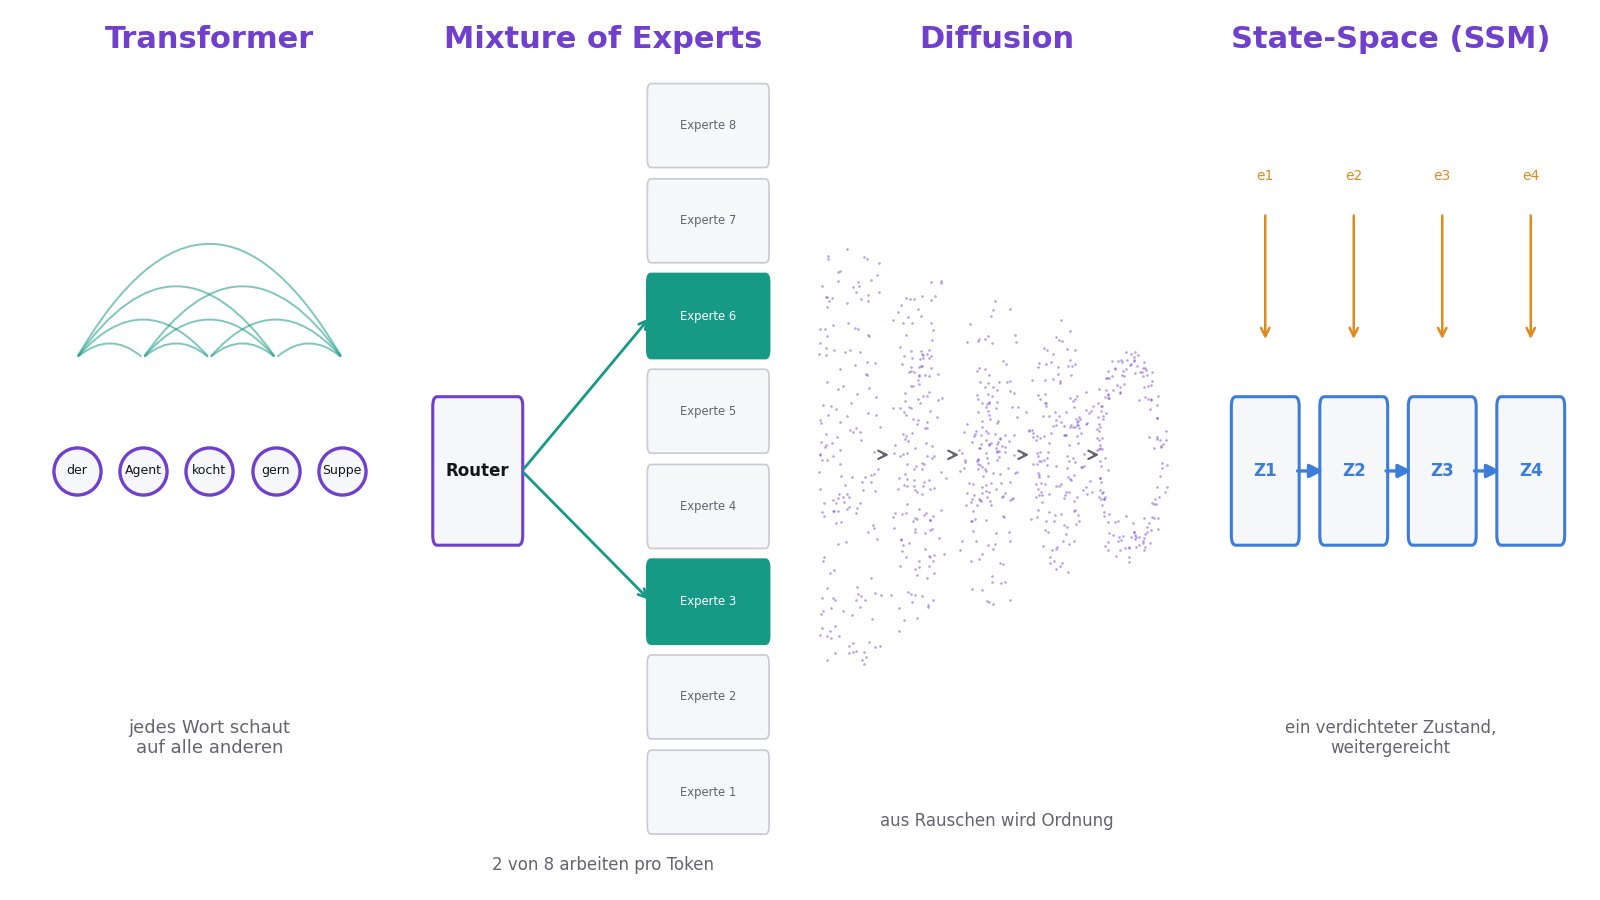
Wenn von einem neuen KI-Modell die Rede ist, steht fast immer dieselbe Frage dahinter: Wie ist es gebaut? Die Antwort entscheidet über weit mehr als über die Fußnote in einem Paper. Sie bestimmt, wie schnell ein Modell antwortet, was ein Token kostet, wie lang der Kontext sein darf und ob das Modell überhaupt Text, Bilder oder beides verarbeiten kann. Dieser Überblick stellt die vier Architekturfamilien vor, die die aktuelle Modelllandschaft tragen: den Transformer, Mixture of Experts, Diffusionsmodelle und State-Space-Modelle. Für jede Familie gilt dasselbe Muster: eine Kernidee, eine Stärke, ein Preis.
Eine kurze Analogie für den ganzen Artikel: Architekturen sind wie Verkehrssysteme einer Stadt. Der Transformer baut an jeder Kreuzung eine Ampel mit Sicht auf alle anderen Kreuzungen. Mixture of Experts stellt Fachbetriebe bereit und schickt jeden Auftrag nur an die passenden zwei. Diffusion entwickelt ein Foto langsam aus dem Nebel. Und State-Space-Modelle führen Protokoll, statt bei jeder Frage die gesamte Akte erneut zu lesen.
Transformer: Alles schaut auf alles
Bis 2017 lasen Sprachmodelle Text wie ein Mensch eine Endlosurkunde: Wort für Wort, von vorne nach hinten, mit einem Gedächtnis, das unterwegs notierte, was wichtig schien. Diese sequenzielle Arbeitsweise ließ sich schlecht parallelisieren. Das Paper „Attention Is All You Need“ von Vaswani und Kollegen schlug einen radikalen Umbau vor: Verzichte ganz auf Wiederholung und Faltung und baue das Netz ausschließlich aus Aufmerksamkeit. Jedes Wort schaut bei jedem Verarbeitungsschritt auf alle anderen Wörter des Satzes und entscheidet, welche davon für seine Bedeutung wichtig sind [1].
Der Effekt war doppelt. Erstens: Weil alle Wörter gleichzeitig verarbeitet werden statt nacheinander, ließ sich das Training massiv parallel beschleunigen. Das Paper berichtet für sein großes Modell 3,5 Tage Training auf acht Grafikkarten, „ein Bruchteil der Trainingskosten der besten Modelle der Literatur“. Zweitens stellte das Modell damals Rekorde auf: 28,4 BLEU auf der Übersetzungsaufgabe WMT 2014 Englisch–Deutsch, mehr als zwei Punkte über den bis dahin besten Ergebnissen inklusive Ensembles, und 41,8 BLEU auf Englisch–Französisch als neuer Bestwert für ein Einzelmodell [1].
Die Stärke ist zugleich der Flaschenhals. Wenn jedes Element auf jedes schaut, wächst der Aufwand der Aufmerksamkeit mit dem Quadrat der Sequenzlänge. Doppelter Kontext bedeutet vervielfachte Arbeit pro Schritt. Genau diese „Rechenineffizienz bei langen Sequenzen“ ist der Ausgangspunkt, an dem die Mamba-Autoren Jahre später ansetzen [6]. Bis dahin dominierte der Transformer praktisch unangefochten: Fast alle bekannten Sprach-, Bild- und Videomodelle der Gegenwart sind im Kern Transformer, wie das Mamba-Paper trocken feststellt [6].
Mixture of Experts: Viele Fachkräfte, wenige im Einsatz
Ein normales (dichtes) Modell benutzt für jede Eingabe alle seine Parameter. Das ist, als würde für jeden Handwerksauftrag die gesamte Belegschaft einer Firma antreten. Mixture of Experts (MoE) dreht das um: Das Modell enthält viele parallele Fachnetze, die „Experten“, und ein kleines Router-Netz entscheidet pro Token, welche Experten überhaupt arbeiten. Das Switch-Transformer-Paper von Google beschreibt das Ergebnis als „spärlich aktiviertes Modell mit einer ungeheuren Parameterzahl, aber konstanten Rechenkosten“ [2].
Der wichtigste Handgriff des Switch Transformers war eine Vereinfachung: Statt jedes Token an mehrere Experten zu verteilen, routet er jedes Token an genau einen Experten. Das spare Routing-Rechenarbeit, halbiere die nötige Stapelgröße pro Experte und senke die Kommunikationskosten, bei unveränderter Modellqualität, berichten die Autoren. Damit skalierten sie Modelle bis in den Billionen-Parameter-Bereich und maßen bis zu siebenfache Beschleunigung des Vortrainings gegenüber der starken T5-Baseline bei gleichem Rechenbudget [2].
Das bekannteste offene Beispiel ist Mixtral 8x7B von Mistral AI. Jede Schicht enthält acht Feed-Forward-Blöcke, und der Router wählt pro Token zwei davon aus. Über alle Schichten hat ein Token so Zugriff auf 47 Milliarden Parameter, verwendet aber bei der Inferenz nur 13 Milliarden aktive Parameter. Das Modell wurde mit 32.000 Tokens Kontext trainiert und erreichte laut Paper auf allen ausgewerteten Benchmarks mindestens das Niveau von Llama 2 70B und GPT-3.5, bei deutlich geringerem Rechenaufwand pro Antwort. Veröffentlicht wurde es unter der Apache-2.0-Lizenz [3].
Diffusion: Bilder entstehen durch Entrauschen
Diffusionsmodelle beantworten eine andere Frage als Sprachmodelle: Wie erzeugt man neue Daten, etwa Bilder? Die Idee lässt sich an einer Fotografie erklären, die langsam im Nebel versinkt. Der Vorwärtsprozess zerstört ein Bild Schritt für Schritt, indem er Rauschen hinzufügt, bis nur noch statisches Flimmern übrig ist. Das Modell lernt den umgekehrten Weg: Aus Rauschen ein Stück Ordnung zurückzugewinnen, Schritt für Schritt, bis ein sauberes Bild dasteht. Das DDPM-Paper von Ho, Jain und Abbeel zeigte 2020, dass dieses Verfahren Bilder in Referenzqualität erzeugt, darunter einen FID-Wert von 3,17 und einen Inception Score von 9,46 auf CIFAR-10, sowie eine Bildqualität auf LSUN (256 × 256) vergleichbar mit ProgressiveGAN [4].
Der Preis des Verfahrens liegt im Tempo. Während ein Sprachmodell Wort für Wort vorwärts läuft, muss ein Diffusionsmodell für ein einziges Bild viele kleine Verbesserungsschritte hintereinander ausführen. Jeder Schritt ist ein voller Netzwerkdurchlauf. Forschung an schnelleren Verfahren ist deshalb Alltag in diesem Bereich: Die Arbeit hinter Stable Diffusion 3 nutzt etwa „Rectified Flow“, eine Formulierung, die Daten und Rauschen auf einer geraden Linie verbindet und so kürzere Wege vom Rauschen zum Bild erlaubt. Derselbe Beitrag ersetzte den klassischen Diffusions-Baukasten durch einen Transformer, der Text- und Bildinformationen getrennt gewichtet, aber bidirektional austauscht, was Textverständnis, Typografie und die Bewertung durch menschliche Prüfer verbesserte [5].
State-Space-Modelle: Protokoll statt Rückblick
State-Space-Modelle (SSM) greifen die quadratische Schwäche des Transformers frontal an. Ihre Grundfigur ist das Protokoll: Statt bei jeder neuen Frage die gesamte bisherige Sequenz erneut zu betrachten, führen sie einen verdichteten Zustand mit, der bei jedem neuen Element aktualisiert wird. Der Rechenaufwand wächst damit linear statt quadratisch mit der Sequenzlänge. Den Haken der frühen Vertreter dieser Familie benennt das Mamba-Paper ehrlich: Solche Modelle konnten nicht inhaltsbasiert denken, sie behandelten jedes Token nach demselben starren Schema [6].
Mamba löst das mit „selektiven“ Zustandsräumen: Die Parameter des Zustands hängen vom aktuellen Inhalt ab, sodass das Modell je nach Eingabe entscheidet, was es im Zustand behält und was es verwirft. Das Paper berichtet lineare Skalierung mit der Sequenzlänge, bis zum Fünffachen höheren Inferenz-Durchsatz als Transformer und Verbesserungen bei Sequenzen bis zu einer Million Elemente. Auf Sprachmodellierung übertraf das 3-Milliarden-Parameter-Modell Transformer gleicher Größe und erreichte das Niveau von Transformern doppelter Größe, gemessen an Vortrainings-Perplexität und Folgeaufgaben [6].
Vier Familien im direkten Vergleich
| Familie | Kernidee | Stärke | Preis | Beispiele |
|---|---|---|---|---|
| Transformer | Jedes Element schaut auf alle (Aufmerksamkeit) | Parallelisierbar, universell, bestverstanden | Aufwand wächst quadratisch mit der Länge | GPT-4o, Gemini, Llama, Claude [1][6] |
| Mixture of Experts | Router aktiviert pro Token wenige Fachnetze | Viele Parameter bei konstanten Rechenkosten | Hoher Speicherbedarf, komplexes Training | Switch Transformer, Mixtral 8x7B [2][3] |
| Diffusion | Rauschen schrittweise entfernen | Referenzqualität bei Bildern und Video | Viele Netzwerkdurchläufe pro Ergebnis | DDPM, Stable Diffusion 3 [4][5] |
| State-Space (Mamba) | Verdichteter Zustand wird weitergereicht | Lineare Kosten, fünffacher Durchsatz (Paper) | Jung, weniger erprobt als Transformer | Mamba-3B [6] |
Die Familien schließen sich nicht aus, sie kombinieren sich. Mixtral ist ein Transformer, dessen Feed-Forward-Schichten als Experten organisiert sind [3]. Stable Diffusion 3 ist ein Diffusionsmodell mit Transformer-Rückgrat [5]. Und die Gemini-1.5-Modelle kombinieren nach Angabe der Entwickler einen MoE-Ansatz mit Millionen-Token-Kontext [7]. Wer eine Modellkarte liest, sollte deshalb auf zwei Angaben achten: das Grundprinzip (wie wird Sequenz verarbeitet?) und die Sparmaßnahme (wo wird Rechenarbeit eingespart?).
- Aufmerksamkeit (quadratisch)
- Zustandsmodell (linear)
Daten als Tabelle
| Sequenzlänge (Elemente) | Aufmerksamkeit (quadratisch) | Zustandsmodell (linear) |
|---|---|---|
| 1.000 | 1 | 1 |
| 10.000 | 100 | 10 |
| 100.000 | 10000 | 100 |
| 1.000.000 | 1000000 | 1000 |
Quelle: Eigene Rechnung auf Basis der in [1] und [6] beschriebenen Skalierung. Illustration der Größenordnung, keine Messung.
Relative Rechenarbeit pro Verarbeitungsschritt in Abhängigkeit von der Sequenzlänge, normiert auf 1.000 Elemente. Eigene Rechnung: Aufmerksamkeit wächst quadratisch (n²), ein Zustandsmodell linear (n); auf 100.000 Elementen liegt der Faktor 100 zwischen beiden Kurven.
Was das für die Praxis bedeutet
Drei Faustregeln genügen für die meisten Lektüren. Erstens: Sprachmodelle sind fast immer Transformer, oft mit MoE-Innenleben; die aktive Parameterzahl verrät mehr über die Kosten als die Gesamtzahl. Zweitens: Wer Bilder oder Videos erzeugt, arbeitet fast immer mit Diffusion und bezahlt dafür mit Wartezeit pro Ergebnis. Drittens: Wenn ein Anbieter mit extrem langen Kontexten oder niedrigen Kosten pro Token wirbt, lohnt der Blick, ob spärliche Aktivierung oder eine Zustandsarchitektur dahintersteckt, denn beide verschieben die Kosten an andere Stellen, etwa in den Speicher oder in die Erprobung. Wer tiefer einsteigen will, findet die zentralen Begriffe im Glossar, von KV-Cache bis Speicherbandbreite-Grenze. Und wer sehen will, welche Modelle welche Ein- und Ausgaben beherrschen, liest die Modalitäten-Matrix.
Methode
Gelesen wurden am 20. Oktober 2026 die arXiv-Seiten der sieben genannten Veröffentlichungen inklusive der dort eingebetteten Volltexte. Alle Zahlen (BLEU-Werte, Parameterbilanzen, Durchsatz- und Beschleunigungsangaben, FID und Inception Score) stammen aus diesen Quellen und sind im Text mit Beleg versehen. Das Längen-Kosten-Diagramm ist eine eigene Rechnung (quadratisches gegen lineares Wachstum, normiert) und als solche gekennzeichnet. Der Text entstand mit KI-Unterstützung und wurde von der Redaktion verantwortet.
Grenzen
Die Übersicht deckt vier Familien ab und lässt bewusst Varianten weg, etwa RetNet, Hyena oder hybride Modelle. Alle Leistungszahlen stammen aus den Papieren der jeweiligen Autoren auf deren Hardware und sind nicht unabhängig nachgemessen. Die Geschwindigkeitsaussagen zu Switch und Mamba beziehen sich auf die im Paper genannten Vergleichsbedingungen. Die Verkehrssystem-Analogie ist eine didaktische Vereinfachung, keine technische Beschreibung. Keine eigenen Messungen.
Quellen
- Attention Is All You Need, arXiv:1706.03762 (Vaswani u. a., NeurIPS 2017) (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- Switch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity, arXiv:2101.03961 (Fedus, Zoph, Shazeer, JMLR 2022) (abgerufen 2026-10-20) ↩1 ↩2 ↩3
- Mixtral of Experts, arXiv:2401.04088 (Jiang u. a., Mistral AI, 2024) (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4
- Denoising Diffusion Probabilistic Models, arXiv:2006.11239 (Ho, Jain, Abbeel, NeurIPS 2020) (abgerufen 2026-10-20) ↩1 ↩2 ↩3
- Scaling Rectified Flow Transformers for High-Resolution Image Synthesis, arXiv:2403.03206 (Esser u. a., Stability AI, ICML 2024) (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4
- Mamba: Linear-Time Sequence Modeling with Selective State Spaces, arXiv:2312.00752 (Gu, Dao, 2023) (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- Gemini 1.5: Unlocking multimodal understanding across millions of tokens of context, arXiv:2403.05530 (Gemini Team, Google, 2024) (abgerufen 2026-10-20) ↩