KI
Architektur
KV-Cache: Der stille Kostentreiber hinter langen KI-Kontexten
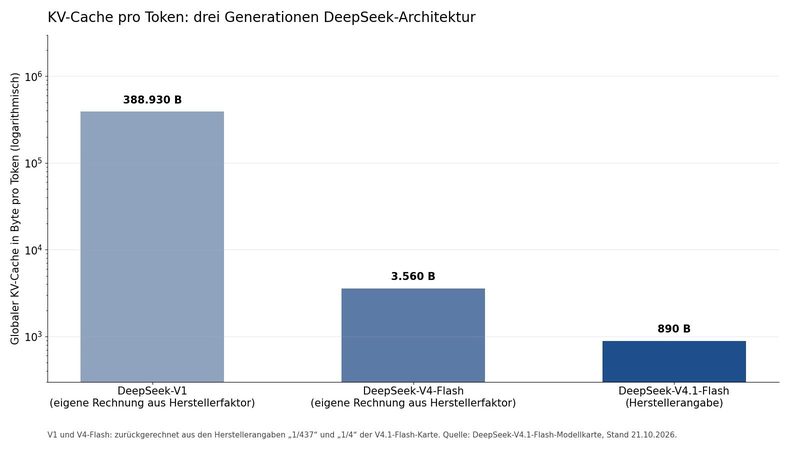
Eine Million Token Kontext klingt gratis, ist es aber nicht: Der KV-Cache frisst Speicher und Geld. Wie DeepSeek, Mistral und vLLM ihn drücken, mit Zahlen.
Lesen →
Eine Million Token Kontext klingt gratis, ist es aber nicht: Der KV-Cache frisst Speicher und Geld. Wie DeepSeek, Mistral und vLLM ihn drücken, mit Zahlen.
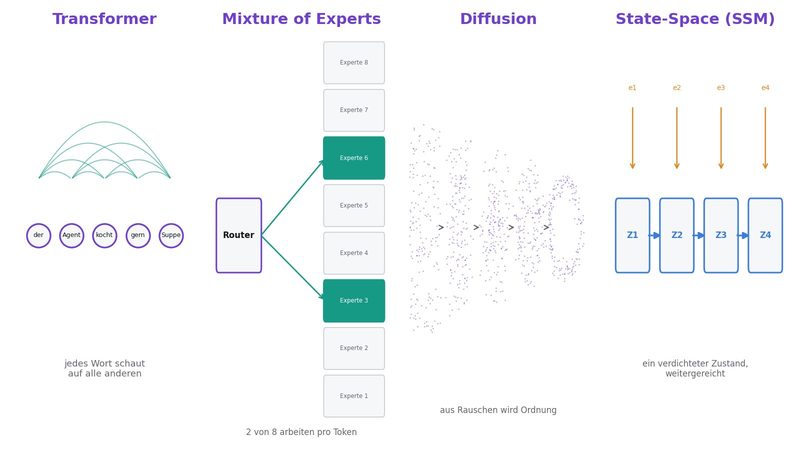
Vier Architekturfamilien entscheiden, was KI-Modelle können und kosten und wo sie scheitern: Transformer, Mixture of Experts, Diffusion, State-Space-Modelle.
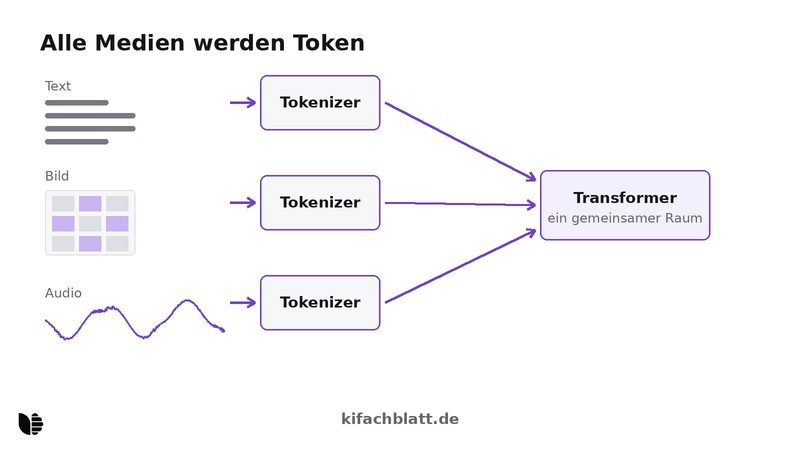
Ein Modell, viele Sinne: Wie Text, Bild, Audio und Video als Tokens im selben Modell landen, welche Architekturen das tragen und was das für die Wahl heißt.