 KI
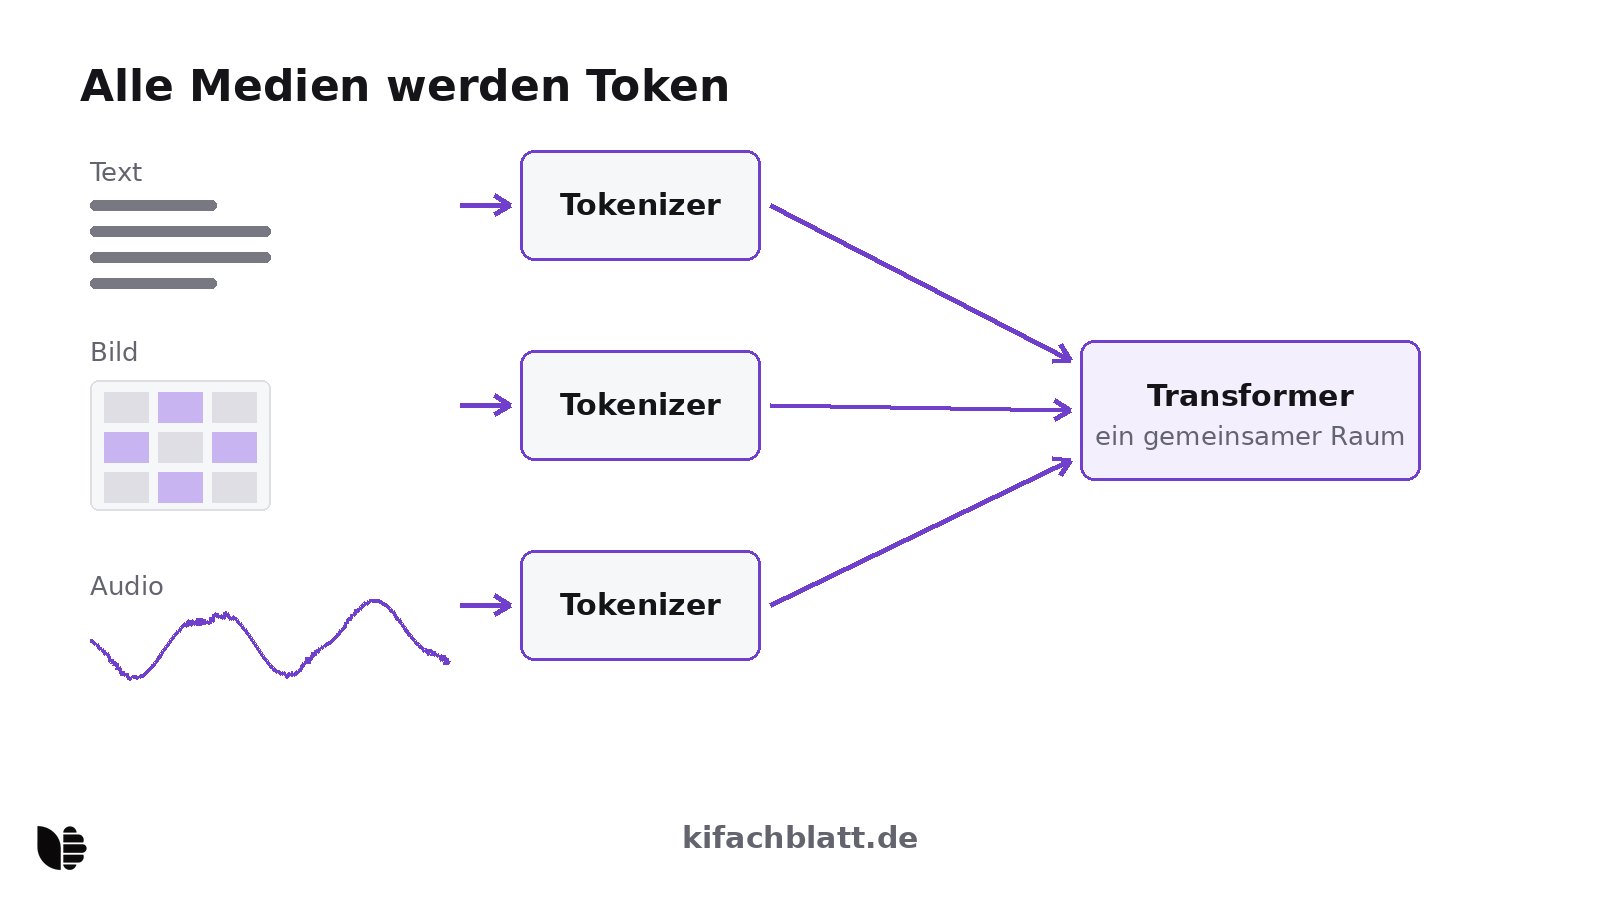
Sprachmodelle verarbeiten Text. Multimodale Modelle verarbeiten zusätzlich Bilder, Audio oder Video - als Eingabe (ein Foto beschreiben), als Ausgabe (ein Bild erzeugen) oder in beide Richtungen. Diese Seite erklärt den gemeinsamen Mechanismus, der das möglich macht, die beiden Architektur-Familien dahinter und was das für die Auswahl eines Modells bedeutet. Vertiefungen: Wie Bildmodelle lernen, Audio- und Sprach-KI, Video-KI.
Der verbindende Trick: Alles wird Token
Textmodelle zerlegen Sätze mit einem Tokenizer in Tokens - Zahlen aus einem festen Vokabular. Multimodale Modelle wenden dieselbe Idee auf andere Medien an:
- Bild: Ein Bild-Tokenizer (etwa ein VQ-VAE [4]) zerlegt ein Bild in Kacheln und ersetzt jede durch den passenden Eintrag aus einem gelernten Codebuch - das Bild wird zur Symbolsequenz. Alternativ schneiden Vision-Transformer das Bild in Patches und betten jede Patch als Vektor ein, ohne diskrete Symbole.
- Audio: Die Wellenform wird in Spektrogramme übersetzt (Frequenz über Zeit) und patchweise eingebettet; manche Modelle lernen zusätzlich diskrete Audio-Tokens, um Sprache auch erzeugen zu können (Audio-Language-Modell).
- Video: Ein Film ist eine Sequenz von Bildern plus Zeit; Video-Tokenizer zerlegen Blöcke aus Raum und Zeit in Tokens.
Danach läuft alles durch denselben Apparat: ein Transformer, der Aufmerksamkeit über die Token-Sequenz rechnet - egal, ob ein Token für ein Wort, eine Bildkachel oder ein Audio-Stück steht. Das ist die eigentliche Multimodalität: nicht viele Modelle nebeneinander, sondern ein gemeinsamer Raum.
Familie 1: Kontrastive Modelle wie CLIP
Der erste Durchbruch beim Verbinden von Bild und Text war CLIP (OpenAI, 2021): Zwei Encoder - einer für Bilder, einer für Text - wurden auf rund 400 Millionen Bild-Text-Paaren so trainiert, dass zusammengehörende Paare im Embedding-Raum nahe beieinander liegen und unpassende weit weg (kontrastives Lernen) [1]. CLIP erzeugt nichts, aber es "versteht" Ähnlichkeit zwischen Text und Bild - und wurde damit zum Baustein für Suche, Klassifikation ohne Training (Zero-Shot) und zur Steuerung von Bildgeneratoren (siehe Wie Bildmodelle lernen).
Familie 2: Generative multimodale Modelle
Die zweite Familie kann nicht nur zuordnen, sondern antworten: Diese Modelle lesen Bild und Text in einem gemeinsamen Fluss und erzeugen Text (oder Medien) als Ausgabe. Zwei Entwicklungslinien sind prägend:
- Angeschlossenes Sehen: Modelle wie LLaVA koppeln einen vortrainierten Bild-Encoder über eine Übersetzungsschicht an ein Sprachmodell und trainieren dann mit Bild-Instruktionsdaten nach (Visual Instruction Tuning) [4].
- Nativ multimodal: Modelle wie Googles Gemini werden von Beginn an gemeinsam auf Text, Bild, Audio und Video trainiert; der Technical Report beschreibt eine einzige Architektur für alle Modalitäten [2]. GPT-4V(ision) war OpenAIs erster breiter Schritt in Richtung Bildverstehen im Chat; die System Card dokumentiert Stärken und Risiken [3].
Der Unterschied ist praktisch relevant: Angebaute Sehfähigkeit erbt Stärken und Schwächen des Sprachmodells und des Bild-Encoders getrennt; natives Training verspricht tiefere Wechselwirkungen - etwa ein Diagramm nicht nur zu beschreiben, sondern mit dem Text darüber zu schlussfolgern.
Warum die Datenlage die Fähigkeiten bestimmt
Multimodale Fähigkeiten hängen an beschrifteten Paaren. Bild-Text-Paare existieren im Netz in Milliardenhöhe (Foto plus Beschreibung) - deshalb sind Bildmodelle so weit. Sauber transkribierte Audio- und Video-Daten sind seltener und teurer; entsprechend holen Audio- und Videofähigkeiten erst auf. Auch synthetische Daten spielen eine wachsende Rolle: Modelle beschriften Medien für das Training anderer Modelle [2].
Was heute geht - und wo die Grenzen liegen
Die System Card zu GPT-4V ist ein ehrlicher Lagebericht der Kategorie: Stark sind die Modelle beim Beschreiben und Einordnen von Bildinhalten, beim Lesen von Text in Bildern und beim Beantworten alltagstauglicher Fragen zu Fotos und Screenshots. Zu den dokumentierten Schwächen gehören räumliches Schlussfolgern, präzises Zählen, medizinische oder sonstige risikoreiche Deutungen und die Verwechslung ähnlicher Objekte [3]. Diese Muster gelten bis heute für die ganze Modellklasse - Details zur praktischen Nutzung in Bildverständnis in der Praxis.
Modellklassen richtig wählen
Für die Auswahl zählt die Richtung der Aufgabe:
| Aufgabe | Klasse | Beispiel |
|---|---|---|
| Bilder lesen, beschreiben, befragen | Vision-Language-Modell (VLM) | Diagramm erklären lassen |
| Bilder aus Text erzeugen | Text-to-Image-Modell | Hero-Grafik aus Prompt |
| Clips aus Text oder Bild erzeugen | Text-to-Video-Modell | Werbe-Shot |
| Sprache hören und sprechen | Audio-Language-Modell | Sprachassistent mit Stimme |
| Alles in beide Richtungen | Any-to-Any | Foto zeigen, Kommentar hören |
Konkrete Modelle und ihre Porträts sammelt der Hub KI-Modelle; für Aufgaben am Computer-Bildschirm (Klicks, Formulare) ist die eigene Klasse Computer Use relevant, gemessen etwa in OSWorld.
Einordnung
Multimodalität ist kein Extra-Feature, sondern die Richtung der gesamten Modellentwicklung: ein Transformer, viele Token-Arten. Wer verstanden hat, dass Bild, Ton und Film nur weitere Alphabete für denselben Apparat sind, kann Modellankündigungen souverän einordnen - und wählt für die eigene Aufgabe die richtige Klasse statt des lautesten Namens.
Methode
Grundlage sind die Originalarbeiten zu CLIP und LLaVA, der Gemini Technical Report und die GPT-4V(ision) System Card, alle abgerufen am 20. Oktober 2026. Architektur-Beschreibungen sind vereinfachte Zusammenfassungen dieser Quellen; die Klassen-Tabelle ist eine redaktionelle Einordnung.
Grenzen
- Hersteller veröffentlichen zu aktuellen Modellen nur noch begrenzt Architektur-Details; wo keine Primärquelle existiert, sagen wir das nicht zu.
- Die Beschreibung von Video- und Audio-Tokenizern ist stark vereinfacht; Verfahren unterscheiden sich je nach Modell.
- Keine eigenen Messungen; Fähigkeitsaussagen folgen den zitierten Dokumenten.
Quellen
- Learning Transferable Visual Models From Natural Language Supervision / CLIP (Radford et al., 2021), arXiv (abgerufen 2026-10-20) ↩
- Gemini: A Family of Highly Capable Multimodal Models (Technical Report), arXiv (abgerufen 2026-10-20) ↩1 ↩2
- GPT-4V(ision) system card, OpenAI (abgerufen 2026-10-20) ↩1 ↩2
- Visual Instruction Tuning / LLaVA (Liu et al., 2023), arXiv (abgerufen 2026-10-20) ↩1 ↩2