 KI
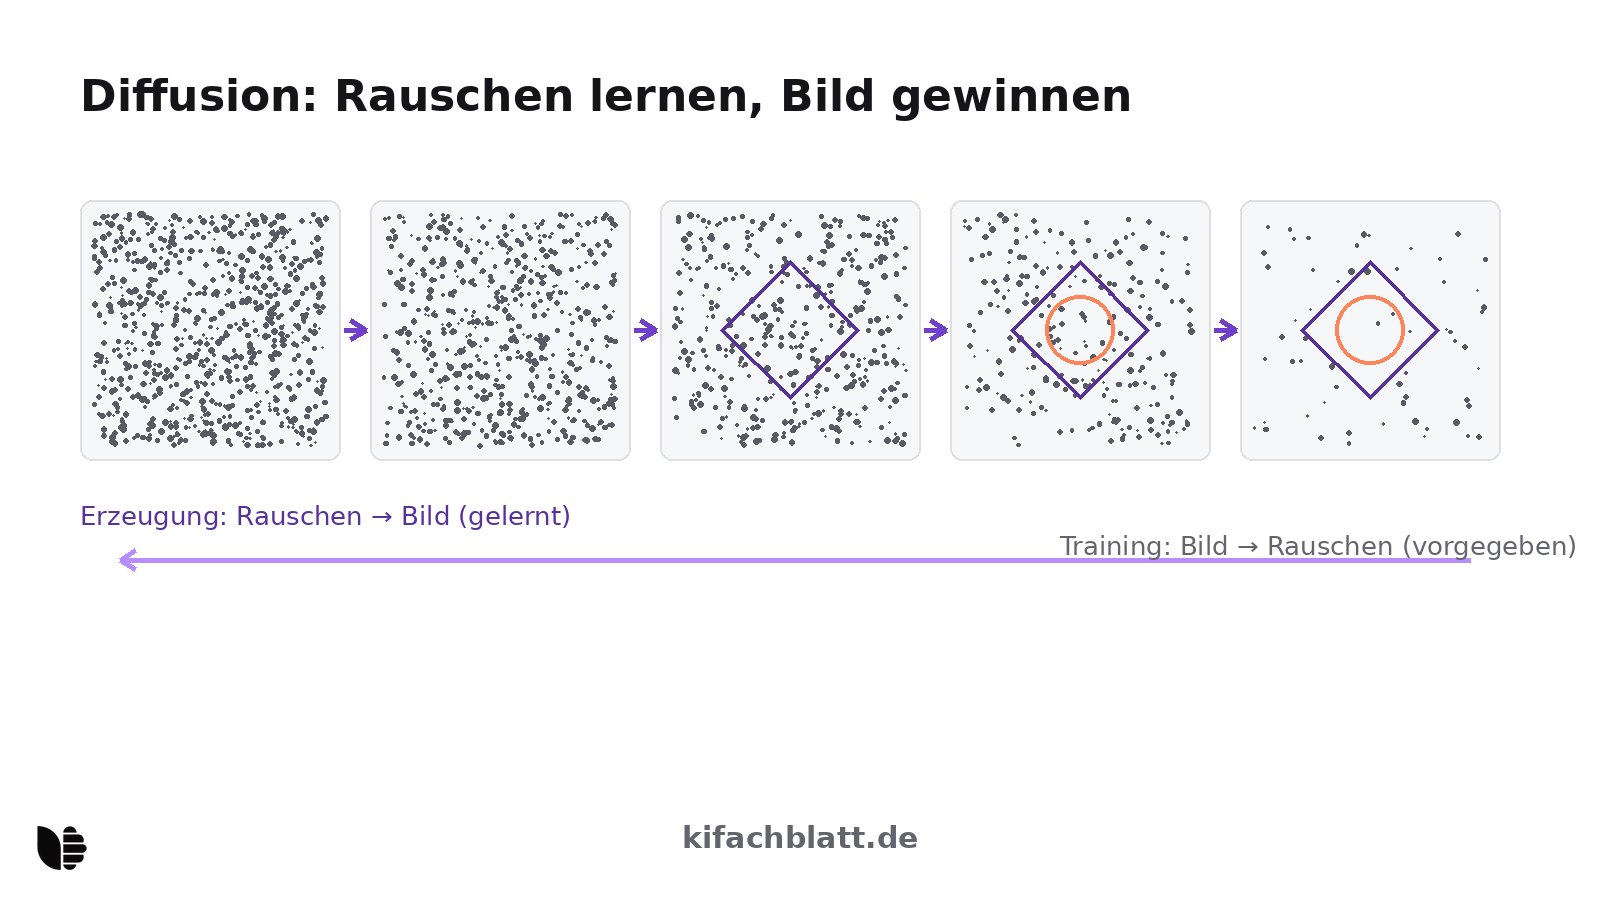
Wer heute einen Satz wie "ein Fuchs im Stil eines Holzschnitts" in ein Bild-Werkzeug tippt, bekommt in Sekunden ein brauchbares Ergebnis. Dahinter steckt kein Verstehen von Füchsen oder Holzschnitten, sondern ein trainierter statistischer Prozess. Diese Seite erklärt die drei Grundbausteine dieses Prozesses: das Diffusionsmodell, den Bild-Tokenizer und die Verbindung von Text und Bild über Modelle wie CLIP. Wer nur die Anwendung sucht, liest besser die Praxisseite Bild-KI in der Praxis; hier geht es um das Wie.
Die Grundidee: Bilder sind Zahlen
Für ein Modell ist ein Bild kein Motiv, sondern eine sehr lange Liste von Zahlen: ein farbiges Bild mit 512 × 512 Pixeln besteht aus 786.432 Zahlen (512 × 512 Pixel mal drei Farbkanäle). Lernen heißt hier: aus Millionen Beispielbildern die typischen Muster dieser Zahlenlisten erfassen. Eine grobe Analogie: Wer genug Briefe einer Sprache liest, kann irgendwann plausible neue Briefe schreiben, ohne jede Bedeutung zu kennen. Genauso lernt ein Bildmodell, welche Pixelkonstellationen "nach etwas aussehen" - ohne zu wissen, was es abbildet.
Diese Sicht erklärt schon die wichtigste Eigenschaft der Modelle: Sie interpolieren in gelernten Mustern. Was in den Trainingsdaten häufig zusammen vorkommt (Sonnenuntergang und warme Farben, Aquarell und weiche Kanten), reproduzieren sie zuverlässig. Was selten oder widersprüchlich ist - etwa korrekte Fingeranzahlen in allen Perspektiven -, klappt unzuverlässig.
Diffusion: Lernen, Rauschen rückgängig zu machen
Das dominierende Verfahren heutiger Bildmodelle ist die Diffusion, beschrieben etwa von Ho, Jain und Abbeel (2020) [1]. Die Idee lässt sich in zwei Richtungen zerlegen:
- Vorwärtsprozess (nur beim Training): Man nimmt ein echtes Bild und fügt in vielen kleinen Schritten Zufallsrauschen hinzu, bis nur noch statistisches Rauschen übrig ist - wie ein Foto, das man Schritt für Schritt stärker vernebelt, bis nichts mehr zu erkennen ist.
- Rückwärtsprozess (das gelernte Können): Ein neuronales Netz lernt, aus einer verrauschten Version das etwas weniger verrauschte Original vorherzusagen. Diesen Schritt wendet man viele Male hintereinander an.
- Erzeugung: Man startet mit reinem Zufallsrauschen und lässt das Netz schrittweise entrauschen. Heraus kommt ein neues Bild, das aussieht, als käme es aus den Trainingsdaten - aber keines davon kopiert.
Entscheidend ist: Das Netz lernt nie einzelne Bilder auswendig, sondern die Richtung, in der "weniger Rauschen" für alle Trainingsbilder liegt. Mathematisch ist das ein Näherungsverfahren für die Verteilung der Trainingsdaten. Ho und Kollegen zeigten 2020, dass dieses einfache Training (vorhersagen, welches Rauschen hinzugefügt wurde) Bilder in damals unerreichter Qualität erzeugt [1].
Der Platz-Trick: Diffusion im Latentraum
Diffusion direkt auf 786.432 Pixelzahlen ist rechenteuer. Stable Diffusion und verwandte Modelle lösen das mit einem Kompressionstrick, beschrieben von Rombach und Kollegen (2022) als Latent Diffusion [2]: Ein Autoencoder - ein separat trainiertes Paar aus Verkleinerer (Encoder) und Vergrößerer (Decoder) - presst das Bild zunächst in einen viel kleineren Zwischenraum (den Latentraum) und kann es daraus wieder rekonstruieren. Die eigentliche Diffusion läuft dann in diesem kleinen Raum.
| Darstellung | Rechnung | Anzahl Zahlen |
|---|---|---|
| Pixelraum (RGB) | 512 × 512 × 3 | 786.432 |
| Latentraum | 64 × 64 × 4 | 16.384 |
| Verhältnis | 786.432 / 16.384 | 48-mal kleiner |
48-mal weniger Zahlen heißt: deutlich weniger Rechenarbeit pro Diffusionsschritt. Genau dieser Schritt machte hochauflösende Bilderzeugung auf einer einzigen Consumer-Grafikkarte möglich - ein Grund, warum Stable Diffusion im August 2022 als offenes Modell eine so große Verbreitung fand [6]. Der Preis: Der Decoder ist eine verlustbehaftete Rekonstruktion; feine Details wie kleine Schriftzüge gehen dabei teilweise verloren.
Der Bild-Tokenizer: Bilder in Symbole übersetzen
Sprachmodelle zerlegen Text mit einem Tokenizer in Tokens. Für Bilder gibt es ein entsprechendes Verfahren: Ein Bild-Tokenizer zerlegt ein Bild in diskrete Symbole aus einem gelernten Katalog. Die Grundlage legte 2017 das VQ-VAE von van den Oord und Kollegen [3]: Der Encoder verdichtet das Bild auf ein Raster kleiner Kacheln, und jede Kachel wird durch den am besten passenden Eintrag aus einem Codebuch ersetzt - vergleichbar damit, ein Mosaik aus einem festen Sortiment von Steinen nachzubauen.
Das Ergebnis: Ein Bild wird zu einer Sequenz von Symbolen - und kann damit von derselben Transformer-Architektur verarbeitet werden wie Text. Dieser Schritt ist die Voraussetzung dafür, dass heutige multimodale Modelle Bilder nicht nur erzeugen, sondern auch lesen können. Mehr dazu auf der Seite Multimodale Modelle verstehen.
Woher das Modell weiß, was der Prompt will
Damit aus Rauschen ein Bild wird, das zum Text passt, braucht das Modell eine Brücke zwischen Sprache und Bild. Der wichtigste Baustein heißt CLIP (Contrastive Language-Image Pre-training) von OpenAI (2021): CLIP wurde auf rund 400 Millionen Bild-Text-Paaren aus dem Internet trainiert, zueinander passende Paare in der Nähe zueinander in einem gemeinsamen Embedding-Raum zu platzieren - kontrastives Lernen [4]. Danach "weiß" CLIP für jeden Text, wie nahe er an einem Bild liegt.
Bildmodelle nutzen das auf zwei Arten: DALL-E 2 (unCLIP) erzeugt aus dem Text zunächst eine Bild-Einbettung im CLIP-Raum und dekodiert daraus das Bild [5]. Latente Diffusionsmodelle wie Stable Diffusion speisen die Text-Einbettung über sogenannte Cross-Attention in jeden Entrauschungsschritt ein [2]: Das Netz fragt bei jedem Schritt gewissermaßen nach, welche Textteile für die gerade bearbeitete Bildregion relevant sind.
Stile: gelernte Statistik, kein Verstehen
Wenn ein Prompt "im Stil von Ukiyo-e" verlangt, aktiviert das Wort gelernte Assoziationen: flächige Farben, bestimmte Linienführung, typische Motive. Das Modell hat keine Kunstgeschichte gelesen; es hat gesehen, welche Pixelmuster im Training mit diesem Begriff verknüpft waren. Stil ist damit eine Form von Datenkuratierung-Abhängigkeit: Was in den Daten sauber getaggt war, kann das Modell abrufen; was falsch oder gar nicht getaggt war, nicht.
Was das für die Praxis bedeutet
Aus dem Verfahren folgen direkt die bekannten Stärken und Schwächen:
- Variation ist eingebaut: Da der Startpunkt Zufallsrauschen ist, liefert derselbe Prompt jedes Mal ein anderes Ergebnis. Gut für Entwürfe, hinderlich für exakte Reproduktion.
- Artefakte sind systematisch: Hände, Zähne, geschriebener Text und physikalische Details (Schatten, Spiegelungen) sind statistisch schwierig. Man kann sie als das visuelle Gegenstück zu Halluzinationen bei Sprachmodellen lesen: plausibel wirkende, aber falsche Ausgaben.
- Prompts steuern Wahrscheinlichkeiten, keine Befehle: Jedes Stichwort verschiebt, welche Muster wahrscheinlicher werden. Deshalb funktioniert Prompting bei Bildern anders als bei Text - Details dazu in Bild-KI in der Praxis.
- Bias aus den Trainingsdaten bleibt erhalten: Wer in den Daten unterrepräsentiert ist (Berufe, Hauttöne, Regionen), wird verzerrt dargestellt; die Anbieter dokumentieren das in ihren Modellkarten und System Cards.
Einordnung
Diffusionsmodelle sind der aktuelle Stand der Technik für Bilderzeugung, aber nicht der einzige Weg: Autoregressive Modelle erzeugen Bilder Token für Token wie einen Text, und Forschungsansätze wie Konsistenzmodelle versuchen, die vielen Entrauschungsschritte abzukürzen. Für den Alltag reicht die Grundregel: Hinter jedem KI-Bild steht ein Entrauschungsprozess über gelernten Statistiken. Wer das verinnerlicht, wundert sich weder über die Qualität der Treffer noch über die Hartnäckigkeit der Fehler.
Methode
Grundlage sind die Originalarbeiten zu DDPM, Latent Diffusion, VQ-VAE und CLIP sowie die Veröffentlichungen zu DALL-E 2 und Stable Diffusion, alle abgerufen am 20. Oktober 2026. Die Zahlenrechnung zum Latentraum ist eine eigene Rechnung aus den im Latent-Diffusion-Papier genannten Parametern (Kompressionsfaktor 8, 4 Kanäle).
Grenzen
- Die Architektur-Beschreibungen vereinfachen bewusst: Details wie U-Net-Aufbau, Classifier-Free Guidance und Sampler-Varianten sind ausgelassen.
- Die genannten Werkzeuge entwickeln sich schnell; die Grundprinzipien (Diffusion, Latentraum, Tokenisierung) sind stabiler als einzelne Modellversionen.
- Wir haben die zitierten Paper gelesen, aber keine eigenen Trainingsläufe durchgeführt; Aussagen über Trainingsverhalten stützen sich auf die Originalliteratur.
Quellen
- Denoising Diffusion Probabilistic Models (Ho, Jain, Abbeel, 2020), arXiv (abgerufen 2026-10-20) ↩1 ↩2
- High-Resolution Image Synthesis with Latent Diffusion Models (Rombach et al., 2022), arXiv (abgerufen 2026-10-20) ↩1 ↩2 ↩3
- Neural Discrete Representation Learning / VQ-VAE (van den Oord, Vinyals, Kavukcuoglu, 2017), arXiv (abgerufen 2026-10-20) ↩
- Learning Transferable Visual Models From Natural Language Supervision / CLIP (Radford et al., 2021), arXiv (abgerufen 2026-10-20) ↩
- Hierarchical Text-Conditional Image Generation with CLIP Latents / DALL-E 2 (Ramesh et al., 2022), arXiv (abgerufen 2026-10-20) ↩
- Stable Diffusion Public Release, Stability AI (abgerufen 2026-10-20) ↩