 KI
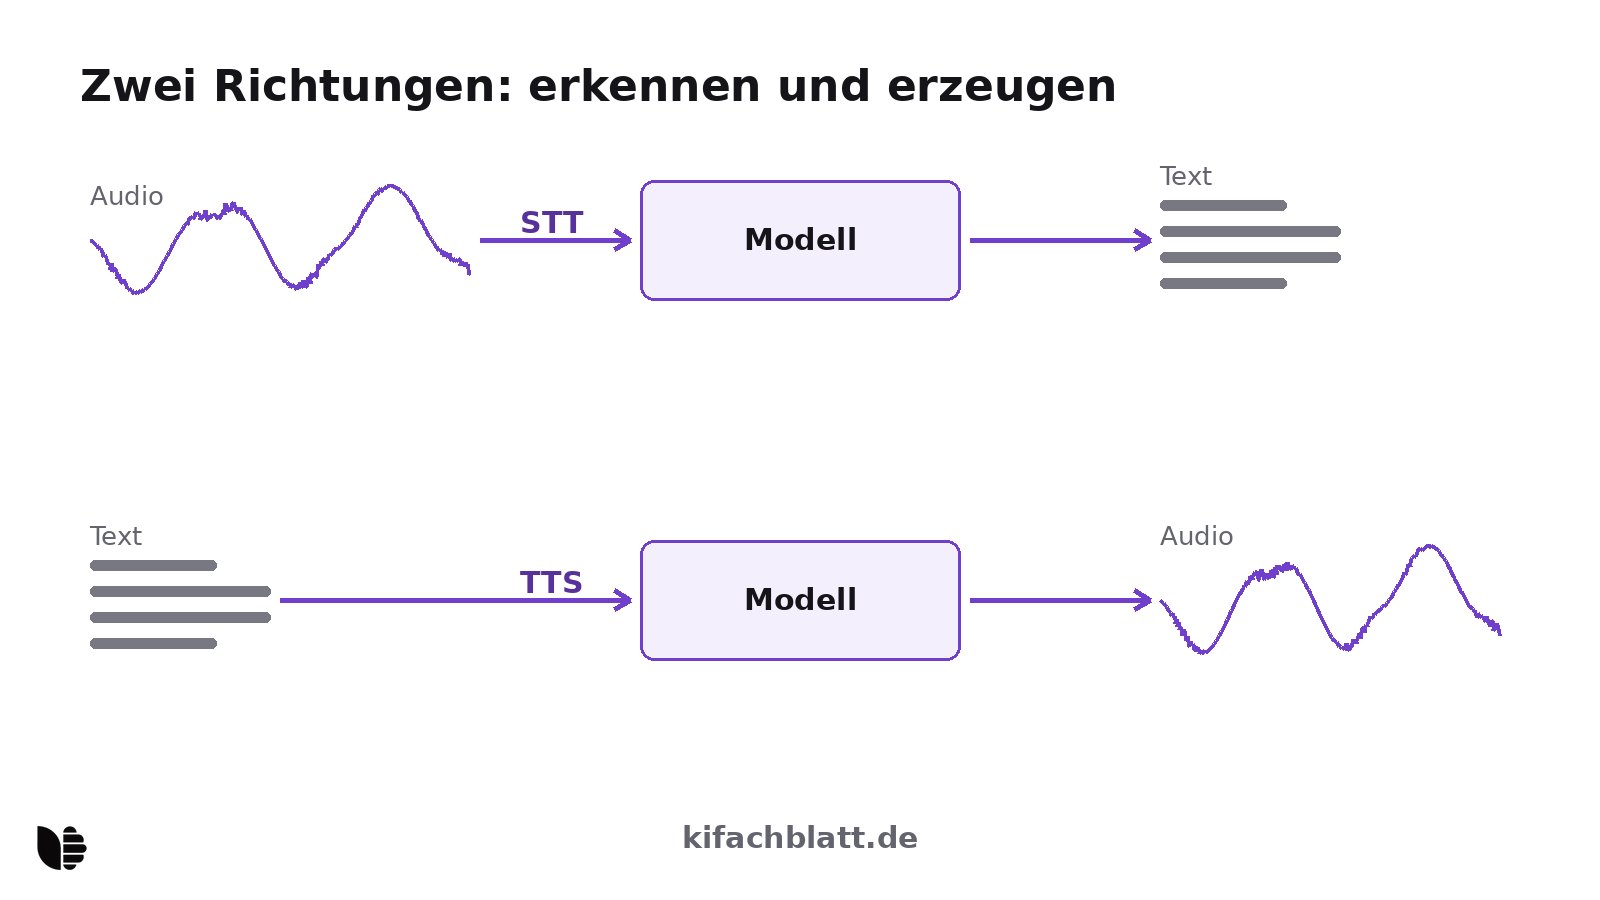
Audio-KI hat zwei Hauptrichtungen, die oft verwechselt werden: Speech-to-Text (STT) macht aus gesprochener Sprache geschriebenen Text; Text-to-Speech (TTS) macht aus Text gesprochene Sprache. Beide sind heute neuronale Modelle, beide sind in Alltagswerkzeuge eingezogen - von der Diktierfunktion bis zum vertonten Artikel. Diese Seite erklärt die Funktionsweise, den Stand und die Risiken, inklusive der heikelsten Anwendung: dem Stimmklon.
Sprache erkennen: Wie STT funktioniert
Spracherkennung zerlegt das Audiosignal zunächst in kurze Abschnitte und wandelt sie in Spektrogramme um - Bilder, die zeigen, welche Frequenzen wann wie stark vorkommen. Ein Modell übersetzt diese Muster dann Schritt für Schritt in Text. Der Maßstab der letzten Jahre ist Whisper von OpenAI (2022): trainiert auf 680.000 Stunden mehrsprachiger Audiodaten aus dem Netz, ohne dass jede Aufnahme von Hand fein annotiert worden wäre ("schwache Überwachung") [1]. Gerade diese Datenbreite macht das Modell robust gegen Akzente, Störgeräusche und Fachvokabular - Aufgaben, an denen ältere, sauber annotierte Systeme scheiterten.
Praktisch heißt das: Interviews, Meetings und Podcasts lassen sich heute in brauchbarer Qualität transkribieren, lokal oder per API [2]. Bleibende Schwächen: sehr leise oder überlagerte Sprache, seltene Eigennamen und Fachbegriffe (hier hilft ein Kontext-Hinweis im Prompt der API) und das zeitliche Zuordnen von Sprechern (Diarisierung), das nicht jedes Modell mitliefert.
Sprache erzeugen: moderne TTS-Modelle
Klassische Sprachsynthese kettete aufgenommene Laut-Schnipsel aneinander - das Ergebnis klang nach Ansage am Bahnhof. Moderne TTS-Modelle lernen dagegen die Abbildung von Text auf Sprachmerkmale (Melodie, Rhythmus, Klang) und erzeugen die Wellenform direkt. Aktuelle Systeme wie ElevenLabs Eleven v3 oder die Stimmen in der OpenAI-API steuern zusätzlich Ausdruck: Pausen, Betonung, Emotion, teils über Regieanweisungen im Text [2][3].
Für die Praxis heißt das: Artikel-Vorlesefunktionen, Videosprecher und Telefon-Assistenten sind mit TTS heute produktiv machbar. Die Qualitätsfrage hat sich verschoben - von "klingt roboterhaft" zu "klingt generisch". Eine unverwechselbare Markenstimme erfordert entweder Sprecherinnen und Sprecher oder einen Stimmklon - und damit den nächsten Abschnitt.
Stimmklone: was technisch passiert
Ein Stimmklon (Voice Cloning) verdichtet die charakteristischen Merkmale einer Stimme - Klangfarbe, Sprechweise, Akzent - aus einer Referenzaufnahme in eine kompakte Repräsentation. Mit wenigen Sekunden bis Minuten Material erzeugt das TTS-Modell dann beliebige neue Sätze in dieser Stimme. Technisch ist das dieselbe Kategorie wie das Fine-Tuning oder Conditionieren auf Referenzdaten: Das Basismodell kann sprechen, die Referenz sagt ihm, wer spricht.
Legitime Anwendungen gibt es viele: Menschen mit Sprachverlust sichern ihre eigene Stimme, Verlage vertonen mit einer festen Markenstimme, Übersetzungen behalten die Originalstimme. Die Schattenseite ist offensichtlich: Eine geklonte Stimme ohne Einwilligung ist ein Betrugswerkzeug - etwa für den "Enkeltrick" per KI oder gefälschte Freigaben am Telefon.
Die Anbieter reagieren darauf unterschiedlich streng: ElevenLabs beschreibt auf seiner Safety-Seite Maßnahmen wie Verifizierung der Stimmberechtigung, Erkennung eigener generierter Audios und Sperrlisten [4]. OpenAI beschränkt das Klonen in seinen Produkten auf vordefinierte beziehungsweise geprüfte Stimmen und dokumentiert Sicherheitsvorkehrungen in der Audio-Dokumentation [2]. Für Redaktionen gilt: Wer eine Markenstimme klont, sichert die schriftliche Zustimmung der Sprecherin oder des Sprechers und dokumentiert Herkunft und Umfang der Referenzaufnahmen.
Praxis: wofür sich was eignet
| Aufgabe | Richtung | Typische Werkzeuge | Reifegrad |
|---|---|---|---|
| Interviews und Meetings transkribieren | STT | Whisper-basierte Dienste, APIs [1][2] | Standardware, Korrekturlesen bleibt Pflicht |
| Artikel und Newsletter vertonen | TTS | OpenAI TTS, ElevenLabs [2][3] | Produktiv einsetzbar, Stimmwahl beachten |
| Videos synchronisieren | TTS + Übersetzung | Spezialdienste mit Stimmübertrag | Brauchbar, Abnahme durch Menschen nötig |
| Eigene Stimme klonen | TTS mit Referenz | ElevenLabs u. a. [3][4] | Möglich, nur mit Einwilligung und Doku |
| Barrierefreiheit (Vorlesen, Echtzeit-Untertitel) | STT + TTS | Betriebssystem-Funktionen, APIs | Weitgehend gelöst und empfohlen |
Zwei Faustregeln: Erstens ist Erkennen (STT) einfacher als Erzeugen (TTS) - wer nur Text aus Audio braucht, bekommt das zuverlässig und günstig. Zweitens steigt der Prüfaufwand mit der Publikumswirkung: Ein internes Protokoll verzeiht Erkennungsfehler, eine veröffentlichte Vertonung braucht Abnahme wie jeder andere Content auch.
Einordnung
Audio-KI ist erwachsen geworden: Erkennen ist Standard, Erzeugen ist produktionsreif, Klonen ist mächtig und heikel. Wer die zwei Richtungen auseinanderhält, die Einwilligungsfrage bei Stimmen ernst nimmt und Ergebnisse wie jeden anderen Rohling prüft, nutzt die Technik dort, wo sie heute schon trägt. Wie solche Audio-Bausteine mit Bild und Text in einem Modell zusammenlaufen, erklärt Multimodale Modelle verstehen.
Methode
Grundlage sind das Whisper-Paper von OpenAI (2022), die Audio-Dokumentation der OpenAI-API sowie die Produkt- und Safety-Seiten von ElevenLabs, alle abgerufen am 20. Oktober 2026. Die Praxis-Tabelle ist eine redaktionelle Einordnung, keine Benchmark-Messung.
Grenzen
- Der Markt für Audio-KI bewegt sich schnell; Modellnamen und Funktionsumfänge gelten für den Abrufzeitpunkt.
- Wir haben keine eigenen Vergleichsmessungen der Erkennungs- oder Sprachqualität durchgeführt; Qualitätsaussagen stützen sich auf die zitierten Quellen und redaktionelle Erfahrung.
- Rechtliche Hinweise (Einwilligung, Persönlichkeitsrecht) sind eine Einordnung, keine Rechtsberatung; siehe auch DSGVO und KI.
Quellen
- Robust Speech Recognition via Large-Scale Weak Supervision / Whisper (Radford et al., 2022), arXiv (abgerufen 2026-10-20) ↩1 ↩2
- Audio and speech (API-Dokumentation), OpenAI (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4 ↩5
- Eleven v3 is Now Generally Available, ElevenLabs (abgerufen 2026-10-20) ↩1 ↩2 ↩3
- Safety, ElevenLabs (abgerufen 2026-10-20) ↩1 ↩2