 KI
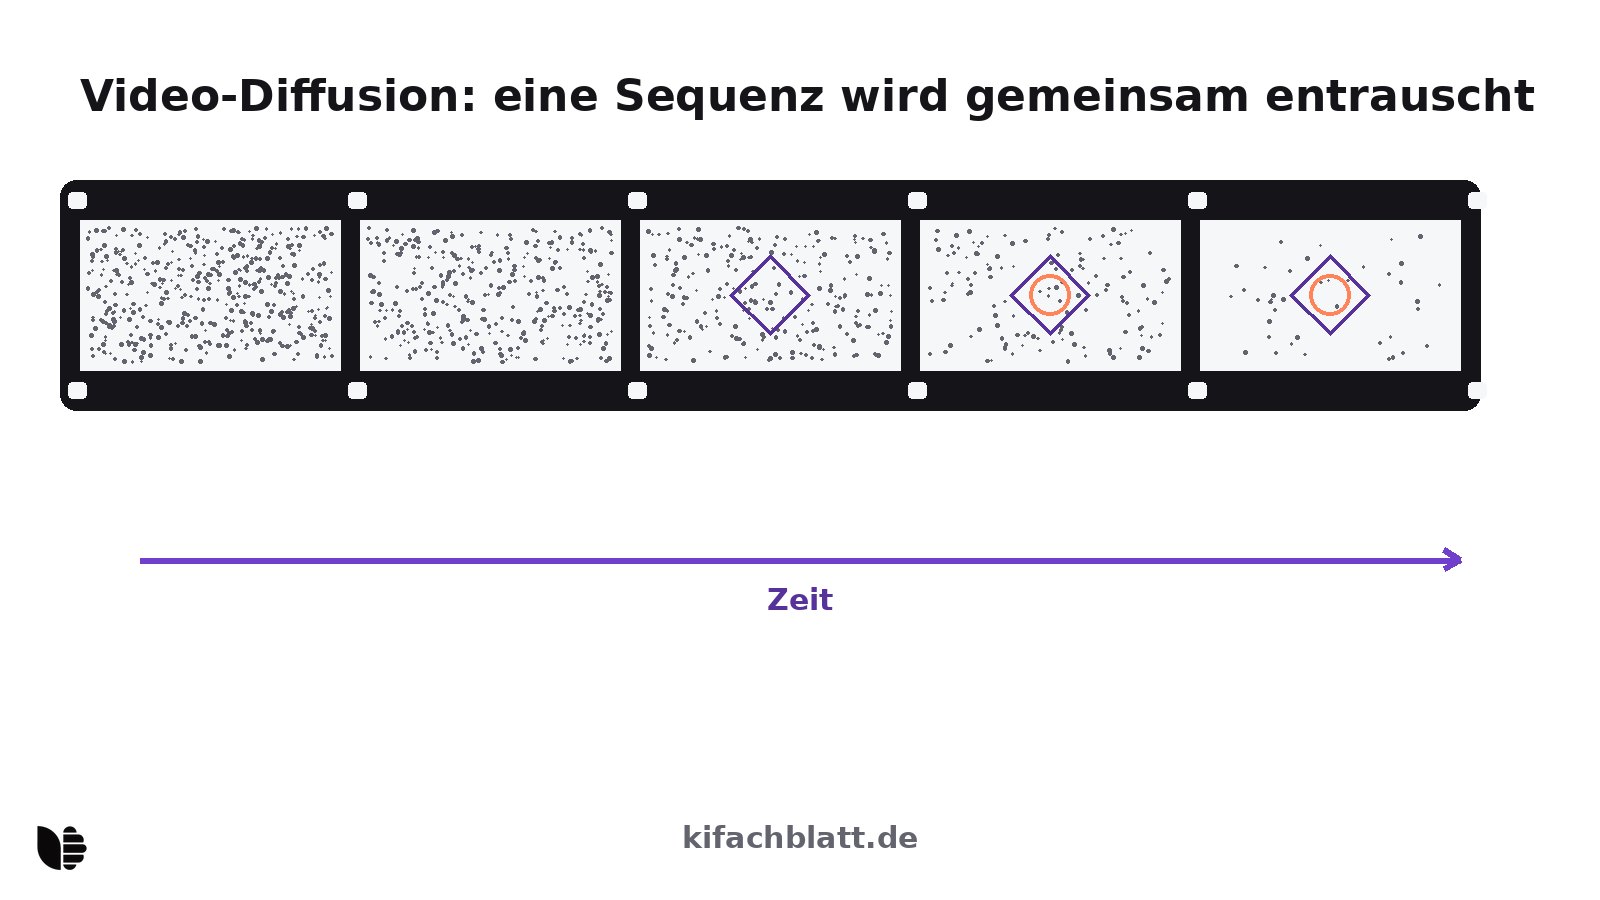
Video-KI ist das jüngste und beweglichste Feld der generativen Medienmodelle - im wörtlichen und im Markt-Sinn. Wer 2024 oder 2025 mit Sora experimentiert hat, muss heute umdenken: OpenAI hat die Video-Plattform im März 2026 eingestellt, inklusive eines mit Disney vereinbarten Großdeals [1][2]. Diese Seite sortiert den Stand Oktober 2026: welche Werkzeuge tragen, wie die Technik funktioniert und wo die Grenzen liegen. Wie Bildmodelle grundsätzlich lernen, erklärt Wie Bildmodelle lernen.
Der Markt nach dem Sora-Aus
Am 24. März 2026 berichteten Agenturen übereinstimmend, dass OpenAI Sora abschaltet [1][2]. Für Anwender ändert das die Landkarte: Die meistgenannten Alternativen sind derzeit Googles Veo 3.1 [3], Runways Gen-4.5 [4] und Kling 3.0 des chinesischen Anbieters Kuaishou [5].
| Werkzeug | Anbieter | Charakteristik |
|---|---|---|
| Veo 3.1 | Google DeepMind | Text- und Bild-zu-Video, starker Fokus auf physikalische Plausibilität und Audio [3] |
| Runway Gen-4.5 | Runway | Kreativ-Werkzeugkasten für Filmschaffende, Text-zu-Video mit Editor-Workflow [4] |
| Kling 3.0 | Kuaishou | Text- und Bild-zu-Video, lange Clips, große Nutzerbasis in Asien [5] |
Wie Video-Modelle arbeiten
Die meisten Video-Modelle sind Diffusionsmodelle mit einer zusätzlichen Dimension: Statt ein einzelnes Bild zu entrauschen, entrauschen sie einen Block aus vielen Einzelbildern (Frames) gleichzeitig - über Raum und Zeit. Ein Text-to-Video-Modell bekommt den Prompt als Steuerung, wie beim Bildmodell über Text-Einbettungen; bei Bild-zu-Video kommt ein Startbild als weitere Bedingung dazu. Die technischen Grundlagen (Rauschen, Entrauschen, Latentraum) sind dieselben wie bei Bildmodellen [6].
Die Zeitdimension ist auch der Grund, warum Video so viel schwerer ist als Bild: Das Modell muss nicht nur plausible Pixel liefern, sondern plausible Veränderung - Bewegung, Perspektivwechsel, das Fortbestehen von Objekten. Eine Analogie: Ein Bildmodell malt ein überzeugendes Standbild, ein Videomodell muss zusätzlich Regie führen.
Was die Werkzeuge heute können
- Kurze Clips aus Text: einige Sekunden bis hin zu rund einer Minute je nach Modell und Einstellung, in sozialen Formaten und in HD.
- Bild-zu-Video: Ein vorhandenes Bild (etwa ein generiertes Standbild) wird animiert - der zuverlässigste Weg zu optischer Konsistenz.
- Stimmungen und Stil: Lichtstimmungen, Kamerafahrten und Kunststile sind die größte Stärke; Werbe- und Social-Motive sind die häufigste Anwendung.
- Zunehmend Audio: Modelle wie Veo 3.1 erzeugen Tonspuren (Geräusche, teils Dialoge) direkt mit [3].
Woran sie scheitern
- Physik: Flüssigkeiten, Stoffe, Kollisionen und Schwerkraft wirken bei genauem Hinsehen oft falsch - das Modell ahmt Bewegungsstatistik nach, es simuliert nicht.
- Kontinuität: Objekte und Personen verändern sich über die Zeit (Kleidung, Anzahl der Finger, Hintergrunddetails), besonders über Schnitte hinweg.
- Text und Logos: Wie bei Bildmodellen ist gerenderte Schrift unzuverlässig; Markenzeichen gehören nicht in generierte Clips.
- Lange Bögen: Narrative mit Anfang und Ende, Dialoge mit Timing und konsistente Figuren über viele Einstellungen sind weiterhin Handarbeit im Schnitt.
Der Praxis-Workflow
Wer heute mit Video-KI arbeitet, denkt in Einstellungen, nicht in Filmen:
- Storyboard: Den Clip in Einzelshots von wenigen Sekunden zerlegen; pro Shot ein Prompt.
- Stil-Anker: Ein Referenzbild oder einen festen Prompt-Baustein für alle Shots nutzen, damit die Optik zusammenpasst.
- Varianten: Pro Shot mehrere Generierungen; die Trefferquote pro Shot ist gut, die für eine ganze Sequenz nicht.
- Schnitt: Die Einzelclips im Schnittprogramm zum Film fügen; Text, Grafik und Ton dort ergänzen, nicht im Prompt.
Preislich arbeiten fast alle Anbieter mit Abos oder Credits pro Sekunde; wegen der schnellen Änderungen verlinken wir statt Zahlen die Herstellerseiten [3][4][5]. Eigene Rechnung lohnt sich trotzdem: Überschlage die erzeugten Sekunden Rohmaterial pro fertiger Sekunde Film - Erfahrungswerte der Branche sprechen von einem Vielfachen des Endprodukts.
Recht und Kennzeichnung
Bei bewegtem Bild mit Ton ist das Täuschungspotenzial besonders hoch (Stichwort Deepfakes). Zwei Regeln gehören deshalb in jeden Workflow: sichtbare Kennzeichnung ("KI-generiert") und maschinenlesbare Herkunftsnachweise nach C2PA, wo die Werkzeuge sie einbetten [7]. Rechtsfragen - von Urheberrecht an Stil und Ausgabe bis zu Persönlichkeitsrechten abgebildeter Menschen - behandeln wir einzeln auf Urheberrecht und Kennzeichnung bei KI-Medien; dort wie hier gilt: keine Rechtsberatung, Stand beachten.
Einordnung
Video-KI ist kein Film-Automat, sondern ein sehr starkes Werkzeug für kurze, stimmungsvolle Einstellungen. Der Sora-Ausstieg von OpenAI zeigt zugleich, wie jung und volatil dieser Markt ist: Werkzeugentscheidungen sollten kurze Bindungsfristen und exportierbare Ergebnisse haben. Für den Überblick über den gesamten Medienmix empfiehlt sich der Lernpfad Kreative: Bild-, Audio- und Video-KI.
Methode
Grundlage sind Berichte von Reuters und BBC zur Sora-Einstellung (März 2026) sowie die Produkt- und Dokumentationsseiten von Google DeepMind, Runway und Kuaishou, alle abgerufen am 20. Oktober 2026. Die Funktionsweise der Video-Diffusion folgt der Beschreibung der Bild-Diffusion in [6]. Der Workflow ist redaktionelle Praxiserfahrung, keine Messung.
Grenzen
- Wir haben die genannten Modelle nicht systematisch selbst vermessen; Fähigkeitsangaben stützen sich auf Herstellerangaben und Berichterstattung.
- Preise, Limits und Verfügbarkeit ändern sich laufend und werden bewusst nicht genannt.
- Rechtliche Hinweise sind Einordnung, keine Rechtsberatung.
Quellen
- OpenAI drops AI video tool Sora, startling Disney, sources say, Reuters (abgerufen 2026-10-20) ↩1 ↩2
- Sora: OpenAI closes AI video app and cancels $1bn Disney deal, BBC News (abgerufen 2026-10-20) ↩1 ↩2
- Veo 3.1, Google DeepMind (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4 ↩5
- Runway Gen-4.5: State-of-the-Art AI Video Generation, Runway (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4
- Kling AI Launches 3.0 Model, Kuaishou Technology (Investor Relations) (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4
- High-Resolution Image Synthesis with Latent Diffusion Models (Rombach et al., 2022), arXiv (abgerufen 2026-10-20) ↩1 ↩2
- Coalition for Content Provenance and Authenticity (C2PA), C2PA (abgerufen 2026-10-20) ↩