 KI
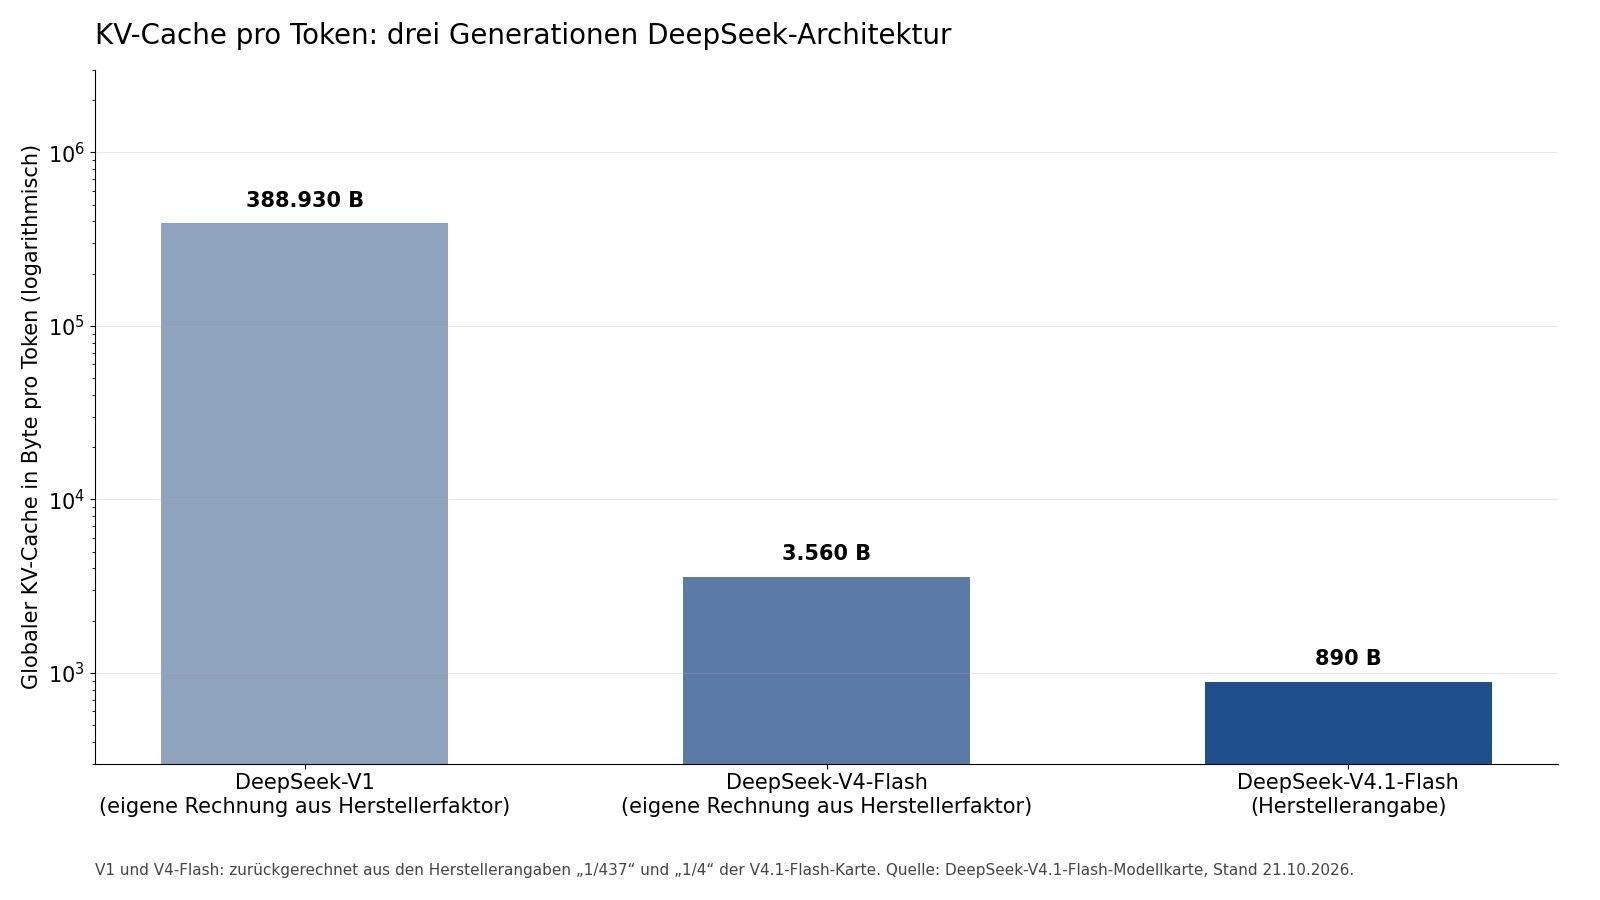
Ein Kontextfenster von einer Million Token ist bei aktuellen Modellen fast schon Standard. Was auf dem Datenblatt wie eine kostenlose Großzügigkeit wirkt, hat im Rechenzentrum einen konkreten Preis: Jedes Token im Kontext hinterlässt im KV-Cache Zahlen, und dieser Speicher muss bei jedem einzelnen erzeugten Antwort-Token gelesen werden. DeepSeek hat mit der Modellkarte von V4.1-Flash jetzt eine Zahl in den Raum gestellt, die zeigt, wie weit die Optimierung gediehen ist: 890 Byte globaler KV-Cache pro Token, laut Hersteller etwa ein Viertel von V4-Flash und rund 1/437 der ersten Modellgeneration [1].
Dieser Artikel legt die Mechanik dahinter offen: Warum der Cache zum Engpass wird, welche Stellschrauben die Forschung dagegen gefunden hat und was die DeepSeek-Zahlen konkret bedeuten. Alle Architektur- und Effizienzangaben stammen aus den Modellkarten und Originalpapieren; wo wir daraus Folgerungen ableiten, ist das als eigene Rechnung mit Formel gekennzeichnet. Wer die Begriffe nachschlagen will: Der Artikel verlinkt an den wichtigen Stellen in unser Glossar.
Warum der KV-Cache der Flaschenhals ist
Beim Erzeugen von Text arbeitet ein Sprachmodell Schritt für Schritt: Für jedes neue Token muss es auf alle bisherigen Token zurückblicken. Technisch passiert das über die Attention: Für jedes vergangene Token wurden bei der Verarbeitung zwei Vektoren gespeichert, Schlüssel und Wert (Key und Value), und zwar pro Schicht und pro Attention-Kopf des Modells. Diese gespeicherten Vektoren sind der KV-Cache. Ohne ihn müsste das Modell bei jedem neuen Token den gesamten bisherigen Text von Grund auf neu rechnen, was unbezahlbar wäre. Mit ihm wird das Nachschlagen zum Speicherproblem.
Der Cache hat drei unangenehme Eigenschaften. Erstens wächst er linear mit der Kontextlänge: Doppelt so viel Text heißt doppelt so viel Cache. Zweitens liegt er im schnellen, teuren Grafikspeicher (HBM) der GPU, denn nur dort ist er schnell genug abrufbar; die Speicherbandbreite-Grenze dieses Speichers ist der physikalische Rahmen, in dem alles Weitere stattfindet. Drittens muss er bei jedem Decode-Schritt komplett gelesen werden: Die Autoren des GQA-Papers beschreiben genau das als den Engpass des autoregressiven Dekodierens, nämlich die Speicherbandbreite, die das Laden der Modellgewichte und aller Schlüssel- und Wertvektoren bei jedem Schritt kostet [4]. Bei kurzen Antworten fällt das kaum ins Gewicht. Bei einem Kontext von einer Million Token und tausenden gleichzeitigen Nutzeranfragen wird der Cache zur zentralen Ressource, über die Durchsatz, Latenz und Preis entschieden werden.
Dazu kommt eine Asymmetrie, die DeepSeek in der V4.1-Karte explizit macht: Das Einlesen des Kontexts (Prefill) und das schrittweise Schreiben der Antwort (Decode) belasten das System unterschiedlich. Agentische Arbeitslasten sind eingabelastig: Ein Coding-Agent schiebt Repositories, Logs und Werkzeugausgaben in den Kontext und erzeugt vergleichsweise kurze Antworten. Genau dafür ist die neue Architektur ausgelegt, mit nur 8 Milliarden aktiven Parametern beim Einlesen gegenüber 16 Milliarden beim Schreiben [1]. Die Cache-Frage ist also nicht nur eine Speicherfrage, sondern eine Frage der gesamten Kostenstruktur von Agenten.
Dass die Industrie diesen Punkt ernst nimmt, zeigt die Release-Logik der letzten zwei Jahre: Kaum eine Architekturankündigung kommt ohne Angabe zur Cache-Größe aus. DeepSeek bewirbt V4.1-Flash ausdrücklich mit der KV-Cache-Kompression im Titel der Modellkarte [1], und schon die V4-Serie führte ihre Hybrid-Attention mit der Angabe ein, bei einer Million Token nur noch 27 Prozent der Rechenoperationen und 10 Prozent des Cache von V3.2 zu benötigen [2].
Die Rechnung hinter dem Cache
Was bedeuten 890 Byte pro Token in der Praxis? Drei einfache Umrechnungen machen die Größenordnungen greifbar. Alle drei sind eigene Rechnungen auf Basis der Herstellerangaben; die Formeln stehen im Methodenteil.
Die letzte Zeile dieser Rechnung ist der wirtschaftliche Kern. Nicht die Frage, ob eine Million Token Kontext technisch möglich ist, entscheidet über den Alltag, sondern wie viele solcher Konversationen ein Betreiber gleichzeitig auf einer Karte unterbringt. Die Anzahl paralleler Konversationen bestimmt den Durchsatz pro Hardware-Euro, und der wiederum fließt in den Preis pro Token. Zwischen V1- und V4.1-Niveau liegt bei sonst gleichen Bedingungen ein Faktor von rund 437 bei der gleichzeitig bedienbaren Nutzerzahl, jedenfalls was den Cache-Anteil betrifft. Modellgewichte, Aktivierungen und Systempuffer kommen noch obendrauf, ändern aber nichts an der Richtung.
Zur Einordnung der Größenordnung: Eine gut gefüllte Konversation in einem Agenten-Einsatz hat eher 100.000 als eine Million Token. Dann wiegt der Cache pro Konversation bei V4.1-Flash noch rund 89 Megabyte, bei V1-Niveau dagegen schon rund 39 Gigabyte (ebenfalls eigene Rechnung, dieselbe Formel). Der Unterschied entscheidet darüber, ob ein Anbieter lange Kontexte als Standard oder als Premiumfunktion verkaufen kann.
Daten als Tabelle
| Konversationen pro 80 GB | |
|---|---|
| DeepSeek-V1 (eigene Rechnung) | 0,2 |
| DeepSeek-V4-Flash (eigene Rechnung) | 22 |
| DeepSeek-V4.1-Flash (Herstellerangabe) | 90 |
Eigene Rechnung: 80 GB geteilt durch Cache pro Konversation (Bytes pro Token mal 1.000.000 Token). Nur der Cache-Anteil, ohne Modellgewichte und Puffer; Basis sind die Herstellerfaktoren aus [1].
Stellschraube 1: Weniger Köpfe, geteilte Schlüssel (GQA und MQA)
Der erste Hebel sitzt in der Attention selbst. Ein klassischer Transformer speichert pro Attention-Kopf eigene Schlüssel- und Wertvektoren; bei 32, 64 oder 128 Köpfen multipliziert sich der Cache entsprechend. Multi-Query-Attention (MQA), 2019 von Noam Shazeer vorgeschlagen, radikalisiert die Idee des Teilens: Alle Abfrageköpfe nutzen ein einziges Schlüssel- und Wertpaar, der Cache schrumpft auf den Anteil eines Kopfes [4]. Der Preis: messbare Qualitätseinbußen, weil die Vielfalt der Perspektiven verloren geht, und der Zwang, das Modell von Grund auf so zu trainieren.
Grouped-Query-Attention (GQA) wählt die Mitte: Gruppen von Abfrageköpfen teilen sich je ein Schlüssel-Wert-Paar. Das Paper von Ainslie und Kollegen lieferte zwei praxistaugliche Ergebnisse: Erstens lässt sich ein vorhandenes Multi-Head-Modell mit nur fünf Prozent des ursprünglichen Trainingsaufwands auf die neue Struktur umtrainieren; zweitens erreicht das so gewonnene GQA-Modell Qualität nahe am Ausgangsmodell bei Geschwindigkeit nahe an MQA [4]. Genau diese Kombination, geringe Umstellungskosten und kaum Qualitätsverlust, machte GQA zum Quasi-Standard.
Praktisch jedes aktuelle offene Modell nutzt eine Variante davon. Mistral 7B kombinierte 2023 GQA mit Sliding-Window-Attention ausdrücklich für schnellere Inferenz, geringeren Speicherbedarf beim Dekodieren und damit höhere Stapelgrößen (Batching), was das Paper als entscheidend für Echtzeitanwendungen bezeichnet [5]. Für den Cache heißt das: Der Faktor, um den GQA den Speicher drückt, ist das Verhältnis von Abfrageköpfen zu Schlüsselköpfen. Acht Schlüsselköpfe statt 128 bedeuten ein Sechzehntel des Attention-Cache, ohne dass am Rest des Modells etwas geändert werden muss.
Stellschraube 2: Komprimieren statt teilen (DeepSeek MLA)
DeepSeek ging ab V2 einen anderen Weg: Statt Köpfe zu teilen, werden Schlüssel und Werte gemeinsam in einen niedrigdimensionalen latenten Vektor komprimiert (Multi-head Latent Attention, MLA). Im Cache liegt nur noch dieser komprimierte Vektor; die eigentlichen Schlüssel und Werte werden bei Bedarf daraus rekonstruiert. Laut V2-Paper senkte das den KV-Cache um 93,3 Prozent gegenüber dem Vorgänger DeepSeek 67B, steigerte den maximalen Generierungsdurchsatz auf das 5,76-Fache und senkte nebenbei die Trainingskosten um 42,5 Prozent [3]. Im produktiven Einsatz kam laut Papier noch eine Quantisierung der Cache-Elemente auf durchschnittlich 6 Bit dazu [3].
Das Paper macht die Größenordnung der Einsparung auch in Hardware-Stunden greifbar: Pro Billion Trainings-Token brauchte DeepSeek 67B auf dem H800-Cluster 300.600 GPU-Stunden, DeepSeek-V2 nur 172.800 [3]. Im Einsatz erreichte V2 auf einem Knoten mit acht H800-GPUs über 50.000 erzeugte Token pro Sekunde, das 5,76-Fache des Vorgängers, bei über 100.000 Eingabe-Token pro Sekunde [3].
MLA ist bemerkenswert, weil es die übliche Tauschrelation bricht: GQA und MQA kaufen Speicher mit Qualitätsverlust, das V2-Paper berichtet dagegen für MLA gleichzeitig bessere Werte als klassische Multi-Head-Attention und einen kleineren Cache [3]. Diese Kombination erklärt, warum die DeepSeek-Linie seit V2 als Referenz für speichereffiziente Architektur gilt, und sie bildet die Vorgeschichte der Zahlen, mit denen V4.1-Flash jetzt wirbt [1][3].
Stellschraube 3: Fenster statt Vollgriff (Sliding-Window-Attention)
Die dritte Idee verzichtet auf Vollständigkeit: Sliding-Window-Attention lässt jedes Token nur auf ein festes Fenster der letzten W Token blicken statt auf die ganze Sequenz. Mistral 7B setzte W auf 4096. Weil die Schichten gestapelt sind, wandert Information trotzdem weiter: In jeder Schicht kann ein Token W Positionen zurückgreifen, nach k Schichten also k mal W; bei Mistral ergibt das einen theoretischen Aufmerksamkeitsradius von rund 131.000 Token [5]. Das Fenster begrenzt also die direkte Sicht, nicht den gesamten Informationsfluss.
Der Cache-Effekt ist drastisch: Mit einem rollierenden Puffer (Rolling Buffer Cache), der alte Einträge einfach überschreibt, wächst der Cache gar nicht mehr mit der Sequenzlänge, sondern bleibt auf die Fenstergröße begrenzt. Mistral beziffert die Einsparung bei einer 32.000-Token-Sequenz auf das Achtfache, ohne messbare Qualitätseinbuße; dazu kamen rund zweifach schnellere Ausführung bei 16.000 Token durch angepasste Kernroutinen auf Basis von FlashAttention und xFormers [5]. Für das Einlesen langer Dokumente beschreibt das Paper außerdem das Chunking: Der Prompt wird in fenstergroße Stücke zerlegt und Stück für Stück in den Puffer gefüllt [5].
Der Haken liegt auf der Hand: Was außerhalb des Fensters liegt, ist für die direkte Aufmerksamkeit weg. Für Aufgaben, die jedes Wort des gesamten Kontexts brauchen, ist das Fenster ein Kompromiss, kein Gratisgewinn. DeepSeek wird dieses Prinzip später in verfeinerter Form wieder aufgreifen (dazu gleich mehr).
Stellschraube 4: Aufräumen wie ein Betriebssystem (PagedAttention)
Die vierte Stellschraube ändert nichts am Modell, sondern an der Speicherverwaltung. Klassische Inferenzsysteme reservierten für jede Anfrage einen zusammenhängenden Speicherblock in der maximalen Antwortlänge. Das vLLM-Paper benennt drei Arten von Abfall, die dabei entstehen: Reservierung für nie erreichte Längen, interne Fragmentierung innerhalb des Blocks und externe Fragmentierung zwischen den Blöcken. Gemessen wurde das Ausmaß: Nur 20,4 bis 38,2 Prozent des reservierten KV-Speichers enthielten in den untersuchten Systemen tatsächlich Token-Zustände [6].
Die Lösung übernahm das Prinzip der virtuellen Speicherverwaltung aus Betriebssystemen: PagedAttention teilt den Cache in Blöcke fester Größe, verteilt sie bei Bedarf nicht zusammenhängend und erlaubt das Teilen von Blöcken zwischen Sequenzen, etwa bei parallelem Sampling oder Beam Search, wo mehrere Kandidaten denselben Anfang teilen [6]. Das Ergebnis laut Paper: nahezu null Verschnitt und zwei- bis vierfacher Durchsatz gegenüber den damaligen Referenzsystemen, ohne jede Änderung an Modell oder Ergebnisqualität [6]. Die Lektion für die Praxis: Ein guter Teil der vermeintlichen Modellkosten war schlicht schlechte Speicherbuchhaltung. Wer heute Inferenz selbst betreibt, stellt diese Frage über den Serving-Stack, nicht über die Modellwahl.
Daten als Tabelle
| Tatsächlich belegt | |
|---|---|
| Minimaler Anteil | 20,4 |
| Maximaler Anteil | 38,2 |
Messwerte aus dem vLLM-Paper (Profilbilder verschiedener Serving-Systeme); PagedAttention zielt laut den Autoren auf nahezu null Verschnitt [6].
Der aktuelle Stand: Was DeepSeek in V4 und V4.1 zusammenbaut hat
Vor diesem Hintergrund lesen sich die beiden jüngsten DeepSeek-Karten wie eine Zusammenfassung aller vier Stellschrauben. Die V4-Serie kombinierte zwei komprimierte Attention-Formen (Compressed Sparse Attention und Heavily Compressed Attention) zu einer Hybrid-Architektur und bezifferte den Effekt bei einer Million Token Kontext auf 27 Prozent der Rechenoperationen und 10 Prozent des KV-Cache von V3.2 [2]. Dazu kamen mit den Manifold-Constrained Hyper-Connections stabilisierte Restverbindungen und der Muon-Optimizer für das Training [2].
V4.1-Flash geht weiter und stapelt die Maßnahmen [1]:
- Causal Encoder-Decoder (CED): 40 Schichten, aufgeteilt in 20 kausale Encoder- und 20 Decoder-Schichten. Der globale Cache des Decoders wird aus den Endzuständen des Encoders projiziert statt aus jeder eigenen Schicht. Das senkt die aktiven Parameter beim Einlesen auf 8 Milliarden und beim Schreiben auf 16 Milliarden pro Token, ausgelegt für eingabelastige Agenten-Arbeitslasten.
- Compressed Sparse Attention 2 (CSA2): Jede Attention-Schicht bekommt einen von drei statischen Modi (Full, Reindex, Reuse), sodass Schichten Haupt-Cache und Index teilen und Sparse-Attention-Indizes wiederverwenden. Ein hierarchischer Index begrenzt die Kosten tiefer Schichten unabhängig von der Kontextlänge: Spätere Indexschichten suchen nur noch im Kandidatenpool der ersten Full-Mode-Schicht.
- FP4-Hauptcache: Die Schlüssel- und Wertdaten liegen im E2M1-Format mit einem E4M3-Skalierungsfaktor pro 16 Kanäle vor, also auf etwa 4 Bit quantisiert.
- SWA Bounded Replay: Fenster-Attention nach dem Mistral-Prinzip, aber so organisiert, dass fehlende Fensterzustände durch erneutes Abspielen nur der letzten n_win Token rekonstruiert werden, statt den Fenster-Cache dauerhaft auf Festplatte zu halten. Laut Karte senkt das den persistenten Cache auf etwa ein Achtel von V4-Flash.
- Engram-Speicher und DSpark: Ein konditionaler Speicher mit 196 Milliarden Parametern, der pro Token nur stichprobenartig nachgeschlagene Einträge aktiviert, plus semi-autoregressives Speculative Decoding mit vertrauensgesteuerter Verifikation runden das Paket ab.
Heraus kommen die eingangs genannten 890 Byte pro Token globaler Cache, bei einer Million Token Kontext und einem auf 45 Billionen Token trainierten Modell, dessen Kontext erst bei 34 Billionen Token auf die volle Länge erweitert wurde [1]. Wichtig für die Einordnung: Der Wert ist eine Herstellerangabe aus der eigenen Karte, und die Faktoren 1/4 und 1/437 sind dort mit etwa formuliert [1]. Unsere Rückrechnung auf V1 und V4-Flash ist deshalb eine Größenordnung, keine Messung. Ebenfalls aus der Karte: Die Reasoning-Stärke ist stufenlos von 1 bis 100 einstellbar, und alle berichteten Werte gelten für die maximale Stufe; weniger Denkbudget heißt auch weniger gelesener Kontext pro Antwort.
Radikaler Ausweg: Modelle ganz ohne KV-Cache
Die konsequenteste Antwort auf das Cache-Problem ist, es nicht zu haben. State-Space-Modelle wie Mamba tragen den Kontext in einem Zustand fester Größe, der pro Token aktualisiert wird, statt alle Vergangenheitsvektoren zu speichern. Der Speicherbedarf wächst damit gar nicht mehr mit der Sequenzlänge. Der Trick des Mamba-Papers: Die Zustandsübergänge hängen selbst vom aktuellen Token ab (selektive Zustandsmodelle), sodass das Modell lernen kann, was es behalten und was es vergessen will. Das verhindert zwar den sonst üblichen effizienten Faltungstrick, wird aber durch einen hardwarenahen parallelen Algorithmus aufgefangen [7].
Das Ergebnis laut Paper: fünffacher Durchsatz gegenüber Transformern, lineare Skalierung mit der Sequenzlänge und brauchbare Ergebnisse bis zu Sequenzen von einer Million Elementen; ein Mamba-3B schlug demnach Transformer gleicher Größe und hielt mit doppelt so großen mit [7].
Warum ersetzt das den Transformer nicht flächendeckend? Weil der feste Zustand auch eine Verengung ist: Alles, was das Modell über die Vergangenheit weiß, muss in diesen einen Vektor passen. Attention kann gezielt auf eine beliebige frühere Stelle zugreifen; ein Zustandsmodell muss entschieden haben, was es sich merkt, bevor es weiß, was später gebraucht wird. Genau diese Schwäche, nämlich inhaltsbasiertes Nachschlagen, benennt das Mamba-Paper selbst als den historischen Grund, warum subquadratische Architekturen am Transformer bisher scheiterten [7]. In der Praxis laufen die erfolgreichen aktuellen Ansätze deshalb auf Mischformen hinaus: Transformer mit sparsamer Attention, Fenstern und Kompression, nicht auf den vollständigen Ersatz.
Was das für Preise und Praxis bedeutet
Drei Folgen sind belastbar. Erstens: Langer Kontext wird planbar billiger. Der Cache ist bei Millionstoken-Kontexten der dominierende Speicherposten, und jede Halbierung der Bytes pro Token verdoppelt rechnerisch die Zahl bedienbarer Konversationen pro Karte. DeepSeeks Verlauf von V1 über V2/MLA zu V4.1 zeigt, dass dieser Hebel in zwei Jahren um den Faktor 437 gedreht wurde, Herstellerangaben vorausgesetzt [1][3].
Zweitens: Der Serving-Stack ist Teil der Architekturfrage. vLLM hat gezeigt, dass 60 bis 80 Prozent des reservierten Cache-Speichers in älteren Systemen Buchhaltungsabfall waren [6]. Wer Modelle selbst betreibt, gewinnt unter Umständen mehr durch die Speicherverwaltung als durch die Wahl einer anderen Modellversion. Drittens: Vergleiche brauchen die Fußnoten. Die 890 Byte von V4.1-Flash gelten für den globalen Cache einer bestimmten Architektur mit FP4-Quantisierung; die 93,3 Prozent von MLA galten gegenüber einem konkreten Vorgänger; die achtfache Einsparung von Mistral galt bei 32.000 Token [1][3][5]. Prozentangaben ohne Nenner und Kontextlänge sind Marketing, keine Metrik.
Für Agenten-Workloads kommt ein vierter Punkt dazu: Reasoning-Modelle erzeugen vor der eigentlichen Antwort lange Denkketten, und jedes dieser Denk-Token liest den kompletten Cache erneut. Test-Time Compute multipliziert also die Cache-Kosten mit. Dass DeepSeek die Reasoning-Stärke bei V4.1-Flash stufenlos einstellbar macht, ist auch eine Preissteuerung: Wer die Stufe halbiert, halbiert grob die Anzahl der Cache-Lesevorgänge pro Antwort [1].
| Verfahren | Prinzip | Belegter Effekt | Quelle |
|---|---|---|---|
| MQA / GQA | Abfrageköpfe teilen sich Schlüssel- und Wertvektoren | Qualität nahe Vollattention bei Geschwindigkeit nahe MQA; Uptraining mit 5 % des Trainingsaufwands | [4] |
| MLA (DeepSeek-V2) | Schlüssel und Werte als latenter Vektor komprimiert | KV-Cache -93,3 %, Durchsatz x5,76 gegenüber DeepSeek 67B; 6-Bit-Cache im Einsatz | [3] |
| SWA + Rolling Buffer (Mistral 7B) | Fenster von 4096 Token, Puffer fester Größe | 8-fache Cache-Einsparung bei 32k Token, 2-fache Geschwindigkeit bei 16k | [5] |
| PagedAttention (vLLM) | Blockweise Speicherverwaltung nach Betriebssystem-Vorbild | 20,4 bis 38,2 % Nutzungsgrad in Altsystemen; nahezu null Verschnitt, 2- bis 4-facher Durchsatz | [6] |
| CSA2 + FP4 + CED (DeepSeek V4.1-Flash) | Geteilte und wiederverwendete Indizes, 4-Bit-Cache, Encoder-Decoder-Aufbau | 890 Byte globaler Cache pro Token, etwa 1/4 von V4-Flash | [1] |
| Zustandsmodelle (Mamba) | Kontext in Zustand fester Größe, kein Cache | 5-facher Durchsatz, lineare Skalierung bis 1 Mio. Sequenzlänge | [7] |
Einordnung und Grenzen
Die Richtung der Entwicklung ist eindeutig: Der Cache pro Token fällt über Architektur-Generationen um Größenordnungen, und die Methoden kombinieren sich. Vorsicht ist bei drei Punkten geboten. Erstens stammen die spektakulärsten Zahlen (890 Byte, 1/437) von einer Herstellerkarte ohne unabhängige Replikation [1]. Zweitens sind Papierwerte systemabhängig: Die vLLM-Prozente beschreiben die 2023 untersuchten Systeme, die Mistral-Faktoren eine 7-Milliarden-Parameter-Konfiguration [5][6]. Drittens ist der Cache nur ein Kostenfaktor unter mehreren: Modellgewichte, Aktivierungsrechnung, Netzwerk und die Logik des Agenten obendrauf gehen in die gleiche Rechnung ein.
Und ein vierter Punkt gehört der Ehrlichkeit halber dazu: Kompression ist selten völlig verlustfrei. Ob Sparse Attention, Fenster oder 4-Bit-Cache in jeder Anwendung die gleiche Trefferquote liefern wie die unkomprimierte Variante, entscheidet erst die eigene Messung an der eigenen Aufgabe. Die Hersteller-Benchmarks der Karten sind Selbstauskünfte; unsere Benchmark-Portraits ordnen die wichtigsten Verfahren ein.
Trotzdem bleibt die Kernbotschaft robust, weil sie von mehreren unabhängigen Arbeiten gestützt wird: Wer lange Kontexte wirtschaftlich betreiben will, muss den KV-Cache als erste Größe im Blick haben, und die Werkzeuge dafür (teilen, komprimieren, fenstern, verwalten, ersetzen) sind keine Laborspielerei mehr, sondern in Produktionsmodellen angekommen.
Methode
Grundlage sind die Modellkarten von DeepSeek-V4.1-Flash und DeepSeek-V4-Pro sowie fünf Originalpapiere (DeepSeek-V2/MLA, GQA, Mistral 7B, vLLM/PagedAttention, Mamba), alle am 21. Oktober 2026 abgerufen. Eigene Rechnungen: (1) V1-Cache = 890 Byte x 437 = 388.930 Byte; (2) V4-Flash-Cache = 890 Byte x 4 = 3.560 Byte; (3) Cache pro Konversation = Bytes pro Token x 1.000.000, also 388,93 GB / 3,56 GB / 0,89 GB; (4) Konversationen pro GPU = 80 GB / Cache pro Konversation, also rund 0,2 / 22 / 90. Die Faktoren 4 und 437 sind in der Karte mit etwa angegeben; die Rückrechnungen sind deshalb Größenordnungen. Hero-Grafik und Diagramme wurden redaktionell aus diesen Zahlen erzeugt.
Grenzen
Alle Effizienzangaben sind Hersteller- oder Paperwerte ohne unabhängige Replikation durch uns. Die vLLM-Prozente beziehen sich auf 2023 untersuchte Systeme, die Mistral-Faktoren auf ein 7B-Modell; beides ist nicht ohne Weiteres auf aktuelle Modelle übertragbar. Der KV-Cache ist nur ein Teil der Inferenzkosten; Modellgewichte, Aktivierungen, Netzwerk und Agenten-Logik sind nicht Gegenstand dieser Analyse. Wir haben keine eigenen Messungen an den Modellen vorgenommen.
Quellen
- DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression (Modellkarte), DeepSeek / Hugging Face (abgerufen 2026-10-21) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- DeepSeek-V4-Pro (Modellkarte der V4-Serie), DeepSeek / Hugging Face (abgerufen 2026-10-21) ↩1 ↩2 ↩3
- DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model, arXiv:2405.04434 (abgerufen 2026-10-21) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints (Ainslie et al.), arXiv:2305.13245 (abgerufen 2026-10-21) ↩1 ↩2 ↩3 ↩4 ↩5
- Mistral 7B (Jiang et al.), arXiv:2310.06825 (abgerufen 2026-10-21) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- Efficient Memory Management for Large Language Model Serving with PagedAttention (Kwon et al.), arXiv:2309.06180 (abgerufen 2026-10-21) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- Mamba: Linear-Time Sequence Modeling with Selective State Spaces (Gu & Dao), arXiv:2312.00752 (abgerufen 2026-10-21) ↩1 ↩2 ↩3 ↩4 ↩5