 KI
DeepSeek hat mit DeepInfer das Inferenz-Framework veröffentlicht, das hinter dem Produktivbetrieb von DeepSeek-V4.1-Flash steht: Das Repository ist seit dem 16. Oktober 2026 öffentlich, steht unter der Apache-2.0-Lizenz und hat zuletzt rund 21.000 Sterne gesammelt [1]. Das Bemerkenswerte ist nicht nur der Code, sondern die Dokumentation: In einem ausführlichen Deployment-Q&A beschreibt DeepSeek, wie der eigene Großbetrieb organisiert ist - ein Cluster soll derzeit 155 Billionen Token pro Tag ausliefern, bei einem Gesamtumsatz von 38 US-Dollar pro GPU-Stunde zum Talstrompreis (Herstellerangabe) [2]. Dieser Artikel sortiert, was im Release steckt, was bewusst fehlt und was die veröffentlichten Betriebsdetails wert sind.
Was im Release steckt
DeepInfer liefert Offline-Inferenz für genau ein Modell: DeepSeek-V4.1-Flash (Standard-Checkpoint V4.1-Flash-1017) [1]. Enthalten sind optimierte Kernel - darunter FlashMLA, DeepGEMM, DeepEP, TileKernels, DeepSelect und eigene TileLang-Kernel -, Parallelisierung über Attention-Datenparallelismus mit balanciertem Kontext-Parallelismus sowie MoE-Expertenparallelismus mit Lastausgleich (EP + EPLB), dazu ein Modell- und Sampler-Laufzeitsystem [1]. Unterstützte Hardware: NVIDIA-GPUs der Generation SM100 (Blackwell) und Huaweis Ascend 950 [1].
- DSpark mit vertrauensgesteuerter Verifikation: Spekulative Decodierung mit variabler Länge - ein Confidence-Kopf schätzt die Akzeptanzrate jedes Entwurfs-Tokens, verifiziert wird nur die Teilmenge mit dem höchsten Grenznutzen [1][2].
- SWA Bounded Replay: Beim erneuten Einlesen wird nur ein begrenztes Endstück des Kontexts neu gerechnet; für die V4.1-Standardeinstellungen sind 140 Tokens vorgesehen [1].
- Asynchrones Scheduling: Die CPU-Batchplanung läuft überlappt zur GPU-Ausführung, standardmäßig aktiviert [1].
- Batch-invariante Inferenz und deterministisches Sampling: identische Ergebnisse unabhängig von der Batch-Zusammensetzung beziehungsweise identische Ausgaben bei identischen Eingaben - beides derzeit nur auf NVIDIA [1].
- Strukturierte Ausgaben: Generierung entlang regulärer Ausdrücke, JSON-Schema oder EBNF-Grammatik [1].
Dazu gehört das parallel veröffentlichte Paket deepseek-recipe (MIT-Lizenz): eine Komponente zur Token-Kodierung und -Dekodierung, die API-Protokolle und Modell-Tokenfolgen so übersetzt, dass Dritt-Deployments dasselbe API-Verhalten wie die offizielle DeepSeek-API zeigen [2][4]. DeepSeek kündigt an, den Inferenzcode künftiger Modelle und weitere Leistungsarbeit ebenfalls in DeepInfer zu öffnen [2].
Was bewusst fehlt
Das Release ist die Engine, nicht das Produktionssystem. Nicht enthalten sind das KV-Cache-System, die Disaggregation von Vision-Encoder, Prefill und Decode (VE/P/D) sowie der Lastausgleich über Datenreplikate hinweg - laut DeepSeek, weil diese Komponenten zu eng mit der internen Infrastruktur verzahnt sind [1][2]. Statt des Codes veröffentlicht das Unternehmen die Architektur: Das Q&A-Dokument beschreibt Designziele, Parallelisierung, Speicherlayout und Lastausgleich im Detail, verweist für die beiden fehlenden Komponenten auf einen ausführlichen Blogbeitrag und soll laufend fortgeschrieben werden [2].
| Komponente | Im Release? | Quelle |
|---|---|---|
| Kernel, Modell- und Sampler-Laufzeit | Ja | [1] |
| Parallelisierung (Attention DP/CP, MoE EP + EPLB) | Ja | [1] |
| DSpark, SWA Replay, asynchrones Scheduling | Ja | [1] |
| Batch-invariante Inferenz, deterministisches Sampling | Ja (nur NVIDIA) | [1] |
| Strukturierte Ausgaben | Ja | [1] |
| KV-Cache-System | Nein (Architektur beschrieben) | [1][2] |
| VE/Prefill/Decode-Disaggregation | Nein (Architektur beschrieben) | [1][2] |
| Lastausgleich über Datenreplikate | Nein | [1] |
Die Skala des Originalbetriebs
Die Angaben zum Eigenbetrieb sind Herstellerangaben ohne unabhängige Prüfung, aber sie sind ungewöhnlich konkret: Ein einzelnes Cluster soll derzeit 155 Billionen Token pro Tag bedienen, der Gesamtumsatz werde mit 38 US-Dollar pro GPU-Stunde zum Talstrompreis beziffert [2]. Die Anlage sei um drei Ziele herum gebaut: Beschleuniger mehrerer Hersteller nutzen, Prefill und Decode auf Standardhardware organisieren (gewöhnliche 8-GPU-Maschinen für Prefill, 64- bis 128-GPU-Supernodes für Decode) und den KV-Cache länger als 72 Stunden vorhalten, um wiederholtes Prefill zu vermeiden [2].
Für Prefill reichen laut Q&A kleine Konfigurationen (EP2-8/DP2-8, „so klein wie der HBM-Speicher erlaubt“), für Decode empfiehlt DeepSeek Wide-EP mit 64 bis 128 Expertenparallel-Rängen; die kleinste effiziente Einheit liegt damit bei 64 Prefill- plus 64 Decode-GPUs, ein 1P+1D-Aufbau sei aber prinzipiell lauffähig [2]. Tensor- und Kontext-Parallelismus werden derzeit nicht genutzt [2].
Der KV-Cache als separates Speichercluster
Der blockweise KV-Cache liegt nicht im Maschinenspeicher, sondern in einem dedizierten 3FS-Speichercluster mit rund 100 PiB SSD-Kapazität; die Aufbewahrungszeit beträgt drei Tage für Agenten-Verkehr und sieben Tage für Chatbot-Verkehr, weil dort eine kleine Menge Cache sehr oft getroffen werde - eine Verkürzung auf drei Tage koste dem Chatbot-Verkehr erfahrungsgemäß 0,5 bis 1 Prozentpunkt Trefferrate [2]. Empfohlene Speicherserver: 20 SSDs à 30,73 TB mit mindestens 40 GB/s Lese- und 5 GB/s Schreibdurchsatz; logisch fallen etwa 14,4 TB pro GPU an [2]. Die Auslagerung entkoppelt laut DeepSeek zwei Dinge: Jede Prefill-Maschine kann jedes Präfix treffen, ohne dass Präfix-Affinität mit dem Lastausgleich kollidiert, und Speicher- und Rechenknoten skalieren unabhängig - Rechenknoten fielen mehr als zehnmal häufiger aus als Speicherknoten [2]. Der Sliding-Window-Anteil des Cache bleibt dagegen lokal: 20 Schichten à 134 Token à 528 Byte, also 1.415.040 Byte pro Sequenz im MXFP8-Format [2].
DSpark: spekulative Decodierung mit Kostenbewusstsein
Bei klassischer spekulativer Decodierung verifiziert das Hauptmodell pro Schritt eine feste Zahl von Entwurfs-Tokens. DeepSeek argumentiert: Die Akzeptanzwahrscheinlichkeit variiert je Anfrage und Position, also verpufft bei fester Länge Rechenarbeit an unwahrscheinlichen Tokens [2]. DSpark lässt einen Confidence-Kopf die Akzeptanzrate jedes Entwurfs schätzen und verifiziert nur die Präfix-Teilmenge mit dem höchsten erwarteten Durchsatz-Beitrag [2]. Im Produktivbetrieb erzeugt das Entwurfsmodell fünf Tokens pro Runde [2].
Daten als Tabelle
| Durchsatzgewinn in Prozent | |
|---|---|
| 16 | -1,5 |
| 32 | 1,6 |
| 48 | 3,6 |
| 60 | 5,4 |
| 72 | 6,7 |
| 96 | 11 |
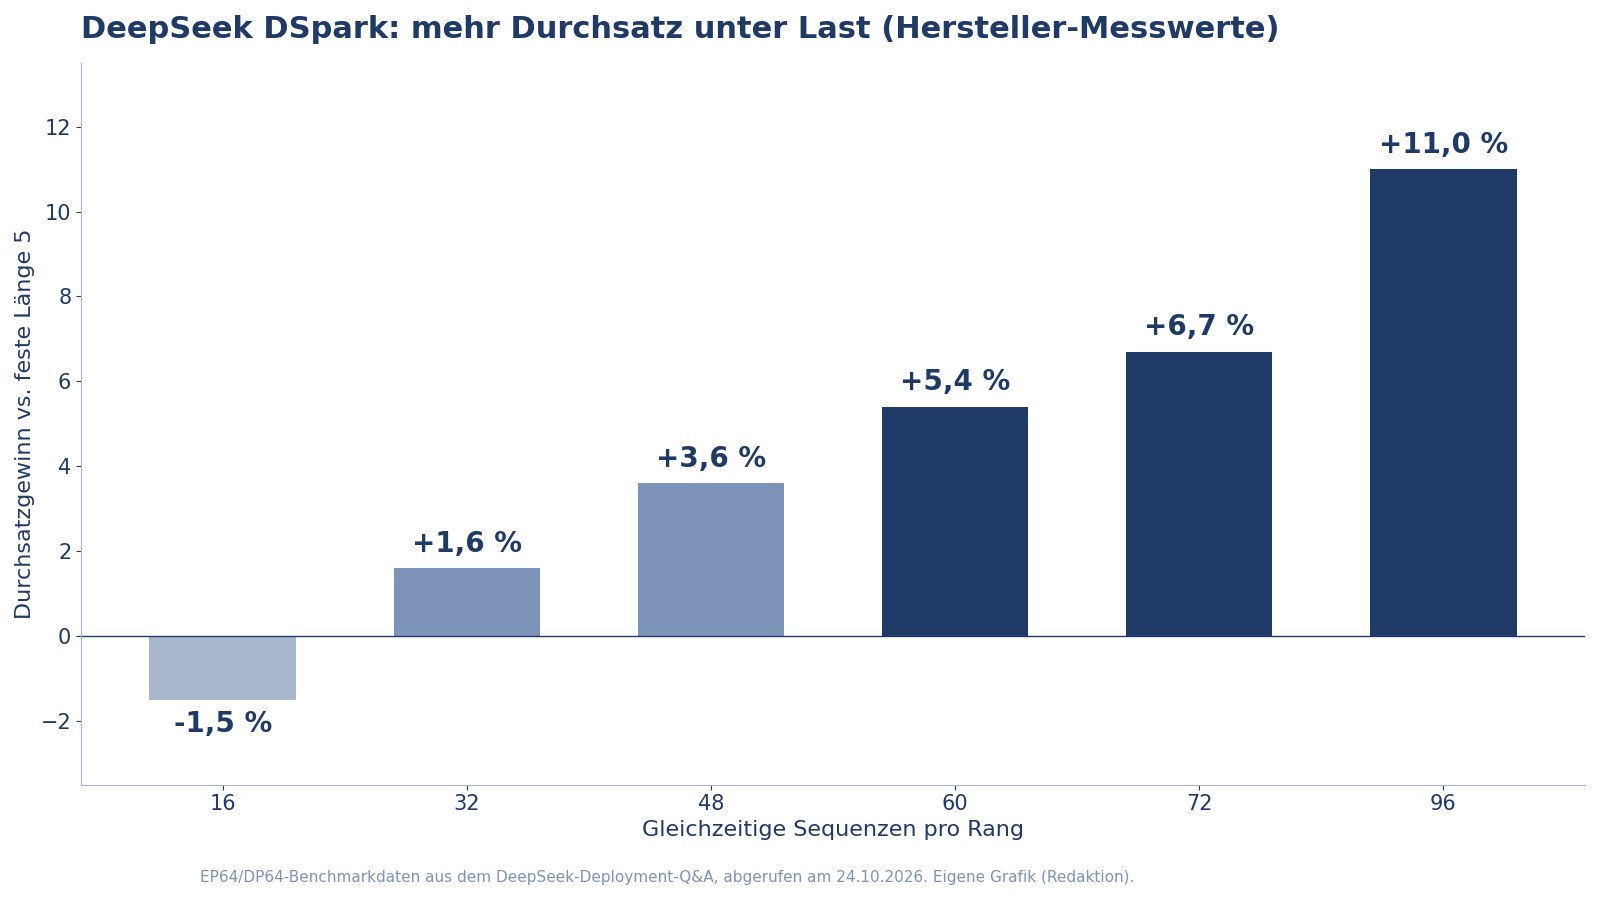
Hersteller-Messwerte aus EP64/DP64-Benchmarkdaten, geschätzter Durchsatz in Token/s/Rang. Unter Last steigt der Gewinn: Bei wenig Parallelität (16 Sequenzen) ist die feste Länge minimal schneller. Quelle [2].
Die Zahlen dahinter: Die dynamische Länge senkt die verifizierten Entwurfs-Tokens pro Schritt um rund 30 Prozent (von 5,00 auf 3,2 bis 4,4), während die akzeptierte Länge nahezu gleich bleibt (3,29 gegenüber 3,20 im Mittel). Am Produktions-Arbeitspunkt von etwa 60 gleichzeitigen Sequenzen pro Rang ergibt das laut DeepSeek 4 bis 7 Prozent mehr Durchsatz [2]. Der Mechanismus ist auch ein Beispiel für das Zusammenspiel mit dem asynchronen Scheduler: Weil die Confidence-Werte des Schritts N beim Planen von N+1 noch nicht vorliegen, legt die CPU nur das Gesamtbudget fest; die Verteilung auf einzelne Anfragen berechnet ein TileLang-Kernel direkt auf der GPU [2].
Reproduzierbarkeit als eigenes Thema
Zwei Funktionen zielen auf ein praktisches Ärgernis: Batch-invariante Inferenz hält Modellergebnisse unabhängig davon stabil, welche anderen Anfragen gerade im selben Batch laufen; deterministisches Sampling liefert bei identischen Eingabetokens und Parametern identische Ausgaben (beide derzeit nur auf NVIDIA, über Umgebungsvariablen aktivierbar) [1]. Für Evaluierungen und Fehlersuche ist das erheblich: Ergebnisse werden wiederholbar. Passend dazu liegt ein Evaluierungsrahmen bei, der Generierung und Bewertung strikt trennt - die Rohausgaben landen auf Platte, die Bewertung (etwa mit einem anderen Jurymodell) kann ohne erneute Generierung wiederholt werden [3]. Vorgesehen sind AIME 2026 (30 Aufgaben, 32 Samples je Aufgabe), Humanity's Last Exam (2.500 Aufgaben, davon 342 mit Bild) und GPQA Diamond (198 Aufgaben, 8 Samples), jeweils als Pass@1 [3].
Einordnung: Was heißt das für den Selbstbetrieb?
DeepInfer ist bemerkenswert offen und zugleich ehrlich unvollständig. Wer V4.1-Flash selbst betreiben will, bekommt die Engine mit den produktionserprobten Kerneln und exakt dokumentierten Konfigurationen - aber kein fertiges Großsystem: KV-Cache-Speicher, Disaggregation und Lastausgleich muss ein Betreiber selbst ergänzen, angeleitet durch die Architekturbeschreibung [1][2]. Die kleinste effiziente Einheit von 128 GPUs zeigt zudem, dass sich das Design an Anbieter mit echtem Skalenbedarf richtet; für kleinere Deployments bleibt die Engine nutzbar, verliert aber Teile ihres Vorteils [2]. Bemerkenswert ist die Transparenz selbst: Zahlen zu Verifikationslängen, Speicherbelegung und Lastausgleich (der Lastausgleich erreiche rund 80 Prozent eines perfekt balancierten Offline-Benchmarks [2]) liest man sonst kaum von einem Frontier-Anbieter. Die Anerkennung der Herkunft gehört zum Bild: DeepInfer basiere ursprünglich weitgehend auf vLLM, mit Anleihen bei SGLang und TensorRT-LLM [1].
Methode
Grundlage sind das DeepInfer-Repository mit README, das Deployment-Q&A-Dokument, das Evaluierungs-README und das Repository deepseek-recipe, alle am 24. Oktober 2026 abgerufen beziehungsweise gegen den Vortag unverändert re-verifiziert. Die DSpark-Werte stammen aus der Hersteller-Tabelle mit EP64/DP64-Benchmarkdaten; die Darstellung als Diagramm übernimmt die Werte unverändert. Keine eigenen Messungen.
Grenzen
Alle Skalen- und Leistungsangaben (155 Billionen Token/Tag, 38 US-Dollar/GPU-Stunde, Durchsatzgewinne, Trefferraten) sind Herstellerangaben ohne unabhängige Replikation. Das Release deckt nur Offline-Inferenz ab; die fehlenden Komponenten sind beschrieben, aber nicht als Code verfügbar, ein Vergleich mit anderen Stacks wurde vom Hersteller nicht veröffentlicht.
Quellen
- deepseek-ai/DeepInfer (Repository und README), GitHub / DeepSeek-AI (abgerufen 2026-10-24) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- DeepSeek V4.1 Flash Inference Deployment Q&A, GitHub / DeepSeek-AI (abgerufen 2026-10-24) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- DeepInfer eval/README (Benchmark-Methodik), GitHub / DeepSeek-AI (abgerufen 2026-10-24) ↩1 ↩2
- deepseek-ai/deepseek-recipe (Repository), GitHub / DeepSeek-AI (abgerufen 2026-10-24) ↩