 KI
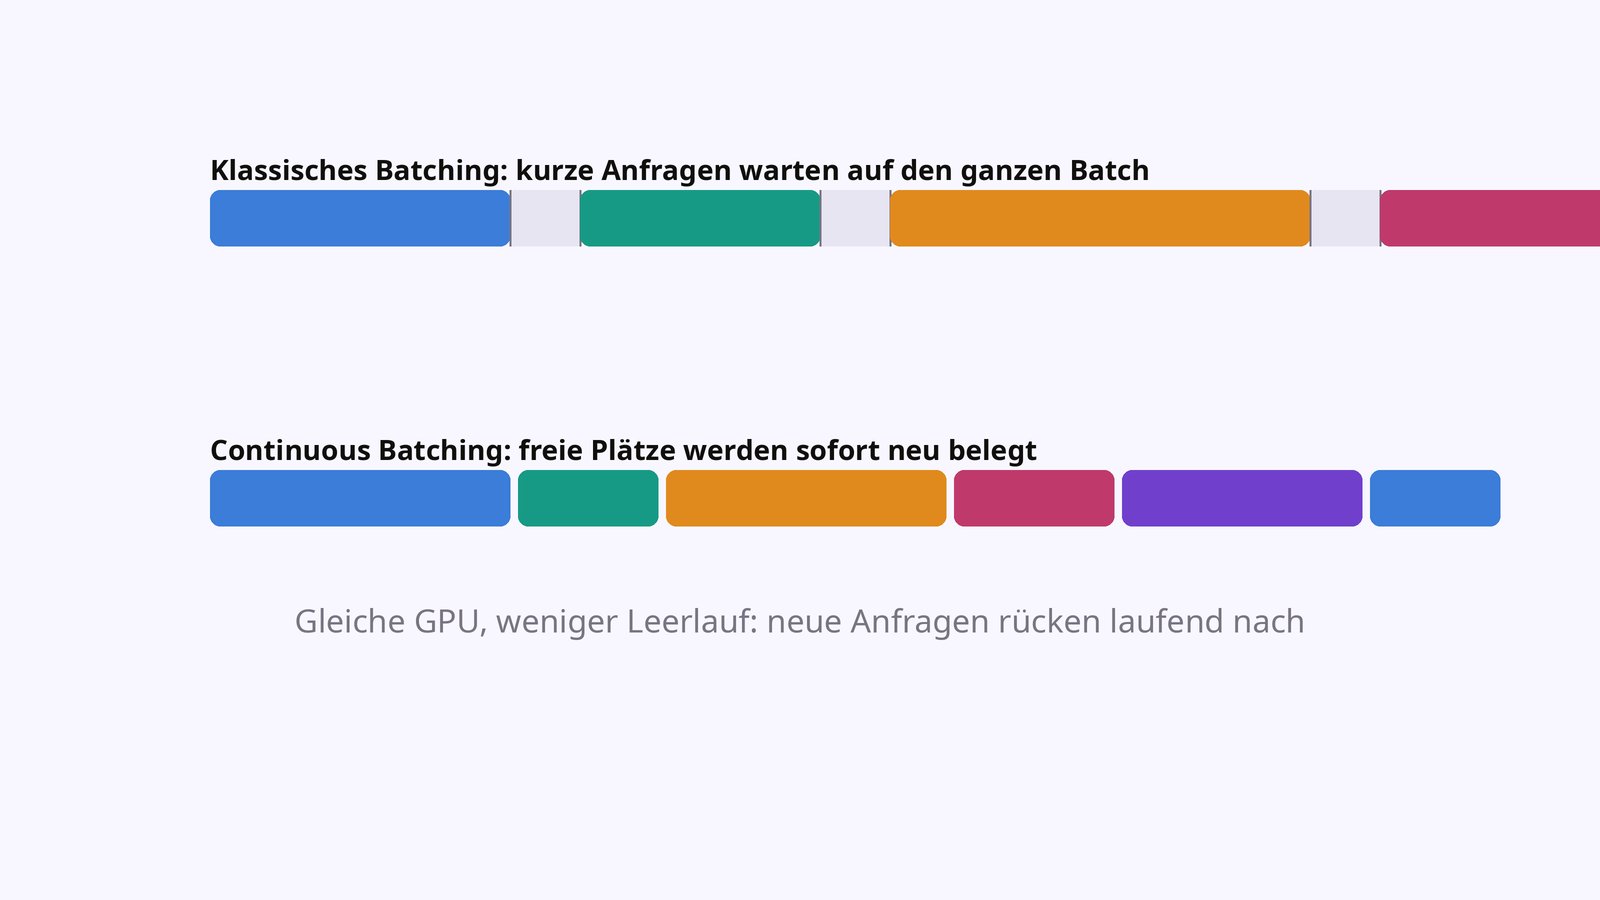
Ein Modell herunterladen und lokal aufrufen ist das eine; es als Dienst für Dutzende gleichzeitige Nutzer betreiben das andere. Dieser Text erklärt, was ein Inferenz-Server leistet, welche zwei Ideen (Continuous Batching und PagedAttention) den Betrieb ökonomisch gemacht haben und wie man die Kennzahlen TTFT und TPOT liest. Er baut auf Inferenz und Kosten verstehen auf.
Warum Serving eine eigene Disziplin ist
Beim Training zählt der Gesamtdurchsatz über Stunden. Beim Servieren zählen zwei Dinge zugleich: wie schnell die einzelne Antwort erscheint und wie viele Antworten das System pro Sekunde insgesamt liefert. Das Nadelöhr ist in beiden Fällen der GPU-Speicher, genauer die Speicherbandbreite: Beim Generieren muss für jedes neue Token das gesamte Modell einmal aus dem Speicher gelesen werden. Die Gewichte einmal zu laden und möglichst viele Anfragen daran teilhaben zu lassen, ist deshalb die Grundidee des Batching.
Continuous Batching: der Batch, der nie wartet
Klassisches Batching sammelt Anfragen zu einem Batch und rechnet ihn zu Ende: Eine kurze Anfrage wartet auf die längste im Batch, und Neueingänge warten auf den kompletten Durchlauf. Das Orca-System (OSDI 2022) brach dieses Muster mit Scheduling auf Iterationsebene: Nach jedem einzelnen Token-Schritt darf der Scheduler die Zusammensetzung ändern; fertige Anfragen verlassen den Batch sofort, neue rücken nach. Ergänzend führte Orca das selektive Batching ein, das die Mischung nur auf die Operationen anwendet, die davon profitieren [2]. Diese zweite Idee ist heute unter dem Namen Continuous Batching Standard in allen ernsthaften Servern.
PagedAttention: der KV-Cache wird Speicherverwaltung
Der zweite Engpass ist der KV-Cache: Für jedes bereits gesehene Token hält das Modell Zwischenergebnisse im Speicher, pro Anfrage und wachsend mit jeder Antwort. Reserviert man pro Anfrage einen großen zusammenhängenden Block, entsteht Verschnitt. PagedAttention überträgt die Idee des virtuellen Speichers aus Betriebssystemen auf diesen Cache: kleine Seiten statt großer Blöcke, geteilte Seiten bei gemeinsamen Präfixen. Das vLLM-System darum herum erreichte im Paper das Zwei- bis Vierfache des Durchsatzes der damaligen Systeme FasterTransformer und Orca bei vergleichbarer Verzögerung, mit nahezu null Verschnitt im KV-Cache [1]. Die Dokumentation von vLLM beschreibt den aktuellen Stand des Open-Source-Servers, der daraus hervorging [3].
Die Kennzahlen: TTFT, TPOT, Durchsatz
Zwei Zeiten beschreiben das Nutzererlebnis. Die Time to First Token ist die Wartezeit bis zum ersten Zeichen der Antwort; sie hängt vor allem an der Prompt-Phase, in der die Eingabe parallel verarbeitet wird. Die Time per Output Token ist das Tempo danach; sie hängt an der sequentiellen Generierungsphase und damit an der Speicherbandbreite. Für den Betreiber kommt der Durchsatz in Token pro Sekunde über alle Anfragen hinzu. vLLM exportiert diese Größen als Prometheus-Metriken, etwa Histogramme für TTFT und die Zeit zwischen Token sowie die Auslastung des KV-Cache in Prozent [3][6]. Der Grundkonflikt: Mehr gleichzeitige Anfragen (größerer Batch) steigern den Durchsatz, aber ab einem Punkt verschlechtern sie TTFT und TPOT für alle.
Prefix-Caching: gemeinsame Anfänge nicht doppelt rechnen
Viele Anfragen teilen lange identische Anfänge: denselben System-Prompt, dieselben Beispieldokumente. SGLang führte mit RadixAttention eine baumbasierte Wiederverwendung solcher Präfixe ein und berichtete auf den untersuchten Arbeitslasten, darunter mehrstufige Agentenläufe und JSON-Ausgaben, bis zu 6,4-mal höheren Durchsatz als damalige Systeme [4]. In der Praxis heißt das: Wer seine Prompts so ordnet, dass der stabile Teil vorne steht, spart Rechenzeit; Details dazu im Glossar unter Prompt-Caching.
Werkzeuglandschaft und Kapazitätsplanung
| Server | Kernidee | Typische Stärke |
|---|---|---|
| vLLM | PagedAttention, Continuous Batching | breite Hardware- und Modellunterstützung, Prometheus-Metriken |
| SGLang | RadixAttention, strukturierte Ausgaben | komplexe Programme, Agenten, JSON-Zwang |
| HF TGI | Text Generation Inference | Hugging-Face-Integration, Streaming |
Für die Kapazität zählt eine einfache Rechnung. Eigene Rechnung: Llama 3 70B in FP16 braucht 140 GB für die Gewichte; auf vier 80-GB-GPUs bleiben nach Gewichten und Laufzeitreserve grob 150 GB für KV-Cache. Der Cache liegt bei 320 KiB pro Token und Anfrage (Herleitung in Inferenz und Kosten verstehen aus den Architekturangaben [6]). 150 GB geteilt durch 320 KiB ergeben rund 470.000 Token Spielraum: etwa 58 gleichzeitige Unterhaltungen mit je 8.000 Token Kontext. Sollen es mehr werden, helfen kleinere Kontexte, Quantisierung oder mehr GPUs. Die Rechnung zeigt zugleich, warum der KV-Cache und nicht die Rechenleistung die Kapazität bestimmt.
Methode
Gelesen wurden am 20. Oktober 2026 die Abstracts und Systembeschreibungen der Papers zu vLLM, Orca und SGLang, die Dokumentationen von vLLM (einschließlich der Metrik-Referenz) und von Hugging Face TGI sowie die Architektur-Tabelle des Llama-3-Berichts. Die Kapazitätsrechnung wurde mit den dortigen Angaben selbst nachgerechnet und ist als eigene Rechnung gekennzeichnet; der KV-Cache-Wert von 320 KiB pro Token ist mit der bestehenden Seite Inferenz und Kosten verstehen abgeglichen.
Grenzen
Durchsatz-Faktoren (2 bis 4 mal für vLLM, bis 6,4 mal für SGLang) stammen aus den Papers und deren Hardware und Arbeitslasten; sie übertragen sich nicht eins zu eins auf eigene Fälle. Die Kapazitätsrechnung ist eine Überschlagsrechnung ohne Aktivierungen, Fragmentierung und Laufzeitreserve im Detail. Die Werkzeugtabelle erhebt keinen Anspruch auf Vollständigkeit und bewertet keine kommerziellen Angebote.
Quellen
- Kwon u. a.: Efficient Memory Management for Large Language Model Serving with PagedAttention, arXiv:2309.06180 (SOSP 2023) (abgerufen 2026-10-20) ↩1 ↩2
- Yu u. a.: Orca: A Distributed Serving System for Transformer-Based Generative Models, USENIX OSDI 2022 (abgerufen 2026-10-20) ↩1 ↩2
- vLLM-Dokumentation, docs.vllm.ai (abgerufen 2026-10-20) ↩1 ↩2 ↩3
- Zheng u. a.: SGLang: Efficient Execution of Structured Language Model Programs, arXiv:2312.07104 (NeurIPS 2024) (abgerufen 2026-10-20) ↩1 ↩2
- Text Generation Inference (TGI), Hugging Face Dokumentation (abgerufen 2026-10-20) ↩
- The Llama 3 Herd of Models (Architektur-Tabelle), arXiv:2407.21783 (Meta, 2024) (abgerufen 2026-10-20) ↩1 ↩2