 KI
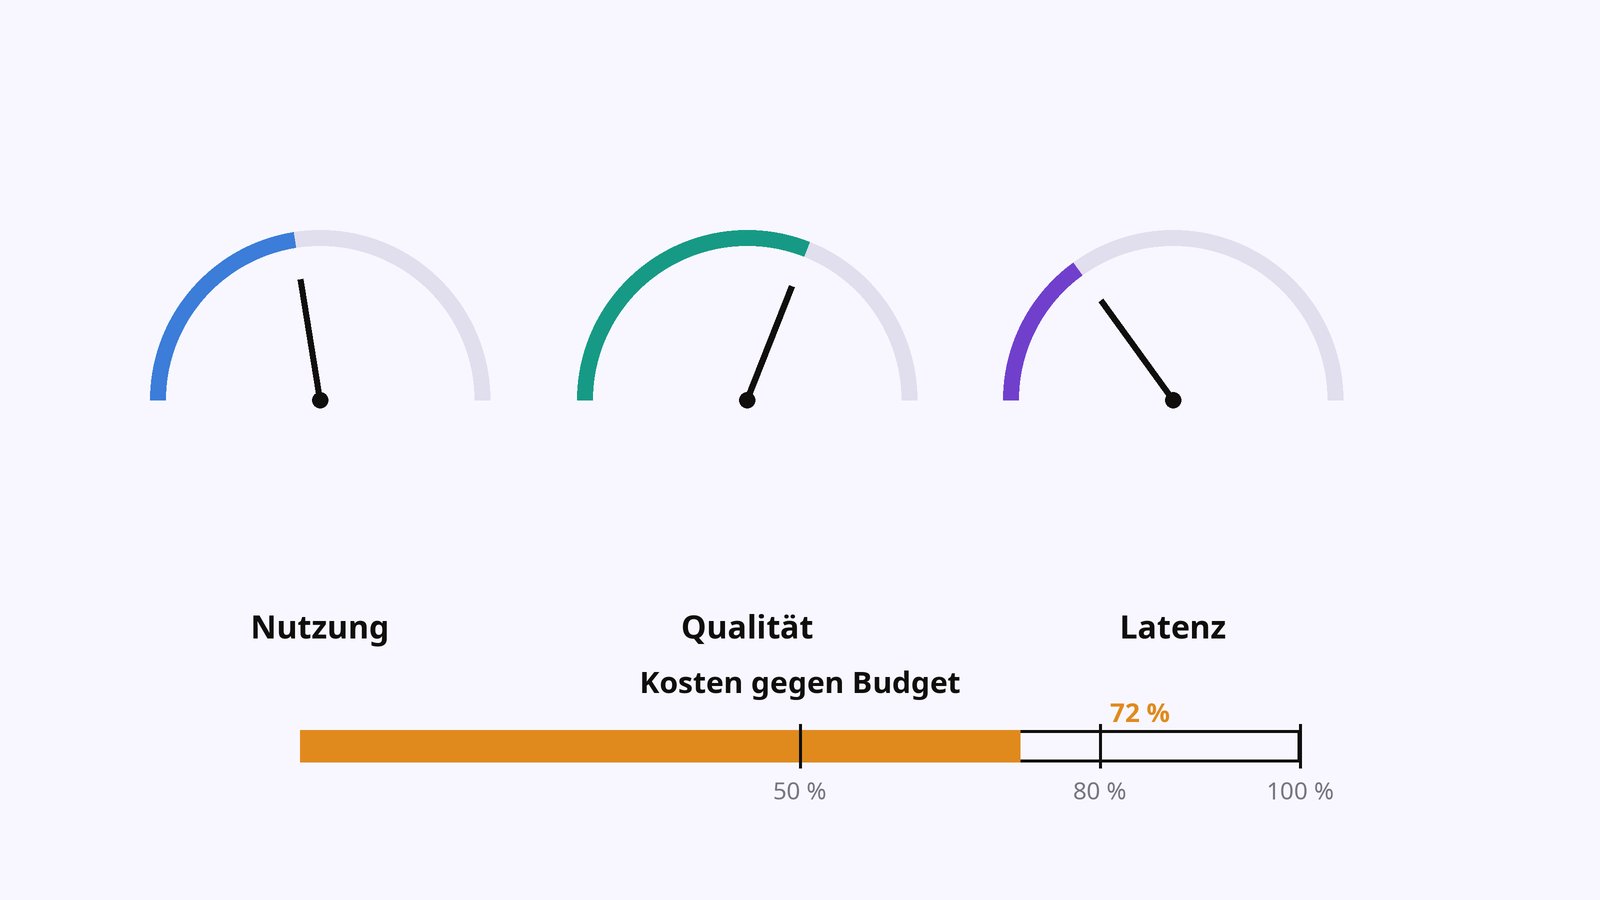
Ein LLM-Dienst, der nur dann auffällt, wenn sich Nutzer beschweren, ist schon zu spät dran. Dieser Text beschreibt das Überwachungsgerüst für den Betrieb: welche Metriken der Server selbst liefert, wie man Rate-Limits liest statt sie zu erleiden, wie Token-Buchhaltung die Kosten zähmbar macht und welche Alarme sich bewährt haben. Er ergänzt Inferenz-Server im Betrieb und wird im Lernpfad zu Kosten und ROI weiterverwendet.
Vier Ebenen: was überhaupt beobachtet werden muss
- Nutzung: Anfragen pro Minute, aktive Nutzer, Verteilung auf Funktionen. Ohne sie fehlt jede Grundlage für Kapazität und Abrechnung.
- Qualität: Antwortlängen, Fehlerquoten, Ergebnisse der eigenen Prüfmenge nach jedem Modellwechsel (siehe Evals).
- Latenz: Time to First Token und Time per Output Token als Verteilungen, nicht als Mittelwerte.
- Kosten: verbrauchte Token je Funktion, Team und Modell, erkannt anhand der Abrechnung des Anbieters oder der eigenen Zählung.
Metriken aus dem Server: der vLLM-Endpunkt
Selbst gehostete Server liefern ihre Messwerte fertig. vLLM stellt einen Prometheus-Endpunkt bereit; die Metrik-Referenz listet unter anderem das Histogramm der Zeit bis zum ersten Token, die Verteilung der Zeit zwischen Ausgabetoken, die Zahl laufender und wartender Anfragen sowie die Auslastung des KV-Cache in Prozent [1]. Prometheus ist das übliche Sammelsystem für solche Zeitreihen: Es ruft die Endpunkte in Intervallen ab und speichert die Werte [3]; Grafana stellt sie als Tafeln dar und verschickt Alarme [4]. Die zwei wichtigsten Frühindikatoren sind die Warteschlange (steigt sie, läuft der Dienst in einen Stau) und die KV-Cache-Auslastung (läuft sie gegen 100 Prozent, beginnt das System, Anfragen abzuweisen oder neu zu berechnen).
Rate-Limits lesen statt erleiden
Bei gehosteten APIs ersetzt das Rate-Limit den eigenen Speicher als Grenze. OpenAI misst Limits in Anfragen pro Minute und Tag (RPM, RPD), Token pro Minute und Tag (TPM, TPD) sowie für Bilder in Stück pro Minute; welche Stufe gilt, hängt vom Nutzungslevel der Organisation ab, das mit dem bisherigen Umsatz automatisch steigt [2]. Die Dokumentation nennt den wichtigsten Trick gleich mit: Wer an der Anfragen-Grenze klemmt, aber Token-Reserve hat, bündelt mehrere Aufgaben in eine Anfrage [2]. Im eigenen Code gehören drei Dinge: das Zurücknehmen des Tempos mit wachsenden Wartezeiten (Backoff), eine Warteschlange statt sofortiger Wiederholung und eine Alarmierung, wenn die Dauerlast dauerhaft nahe der Grenze liegt; denn dann ist es Zeit für die nächste Nutzungsstufe oder einen zweiten Anbieter.
Kostenkontrolle: Token-Buchhaltung
Die Abrechnung erfolgt über Token, das Blended-Price-Konzept der Seite gewichtet Ein- und Ausgabe unterschiedlich. Damit Kosten steuerbar werden, zählt man den Verbrauch je Funktion (welche Anwendung) und je Aufruftyp (teures Modell oder günstiges), und setzt Budgets mit Alarmstufen, etwa 50, 80 und 100 Prozent des Monatsrahmens. Für eigene Installationen gilt Entsprechendes in GPU-Stunden. Das ehrliche Zielmaß ist nicht der Preis pro Million Token, sondern die Kosten pro gelöster Aufgabe: Ein billiges Modell, das jede dritte Aufgabe falsch löst und wiederholt werden muss, ist am Ende teurer als ein teures mit einer richtigen Antwort.
Traces mit OpenTelemetry
Metriken sagen, dass etwas langsam ist; Traces sagen, wo. OpenTelemetry ist der herstelleroffene Standard für solche Spuren, und die GenAI-Arbeitsgruppe definiert seit 2025 eigene Konventionen dafür: Spans für Chat-Aufrufe, Embeddings und Werkzeugaufrufe, inklusive Attribute für Modellname und Tokenverbrauch [5]. Wer seine Anwendung danach instrumentiert, kann jede teure oder langsame Anfrage bis zum einzelnen Modellaufruf zurückverfolgen, unabhängig davon, welcher Beobachtungsdienst die Daten am Ende anzeigt.
Alarme, die nicht nerven
Gute Alarme feuern auf Zustände mit Handlungsbedarf, nicht auf jede Zacke. Bewährt haben sich vier: die Warteschlange wächst über einige Minuten (Kapazität voll), der Anteil fehlgeschlagener Anfragen überschreitet eine Schwelle (Anbieter- oder Konfigurationsproblem), das Budget-Tempo prognostiziert ein Überschreiten vor Monatsende (Kosten) und die Prüfmenge nach einem Modellwechsel fällt unter ihre Mindestquote (Qualität). Alles andere landet in Tafeln zur regelmäßigen Durchsicht, nicht im Pager.
Methode
Gelesen wurden am 20. Oktober 2026 die Metrik-Referenz von vLLM (Metriknamen und Typen dort nachgeschlagen), der Rate-Limit-Leitfaden von OpenAI (Limit-Arten und Nutzungsstufen), die Überblicksseiten von Prometheus und Grafana sowie das Repositorium der OpenTelemetry-GenAI-Konventionen. Hinweise auf eigene Rechnungen sind als solche markiert; konkrete Schwellenwerte für Alarme sind redaktionelle Erfahrungswerte, keine Norm.
Grenzen
Limit-Arten und Nutzungsstufen von OpenAI können sich ändern; vor dem Vertrauen auf konkrete Werte die jeweils aktuelle Dokumentation prüfen. Die GenAI-Konventionen von OpenTelemetry befinden sich in aktiver Weiterentwicklung; Attributnamen können sich zwischen Versionen ändern. Andere Anbieter und Server haben abweichende Metriknamen; die Konzepte übertragen sich, die Bezeichnungen nicht.
Quellen
- Production Metrics, vLLM-Dokumentation (abgerufen 2026-10-20) ↩1 ↩2
- Rate limits, OpenAI API-Dokumentation (abgerufen 2026-10-20) ↩1 ↩2 ↩3
- Overview, Prometheus-Dokumentation (abgerufen 2026-10-20) ↩
- Grafana-Dokumentation, Grafana Labs (abgerufen 2026-10-20) ↩
- OpenTelemetry GenAI Semantic Conventions, OpenTelemetry (GitHub) (abgerufen 2026-10-20) ↩