 KI
Wer mit KI arbeitet, trifft früher oder später auf Sätze wie „das Modell generalisiert gut“ oder „da haben wir overfittet“. Dieser Text erklärt die vier Grundbegriffe dahinter: Daten, Lernen, Overfitting und Generalisierung. Er ist die Basis für die weiteren Seiten über Embeddings und Fine-Tuning und hilft, Modellkarten und Benchmark-Zahlen richtig zu lesen.
Daten: der Rohstoff, über den alles entscheidet
Ein Lernverfahren bekommt Beispiele: Eingaben und meist auch die gewünschten Ausgaben. Aus diesen Beispielen stellt es die Parameter des Modells ein. Die Qualität der Daten begrenzt dabei alles Weitere; Pedro Domingos formuliert es in seinem vielzitierten Überblicksaufsatz so: Mehr Daten schlagen oft das cleverere Verfahren, und „Garbage in, Garbage out“ gilt seit jeher [3].
Damit man die Leistung ehrlich messen kann, teilt man die Daten üblicherweise in drei Teile. Auf den Trainingsdaten lernt das Modell. Mit den Validierungsdaten wählt man zwischen Varianten, etwa zwischen Lernraten oder Modellgrößen. Die Testdaten bleiben bis zum Schluss unangetastet und beantworten genau eine Frage: Wie gut ist das fertige Modell auf neuen Fällen? Wer die Testdaten zwischendurch zum Nachjustieren benutzt, macht sie faktisch zu Validierungsdaten und misst sich selbst schöner, als das Modell ist. Googles Machine Learning Crash Course und die scikit-learn-Dokumentation beschreiben diese Aufteilung als Standardvorgehen [2][4].
Was „Lernen“ technisch bedeutet
Ein Modell ist zunächst eine Rechenvorschrift mit Millionen oder Milliarden einstellbarer Zahlen, den Parametern. Lernen heißt: Für jedes Trainingsbeispiel berechnet das Verfahren, wie weit die Ausgabe vom Ziel entfernt ist (der Verlust), und verändert die Parameter ein kleines Stück in die Richtung, die den Verlust verkleinert. Diese Abstiegsrichtung liefert der Gradientenabstieg, die effiziente Berechnung der nötigen Ableitungen durch alle Schichten leistet Backpropagation [1]. Zwischenstände dieses Prozesses werden als Checkpoint gespeichert, etwa um später von dort weiterzutrainieren.
Wichtig ist die Perspektive: Der Fehler auf den Trainingsdaten ist nur das Mittel, nicht das Ziel. Domingos drückt es so aus: Das eigentliche Ziel ist die Generalisierung, also gute Leistung außerhalb der Beispiele, die das Modell gesehen hat [3]. Genau daran scheitern Modelle auf zwei entgegengesetzte Arten.
Overfitting und Underfitting: die zwei Grundkrankheiten
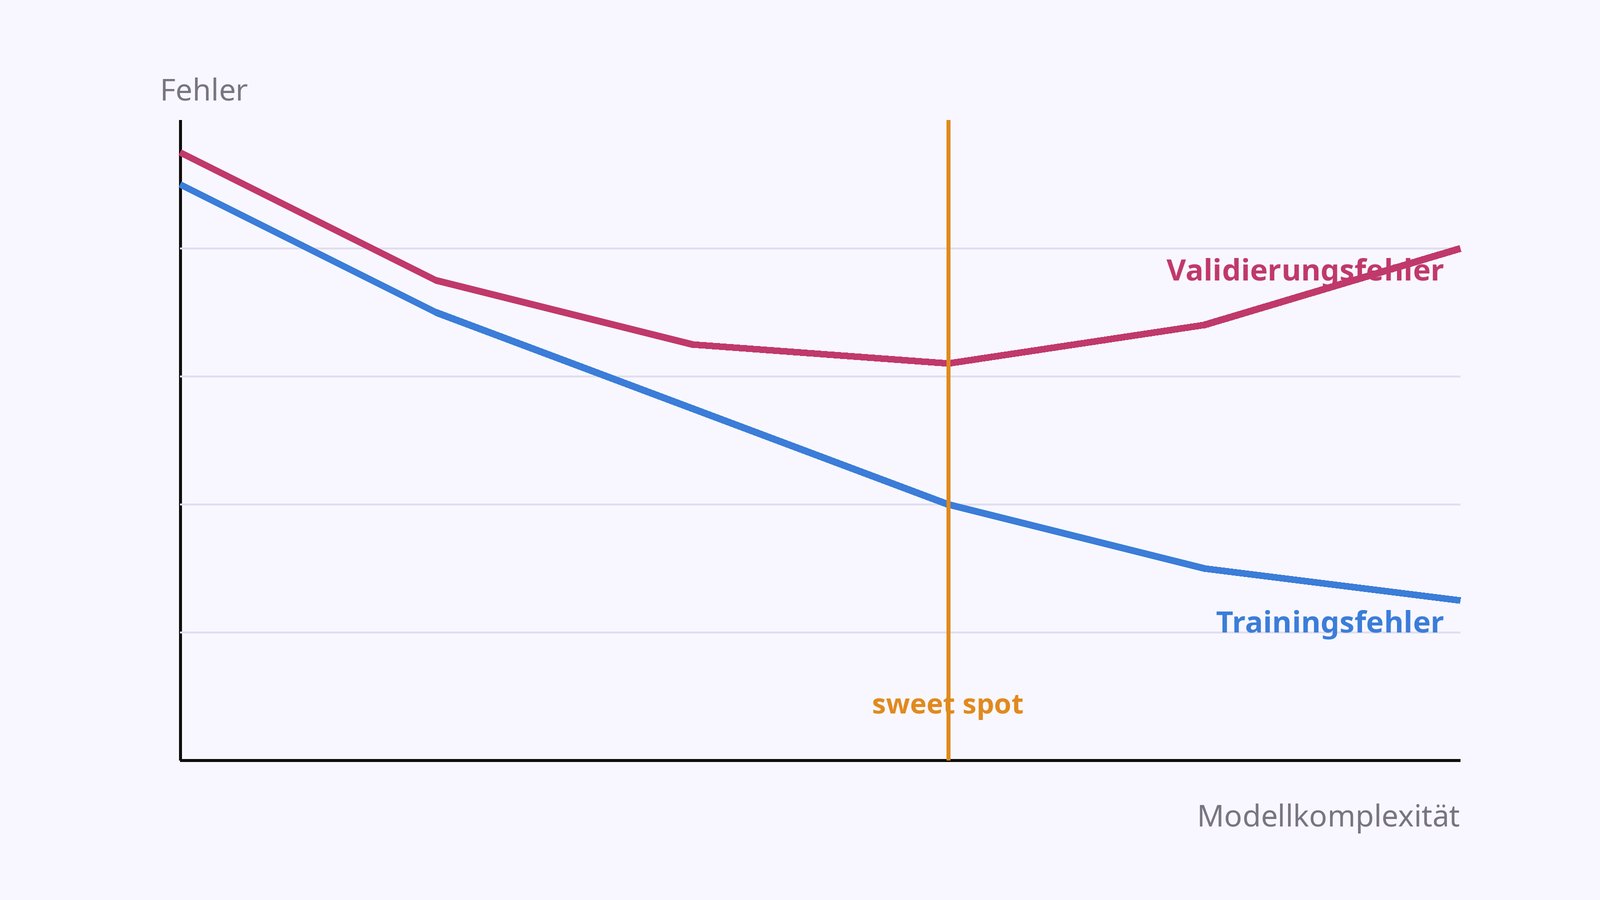
Underfitting liegt vor, wenn das Modell zu einfach für das Muster in den Daten ist. Eine Gerade kann eben keinen Bogen abbilden; der Fehler ist auf Trainings- wie auf neuen Daten hoch. Overfitting ist das Gegenteil: Das Modell hat so viel Kapazität, dass es die Trainingsbeispiele samt ihren zufälligen Besonderheiten auswendig lernt. Der Trainingsfehler fällt weiter, aber der Fehler auf neuen Daten steigt wieder. Die scikit-learn-Dokumentation zeigt den Effekt an einem durchgerechneten Beispiel: Ein Polynom mittleren Grades trifft die Datenstruktur, ein sehr hoher Grad zittert zwischen den Punkten hindurch [5].
- Trainingsfehler
- Validierungsfehler
Daten als Tabelle
| Modellkomplexität | Trainingsfehler | Validierungsfehler |
|---|---|---|
| 1 | 9 | 9,5 |
| 2 | 7 | 7,5 |
| 3 | 5,5 | 6,5 |
| 4 | 4 | 6,2 |
| 5 | 3 | 6,8 |
| 6 | 2,5 | 8 |
Quelle: Eigene Darstellung nach dem Muster des scikit-learn-Beispiels [5]
Schematische Darstellung des klassischen Verlaufs (keine Messwerte): Das Minimum des Validierungsfehlers markiert die passende Komplexität; rechts davon beginnt Overfitting. Darstellung im Stil von [5].
In der Praxis erkennt man Overfitting an der Schere zwischen den beiden Kurven: Sinkt der Trainingsfehler weiter, während der Validierungsfehler stagniert oder steigt, lernt das Modell gerade auswendig. Gegenmittel sind mehr oder vielfältigere Daten, ein einfacheres Modell, Regularisierung, frühes Stoppen des Trainings oder, bei Bildern und Text, künstlich vervielfältigte Beispiele [1][2].
Generalisierung messen: Holdout und Kreuzvalidierung
Die einfachste Messung ist der Holdout: Ein fester Teil der Daten, oft 20 Prozent, wird als Testmenge zurückgelegt. Reichen die Daten dafür kaum, hilft die k-fache Kreuzvalidierung: Die Daten werden in k gleich große Teile zerlegt, das Modell wird k-mal trainiert, jedes Mal mit einem anderen Teil als Prüfmenge, und die k Ergebnisse werden gemittelt. scikit-learn dokumentiert das Verfahren und warnt vor seiner häufigsten Falle: Alle vorbereitenden Schritte, etwa eine Auswahl von Merkmalen, dürfen nur auf den Lerndaten jedes Durchlaufs geschehen, sonst fließt Prüfwissen ins Training ein [4].
Solches Data Leakage ist der heimtückischste Fehler der gesamten Datenarbeit: Information aus der Prüfmenge gelangt in den Lernprozess, und die gemessene Leistung sagt nichts mehr über neue Fälle aus. Typische Auslöser [2][4]:
- Duplikate oder nahe Duplikate, die zugleich in Trainings- und Testmenge landen, etwa dasselbe Dokument in zwei Sprachfassungen.
- Merkmale, die aus der Zielgröße abgeleitet sind und es in der echten Anwendung gar nicht gäbe, wie ein Feld „Kündigungsgrund“ beim Vorhersagen von Kündigungen.
- Zeitreihen, die zufällig gemischt werden, sodass das Modell beim Training schon die Zukunft sieht.
- Statistiken wie Mittelwerte oder Vokabulare, die über dem gesamten Datensatz statt nur über dem Lernanteil berechnet wurden.
Warum dieselben Begriffe bei Sprachmodellen wieder auftauchen
Große Sprachmodelle ändern die Skala, nicht die Begriffe. Beim Pretraining wird der Verlust auf zurückgehaltenem Text verfolgt, und Entwickler achten darauf, dass Referenzaufgaben nicht in den Trainingsdaten stecken. Genau das ist Kontamination: Data Leakage im Maßstab von Benchmarks, die unbemerkt im Trainingstext mitgelernt wurden und dadurch geschönte Werte liefern. Beim Fine-Tuning auf kleinen eigenen Datensätzen ist klassisches Overfitting der Normalfall, wenn zu lange oder mit zu großer Lernrate trainiert wird; das Modell verliert dabei oft Fähigkeiten aus dem Vortraining, was als Catastrophic Forgetting beschrieben wird. Und die Frage „wie gut ist das Modell wirklich“ beantwortet auch hier nur eine sauber getrennte Prüfmenge, wie die Seite zu Evals im Detail zeigt.
Methode
Gelesen wurden am 20. Oktober 2026 die HTML-Fassung des Lehrbuchs „Deep Learning“ (Kapitel zu Kapazität, Overfitting und Regularisierung), Googles Machine Learning Crash Course, der Aufsatz von Pedro Domingos als PDF sowie die beiden genannten Seiten der scikit-learn-Dokumentation. Das Diagramm ist eine schematische Neuzeichnung des dort gezeigten Verlaufs, keine Messung.
Grenzen
Der Text erklärt die Begriffe an klassischem maschinellen Lernen und überträgt sie nur skizziert auf Sprachmodelle; dort wirken weitere Größen wie Datenmischung und Trainingsdauer mit. Zahlenbeispiele im Diagramm sind Illustrationen, keine empirischen Werte. Die genannten Faustregeln ersetzen keine eigene Messung auf der eigenen Datenlage.
Quellen
- Goodfellow, Bengio, Courville: Deep Learning (MIT Press, 2016), freie HTML-Fassung, deeplearningbook.org (abgerufen 2026-10-20) ↩1 ↩2
- Machine Learning Crash Course, Google for Developers (abgerufen 2026-10-20) ↩1 ↩2 ↩3
- Domingos: A Few Useful Things to Know about Machine Learning (PDF), Communications of the ACM 55(10), 2012 (abgerufen 2026-10-20) ↩1 ↩2
- Cross-validation: evaluating estimator performance, scikit-learn-Dokumentation (abgerufen 2026-10-20) ↩1 ↩2 ↩3
- Underfitting vs. Overfitting, scikit-learn-Dokumentation (abgerufen 2026-10-20) ↩1 ↩2 ↩3