 KI
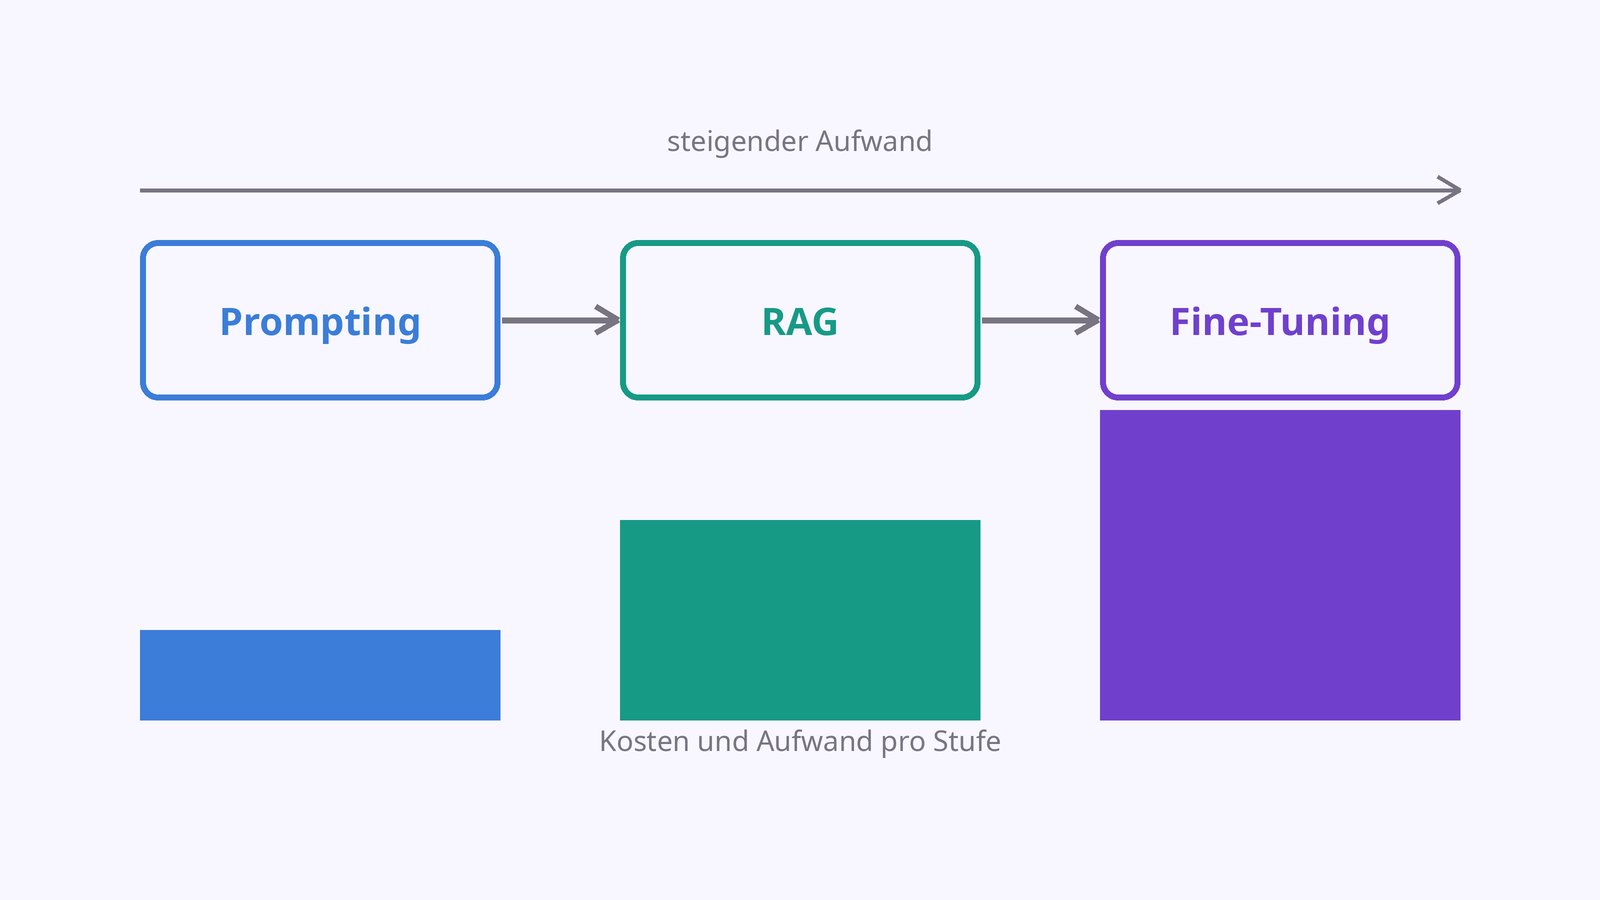
„Sollen wir ein Modell auf unsere Daten trainieren?“ ist eine der teuersten Fragen, die Teams vorschnell mit Ja beantworten. Dieser Text ordnet die drei Wege ein, ein Sprachmodell an die eigene Aufgabe zu bringen: Prompt-Engineering, RAG und Fine-Tuning. Am Ende steht eine Entscheidungsregel, mit der Sie den eigenen Fall einordnen können.
Drei Wege, drei Aufgaben
Prompting kostet kein Training: Kontext, Beispiele und Regeln wandern direkt in die Anfrage. Es ist der schnellste Hebel und der richtige Startpunkt; OpenAIs Leitfaden zum Fine-Tuning empfiehlt ausdrücklich, Prompt-Engineering, das Aufbrechen komplexer Aufgaben und das Mitgeben von Werkzeugen zuerst auszuschöpfen, weil viele Probleme damit bereits gelöst sind [1]. RAG bringt aktuelles, nachschlagbares Wissen bei: Eine Suche findet passende Textstücke, das Modell antwortet mit ihnen. Das Wissen bleibt aktualisierbar und zitierfähig, ohne je die Gewichte anzufassen. Fine-Tuning schließlich verändert die Gewichte selbst und damit das dauerhafte Verhalten des Modells [1][5].
| Kriterium | Prompting | RAG | Fine-Tuning |
|---|---|---|---|
| Was es ändert | Anweisung pro Anfrage | Kontext pro Anfrage | Gewichte des Modells |
| Gut für | Stil, Struktur, einfache Regeln | aktuelles, großes, zitierfähiges Wissen | festes Format, Ton, Domänensprache |
| Aktualisierung | sofort | Dokument austauschen | neues Training nötig |
| Kosten | nur laufende Token | Suche plus längere Prompts | einmalig Training, dann Betrieb |
| Risiko | Prompt wird lang und widersprüchlich | falsche Treffer vergiften die Antwort | Overfitting, Catastrophic Forgetting |
Was Fine-Tuning kann und was nicht
Die belastbare Faustregel: Fine-Tuning formt das Wie, nicht das Was. Es eignet sich, um ein festes Ausgabeformat durchzusetzen (etwa immer valides JSON in einem bestimmten Schema), einen bestimmten Ton oder Stil, das Befolgen fester Regeln oder die Sprache einer Domäne [1]. Googles Dokumentation zum Abstimmen von Modellen beschreibt denselben Zweck: Das Modell an wiederkehrende Aufgaben und gewünschte Ausgabemuster anpassen [5]. Was Fine-Tuning nicht zuverlässig leistet: dem Modell neues, veränderliches Faktenwissen beizubringen. Wissen, das sich ändert oder belegt werden muss, gehört in den Kontext, also in RAG; im Training würde es eingefroren, und das Modell kann Quellen dafür nicht nennen.
Die Kostenfrage: voll oder parameter-effizient
Volles Fine-Tuning aller Gewichte ist bei großen Modellen kaum noch praktikabel. Parameter-effiziente Verfahren (PEFT) trainieren nur einen kleinen Zusatz: LoRA friert die Originalgewichte ein und lernt kleine niedrigrangige Matrizen dazu; am Beispiel von GPT-3 mit 175 Milliarden Parametern berichtet das Paper etwa 10.000-mal weniger trainierbare Parameter und rund ein Drittel des GPU-Speichers gegenüber vollem Training, bei gleichwertiger oder besserer Qualität auf den untersuchten Aufgaben [4]. QLoRA senkt den Speicher weiter, indem das Basismodell in 4 Bit eingefroren wird. Der PEFT-Überblick mit über 50 untersuchten Verfahren zeigt zugleich: Unter realen Bedingungen, also knappe Rechenzeit und wenige Optimierungsdurchläufe, ist ein sauber eingestelltes LoRA schwer zu schlagen [3]. Die PEFT-Bibliothek von Hugging Face fasst die Verfahren in einer einheitlichen Programmierschnittstelle zusammen [2].
Die Entscheidungsregel für die Praxis
- Problem schriftlich festnageln: Welche Antworten sind heute schlecht, und woran genau scheitern sie? Ohne diese Liste keine Entscheidung.
- Prompting ausschöpfen: Bessere Anweisung, wenige gute Beispiele (Few-Shot-Prompting), Aufgabe zerlegen. Scheitert es an fehlendem Wissen, weiter zu 3; scheitert es an Verhalten und Format, weiter zu 4.
- RAG prüfen: Ist das Wissen vorhanden, groß oder veränderlich? Dann Retrieval bauen und mit einer eigenen Prüfmenge messen.
- Erst jetzt Fine-Tuning erwägen: Bleibt ein Verhaltensproblem übrig (Format, Stil, Domänenton), lohnt ein kleiner LoRA-Lauf. Die Schritt-für-Schritt-Anleitung folgt auf der Seite LoRA-Fine-Tuning.
- Vorher und nachher messen: Dieselbe Prüfmenge gegen Basismodell und trainiertes Modell; ohne diesen Vergleich keine Freigabe, wie die Seite zu Evals beschreibt.
Häufige Fehler
- Wissen trainieren statt beigeben: Preise, Öffnungszeiten oder Gesetzestexte ins Fine-Tuning zu legen friert sie ein; nach der nächsten Änderung lügt das Modell mit guten Manieren.
- Zu wenige oder schlechte Beispiele: Die Datenqualität begrenzt das Ergebnis; der PEFT-Vergleich zeigt, dass ein kleiner sauberer Datensatz einen großen schlampigen schlägt [3].
- Zu lange trainieren: Klassisches Overfitting, das Modell verliert Allgemeinwissen und bricht in Trainingsfloskeln aus.
- Kein Baseline-Vergleich: Ohne Messung gegen das unveränderte Modell ist „fühlt sich besser an“ die einzige Evidenz, und die trügt.
Methode
Gelesen wurden am 20. Oktober 2026 der Fine-Tuning-Leitfaden von OpenAI, die Tuning-Dokumentation von Google Cloud, die PEFT-Dokumentation von Hugging Face sowie die Abstracts und Kernabschnitte des LoRA-Papers und des PEFT-Überblicks. Die LoRA-Kennzahlen (Faktor 10.000 bei den trainierbaren Parametern, ein Drittel des GPU-Speichers) stammen aus dem Abstract des LoRA-Papers [4].
Grenzen
Die Vergleichstabelle ist eine redaktionelle Einordnung, keine Messung; die Grenzen zwischen den drei Wegen verschwimmen in konkreten Projekten. Die genannten LoRA-Kennzahlen beziehen sich auf die im Paper untersuchten Modelle und Aufgaben und sind keine Garantie für eigene Fälle. Preise für Training und Betrieb ändern sich laufend und wurden bewusst nicht genannt.
Quellen
- Model optimization: Fine-tuning, OpenAI API-Dokumentation (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4 ↩5
- PEFT: Parameter-Efficient Fine-Tuning, Hugging Face Dokumentation (abgerufen 2026-10-20) ↩
- Lialin u. a.: Scaling Down to Scale Up: A Guide to Parameter-Efficient Fine-Tuning, arXiv:2303.15647 (2023/24) (abgerufen 2026-10-20) ↩1 ↩2
- Hu u. a.: LoRA: Low-Rank Adaptation of Large Language Models, arXiv:2106.09685 (ICLR 2022) (abgerufen 2026-10-20) ↩1 ↩2 ↩3
- Introduction to tuning, Google Cloud, Vertex AI (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4