 KI
Diese Anleitung führt vom Verständnis bis zum ersten eigenen LoRA-Adapter: zuerst die Idee und eine nachvollziehbare Parameter-Rechnung, dann das Training mit den Werkzeugen PEFT und TRL und schließlich die Prüfung des Ergebnisses. Voraussetzung sind Grundkenntnisse in Python und die Begriffe aus ML-Grundbegriffe; die Entscheidungsfrage „lohnt sich das überhaupt“ beantwortet Fine-Tuning: wann es sich lohnt.
Wie LoRA funktioniert
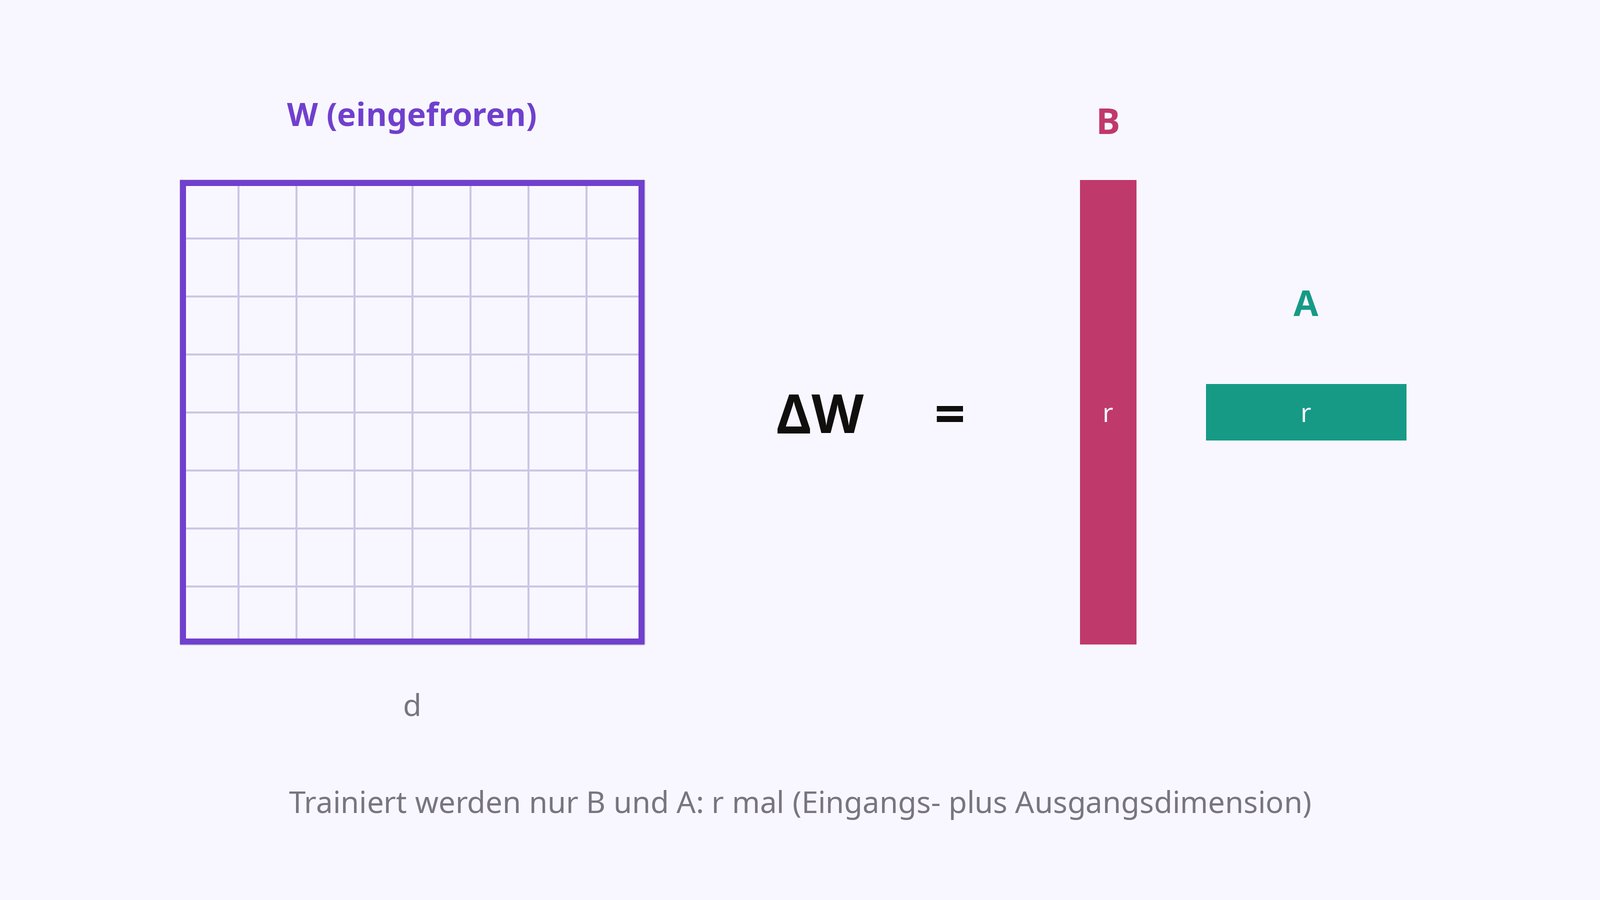
Beim vollen Fine-Tuning wird jede Gewichtsmatrix W des Modells verändert. LoRA beruht auf der Beobachtung, dass die nötige Änderung Delta-W viel einfacher ist als die Matrix selbst: Sie lässt sich als Produkt zweier schmaler Matrizen annähern, B mal A, mit einem kleinen Rang r [1]. In der Gleichung: W bleibt eingefroren, und die Ausgabe wird zu W·x + B·A·x. Trainiert werden nur A und B. Das Paper berichtet für GPT-3 mit 175 Milliarden Parametern rund 10.000-mal weniger trainierbare Parameter und etwa ein Drittel des GPU-Speichers gegenüber vollem Training, bei gleichwertiger oder besserer Qualität auf den untersuchten Aufgaben und ohne zusätzliche Verzögerung bei der Antwort, weil B mal A nach dem Training in W eingerechnet werden kann [1].
Eigene Rechnung: Was r=16 bei Llama 3 8B bedeutet
Llama 3 8B hat 32 Schichten, eine Modelldimension von 4.096 und durch Grouped-Query-Attention 8 Schlüssel- und Wert-Köpfe mit Kopfgröße 128; die q-Projektion bildet also 4.096 auf 4.096 ab, die v-Projektion 4.096 auf 1.024 [6]. LoRA ersetzt die Änderung jeder Projektion durch das Produkt zweier Matrizen vom Rang r; die Zahl der trainierbaren Parameter pro Projektion ist r mal (Eingangs- plus Ausgangsdimension). Mit r=16, nur auf q und v angesetzt (das Standardbeispiel der PEFT-Dokumentation [3]):
| Position | Rechnung | Parameter pro Schicht |
|---|---|---|
| q-Projektion | 16 × (4.096 + 4.096) | 131.072 |
| v-Projektion | 16 × (4.096 + 1.024) | 81.920 |
| Summe pro Schicht | 212.992 | |
| Alle 32 Schichten | 212.992 × 32 | 6.815.744 |
Rund 6,8 Millionen trainierbare Parameter stehen etwa 8 Milliarden eingefrorenen gegenüber: 0,085 Prozent des Modells. Wer alle linearen Schichten einschließlich des Feed-Forward-Netzes anpasst (in PEFT die Einstellung target_modules=„all-linear“ [3]), landet mit derselben Rechnung bei rund 42 Millionen Parametern, etwa einem halben Prozent. Der Adapter speichert am Ende nur diese Zusatzgewichte: bei 16 Bit pro Wert also etwa 14 MB statt 16 GB für das ganze Modell.
QLoRA: der Adapter auf einem 4-Bit-Modell
QLoRA kombiniert LoRA mit Quantisierung: Das Basismodell wird in 4 Bit eingefroren (das Paper führt dafür den Datentyp NF4 ein, dazu doppelte Quantisierung der Quantisierungskonstanten und ausgelagerte Optimizer-Zwischenstände gegen Speicherspitzen), und die Gradienten laufen durch das eingefrorene 4-Bit-Modell in den Adapter [2]. Damit trainierten die Autoren ein Modell mit 65 Milliarden Parametern auf einer einzigen GPU mit 48 GB, ohne messbaren Qualitätsverlust gegenüber vollem 16-Bit-Training; ihre beste Guanaco-Modellreihe erreichte auf dem Vicuna-Vergleich 99,3 Prozent des Referenzmodells ChatGPT nach 24 Stunden Training auf einer GPU [2]. Die nötigen 4-Bit-Bausteine liefert die Bibliothek bitsandbytes, die 8-Bit-Optimierer und 4-Bit-Linear-Schichten genau für diesen Zweck bereitstellt [5].
Der Trainingslauf mit PEFT und TRL
Die Bibliothek PEFT von Hugging Face kapselt LoRA in einer Konfiguration, der Trainer SFTTrainer aus TRL übernimmt das überwachte Nachtrainieren auf eigenen Beispielen [3][4]. Das Grundgerüst ist kurz:
from peft import LoraConfig, get_peft_model
from trl import SFTTrainer
from datasets import load_dataset

config = LoraConfig(
    r=16, lora_alpha=16, lora_dropout=0.1,
    target_modules=["q_proj", "v_proj"], bias="none",
)
model = get_peft_model(base_model, config)

trainer = SFTTrainer(
    model=model,
    train_dataset=load_dataset("deine-beispiele", split="train"),
)
trainer.train()- Beispieldaten bauen: Dialoge oder Ein-/Ausgabe-Paare im gewünschten Stil und Format; der TRL-Dokumentation zufolge erwartet der SFTTrainer einen Datensatz im Text- oder Nachrichtenformat [4]. Qualität und Einheitlichkeit schlagen Menge.
- Konfigurieren: Rang r und Zielmodule wählen; r=16 auf q und v ist der dokumentierte Startpunkt [3].
- Trainieren: Verlust auf den Trainingsdaten beobachten, aber die Entscheidung an einer getrennten Validierungsmenge festmachen.
- Prüfen: Basismodell und Adapter gegen dieselbe Prüfmenge laufen lassen, wie auf der Seite zu Evals beschrieben.
- Einrechnen oder getrennt lassen: Der Adapter lässt sich für maximale Antwortgeschwindigkeit in die Gewichte einrechnen oder als kleine Datei neben dem Basismodell verwalten [1].
Häufige Fehler beim ersten Adapter
- Zu hohe Lernrate oder zu viele Epochen: Der Adapter lernt die Beispiele auswendig (Overfitting), das Modell verliert Allgemeinverhalten (Catastrophic Forgetting).
- Datenmüll: Widersprüchliche oder uneinheitliche Beispiele; der PEFT-Vergleich zeigt, dass einfache, sauber eingestellte LoRA-Läufe unter realen Bedingungen stark sind, Datenqualität aber nicht ersetzen können [3][7].
- Kein Vergleich gegen das Basismodell: Ohne die gleiche Prüfmenge auf beiden Modellen ist unklar, ob der Adapter hilft oder schadet.
- Falsches Ziel: Fine-Tuning für veränderliches Wissen statt für Verhalten, siehe Fine-Tuning: wann es sich lohnt.
Methode
Gelesen wurden am 20. Oktober 2026 die Abstracts und Methodikteile der LoRA- und QLoRA-Papers, die PEFT-Dokumentation zu LoraConfig einschließlich des Beispiels r=16 auf den q- und v-Projektionen, die TRL-Dokumentation zum SFTTrainer, das README von bitsandbytes und die Architektur-Tabelle des Llama-3-Berichts. Die Parameter-Rechnung wurde mit den dort genannten Dimensionen (32 Schichten, Modell-Dimension 4.096, 8 Key/Value-Köpfe à 128) selbst nachgerechnet und ist als eigene Rechnung gekennzeichnet.
Grenzen
Die eigene Rechnung zählt nur die Adapter-Parameter, nicht Aktivierungen und Optimizer-Zwischenstände; der tatsächliche Speicherbedarf beim Training liegt über den hier genannten Werten für die Adapterdatei. Die Code-Skizze ist bewusst minimal und weicht je nach Bibliotheksversion in Details ab; sie ist nicht als lauffähiges Komplettprogramm geprüft. Hardware-Angaben (16 bis 24 GB) sind grobe Richtwerte aus den dokumentierten Beispielen, keine Messung der Redaktion.
Quellen
- Hu u. a.: LoRA: Low-Rank Adaptation of Large Language Models, arXiv:2106.09685 (ICLR 2022) (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4
- Dettmers u. a.: QLoRA: Efficient Finetuning of Quantized LLMs, arXiv:2305.14314 (NeurIPS 2023) (abgerufen 2026-10-20) ↩1 ↩2 ↩3
- PEFT: LoRA-Konfiguration (LoraConfig), Hugging Face Dokumentation (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- SFT Trainer, Hugging Face TRL-Dokumentation (abgerufen 2026-10-20) ↩1 ↩2 ↩3
- bitsandbytes: 8-Bit-Optimierer und 4-Bit-Quantisierung (README), GitHub, bitsandbytes-foundation (abgerufen 2026-10-20) ↩
- The Llama 3 Herd of Models (Architektur-Tabelle), arXiv:2407.21783 (Meta, 2024) (abgerufen 2026-10-20) ↩1 ↩2
- Lialin u. a.: Scaling Down to Scale Up: A Guide to Parameter-Efficient Fine-Tuning, arXiv:2303.15647 (2023/24) (abgerufen 2026-10-20) ↩