 KI
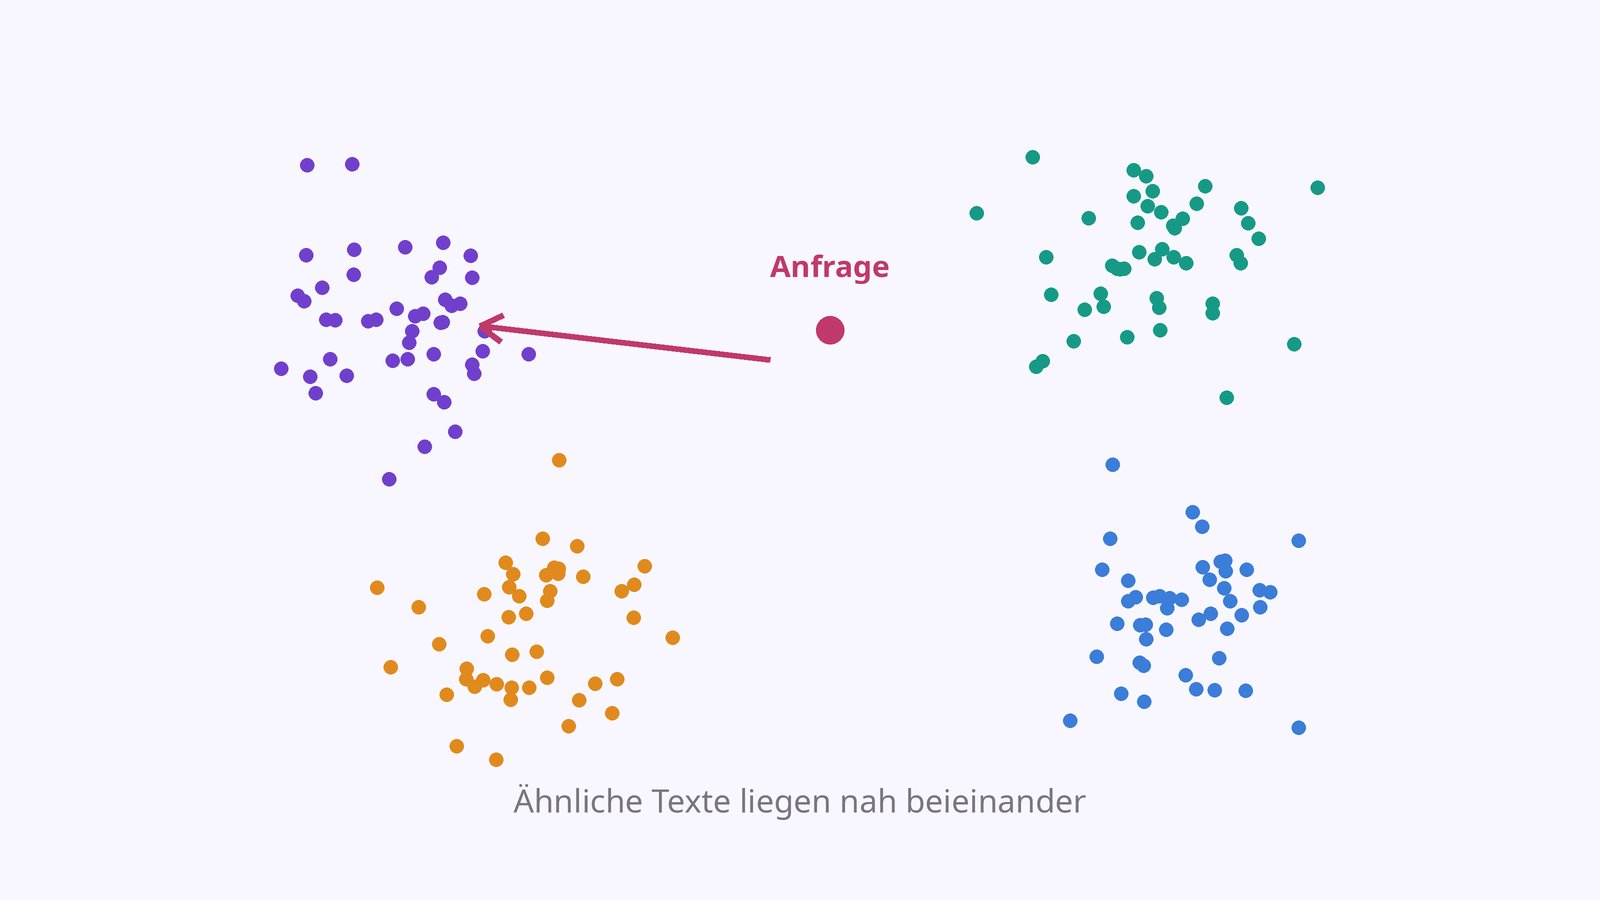
Suchmaschinen, Empfehlungssysteme und RAG-Anwendungen beruhen auf einem gemeinsamen Trick: Sie übersetzen Text in Zahlenreihen und lassen den Computer mit diesen Reihen rechnen, statt Wörter zu vergleichen. Diese Zahlenreihen heißen Embeddings. Dieser Text erklärt, woher sie kommen, wie man ihre Ähnlichkeit misst, wie die Suche in Millionen von Vektoren schnell bleibt und woran man ein gutes Embedding-Modell erkennt.
Was ein Embedding ist
Ein Embedding-Modell bildet ein Wort, einen Satz oder ein Dokument auf einen Vektor ab, also eine Zahlenreihe fester Länge, häufig einige hundert bis wenige tausend Zahlen. Gelernt wird diese Abbildung aus großen Textmengen: Wörter, die in ähnlichen Zusammenhängen auftreten, bekommen ähnliche Vektoren. Das word2vec-Verfahren von 2013 zeigte, dass solche Vektoren aus 1,6 Milliarden Wörtern in unter einem Tag lernbar sind und dass in ihnen Beziehungen als Richtungen stecken, im berühmten Beispiel „König minus Mann plus Frau“ nahe bei „Königin“ [1].
Wichtig ist der Unterschied zum Tokenizer: Der Tokenizer zerlegt Text in Nummern aus einem festen Wörterbuch; jede Nummer steht für ein Wortteilchen und sagt nichts über Bedeutung aus. Das Embedding dagegen ist eine gelernte Ortsangabe im Bedeutungsraum. Zwei Sätze mit gleichem Sinn landen nah beieinander, auch wenn sie kein einziges Wort teilen.
Von Wörtern zu Sätzen: Sentence-BERT
Frühe Transformer-Modelle wie BERT konnten die Ähnlichkeit zweier Sätze sehr genau beurteilen, aber nur, indem beide Sätze gemeinsam durch das Modell liefen. Für die ähnlichste Paarung unter 10.000 Sätzen wären das rund 50 Millionen Modellaufrufe, von den Autoren auf etwa 65 Stunden geschätzt. Sentence-BERT (SBERT) von 2019 löste das Problem, indem es jeden Satz einzeln in einen festen Vektor übersetzt, den man einmal berechnet und speichert. Dieselbe Suche dauerte damit etwa 5 Sekunden, bei gleichbleibender Genauigkeit [2]. Dieser Schritt, von der Paarbewertung zur speicherbaren Regalposition, machte semantische Suche erst alltagstauglich.
Ähnlichkeit messen: Kosinus-Ähnlichkeit
Liegen Texte als Vektoren vor, braucht es ein Maß für Nähe. Üblich ist die Kosinus-Ähnlichkeit: Sie misst den Winkel zwischen zwei Vektoren und ist damit unempfindlich gegen deren Länge. Werte nahe 1 bedeuten „gleiche Richtung, gleiches Thema“, Werte nahe 0 „unabhängig“. In der Praxis folgt daraus eine einfache Arbeitsweise: Einmalig alle Dokumente in Vektoren übersetzen und speichern, zur Anfrage nur noch deren Vektor berechnen und die nächsten Nachbarn ausliefern.
Vektorsuche: von exakt zu approximativ
Bei einigen tausend Dokumenten genügt die exakte Suche: Jede Anfrage wird mit jedem gespeicherten Vektor verglichen. Bei Millionen von Einträgen wird das zu langsam, und hier setzen approximative Verfahren an. HNSW baut einen mehrschichtigen Nähe-Graphen über den Punkten; die Suche startet auf der groben obersten Ebene und steigt in immer feinere Ebenen hinab, wodurch der Aufwand nur noch logarithmisch mit der Datenmenge wächst [3]. Die Bibliothek FAISS bündelt solche Indexverfahren samt Kompression und GPU-Unterstützung; das zugehörige Paper beschreibt den Grundkompromiss der Vektorsuche: Ein kleiner Verlust an Treffergenauigkeit (Recall) erkauft große Geschwindigkeits- und Speichervorteile [4]. Eine Vektordatenbank packt Index, Speicher und Filterlogik schließlich in einen Dienst.
Modelle vergleichen: der MTEB-Benchmark
Welches Embedding-Modell ist gut? Der Massive Text Embedding Benchmark (MTEB) antwortet mit Breite statt mit einer Einzelaufgabe: 8 Aufgabentypen, 58 Datensätze und 112 Sprachen im ursprünglichen Benchmark, gegen den 33 Modelle gemessen wurden [5]. Das Ergebnis der Autoren ist für die Praxis der wichtigste Satz: Kein Verfahren dominiert über alle Aufgaben. Ein Modell, das semantische Ähnlichkeit spitze kann, kann beim Clustern oder Klassifizieren mittelmäßig sein [5]. Die öffentliche Bestenliste läuft als Hugging-Face-Space weiter und wird laufend mit neuen Modellen gefüttert [6]. Die Konsequenz gleicht der bei Sprachmodellen: Eine kleine eigene Prüfmenge aus echten Anfragen und Dokumenten schlägt jede Fremdtabelle, wie die Seite zu Evals ausführt.
Praxis und Grenzen
- Semantische Suche: Anfragen finden Dokumente ohne gemeinsame Stichwörter, etwa findet „Reifenplatzer“ die Anleitung „Pannenhilfe“.
- RAG: Vor dem Generieren werden passende Textstücke gesucht und dem Modell beigegeben; die Qualität der Embeddings entscheidet, was das Modell überhaupt zu sehen bekommt.
- Clustern und Klassifizieren: Themen entdecken, Dubletten erkennen, Supportfälle vorsortieren, ohne dass je ein Mensch Regeln geschrieben hätte.
- Empfehlungen: „Ähnliche Artikel“ ist wörtlich gemeint: die nächsten Punkte im Raum.
Die Grenzen liegen in den Trainingsdaten der Modelle. Wechselt die Domäne, etwa von Nachrichtentext zu Laborjargon, können Abstände ihre Bedeutung verlieren; mehrsprachige Anfragen brauchen ausdrücklich mehrsprachig trainierte Modelle, und bei langen Dokumenten entscheidet das Chunking mit darüber, was überhaupt auffindbar ist. Auch hier gilt: Vor dem Rollout mit eigenen Beispielen messen, nicht auf Listenplätze vertrauen [5][6].
Methode
Gelesen wurden am 20. Oktober 2026 die Abstracts und Kernabschnitte der fünf genannten Papers (word2vec, Sentence-BERT, HNSW, FAISS, MTEB) sowie die Startseite der MTEB-Bestenliste auf Hugging Face. Die Angaben zu Rechenzeiten (65 Stunden gegenüber 5 Sekunden) und zur Benchmark-Größe (8 Aufgabentypen, 58 Datensätze, 112 Sprachen, 33 Modelle) stammen unverändert aus den Quellen [2] und [5].
Grenzen
Die Verfahren wurden anhand ihrer Papers beschrieben, nicht selbst nachgemessen; die genannten Laufzeiten stammen aus der Hardware-Umgebung der jeweiligen Autoren. Die MTEB-Bestenliste verändert sich laufend, Platzierungen einzelner Modelle werden hier bewusst nicht genannt. Die Aussage zur Rekonstruierbarkeit von Embeddings im FAQ stammt aus der Sekundärliteratur und wurde nicht quantifiziert.
Quellen
- Mikolov u. a.: Efficient Estimation of Word Representations in Vector Space, arXiv:1301.3781 (2013) (abgerufen 2026-10-20) ↩
- Reimers, Gurevych: Sentence-BERT: Sentence Embeddings using Siamese BERT-Networks, arXiv:1908.10084 (EMNLP 2019) (abgerufen 2026-10-20) ↩1 ↩2
- Malkov, Yashunin: Efficient and robust approximate nearest neighbor search using Hierarchical Navigable Small World graphs, arXiv:1603.09320 (TPAMI 2020) (abgerufen 2026-10-20) ↩
- Douze u. a.: The Faiss library, arXiv:2401.08281 (Meta, 2024) (abgerufen 2026-10-20) ↩
- Muennighoff u. a.: MTEB: Massive Text Embedding Benchmark, arXiv:2210.07316 (EACL 2023) (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4
- MTEB Leaderboard, Hugging Face Space, laufend aktualisiert (abgerufen 2026-10-20) ↩1 ↩2