 KI
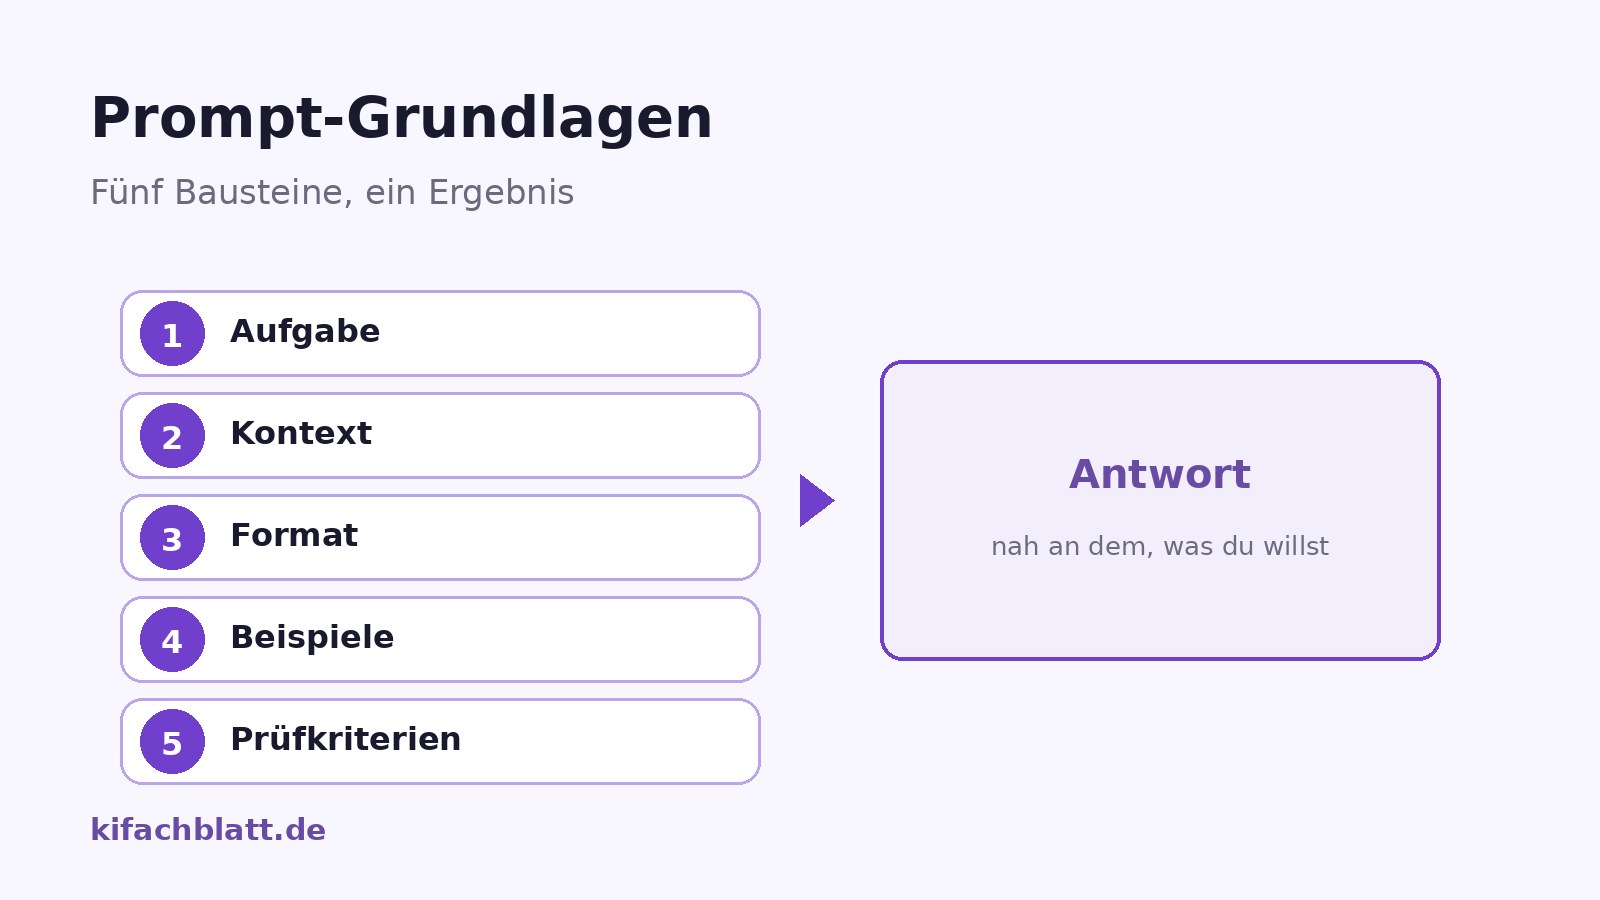
Ein Prompt ist der Text, den du einem Sprachmodell als Auftrag gibst. Das Modell kennt dich nicht, es kennt nur diesen Text und das, was im selben Kontextfenster steht. Alles, was die Antwort braucht, muss also im Prompt stecken oder bekanntes Weltwissen sein. Genau daraus folgen alle Prompting-Regeln.
Dieser Text erklärt den Aufbau guter Prompts ohne Vorwissen, mit einer Alltagsanalogie und Beispielen zum Kopieren. Wer danach tiefer einsteigen will, findet die offiziellen Leitfäden von OpenAI und Anthropic in den Quellen [1][2].
Wer eigentlich mit wem spricht
In Chat-Programmen gibt es zwei Ebenen von Anweisungen. Der System-Prompt steht über dem Gespräch und legt Rahmenregeln fest, etwa Rolle, Stil und Verbote; ihn setzen Entwickler oder die App. Deine Nachrichten sind der Nutzer-Prompt. Bei Konflikten gewinnt in der Regel die höhere Ebene. Als Nutzer musst du den System-Prompt nicht schreiben können, aber es hilft zu wissen, dass er existiert – er erklärt, warum sich derselbe Prompt in verschiedenen Apps unterschiedlich anfühlt.
Die fünf Bausteine eines guten Prompts
| Baustein | Leitfrage | Beispiel |
|---|---|---|
| Aufgabe | Was genau soll herauskommen? | „Schreibe eine E-Mail, die den Termin verschiebt.“ |
| Kontext | Was muss das Modell über die Lage wissen? | „Der Kunde wartet seit einer Woche, es ist das zweite Verschieben.“ |
| Format | Wie soll die Antwort aussehen? | „Maximal acht Sätze, keine Aufzählung.“ |
| Beispiele | Wie sieht gut aus? | „So klang die letzte Mail an ihn: …“ |
| Prüfkriterien | Woran erkennst du ein gutes Ergebnis? | „Der neue Termin muss konkret sein, nicht ‚bald‘.“ |
OpenAI fasst den Kern so zusammen: schreibe klare Anweisungen, liefere Referenztext, zerlege komplexe Aufgaben und gib dem Modell Zeit zu „denken“ [1]. Anthropic betont dasselbe Grundprinzip: Sei klar und direkt, nutze Beispiele und gib dem Modell Ausgabestruktur vor [2]. Hinter beiden steht eine einfache Logik: Jedes Wort im Prompt verengt den Raum dessen, was das Modell als nächstes Token für wahrscheinlich hält.
Zero-Shot und Few-Shot
Zwei Begriffe aus Modellkarten sind hier zu Hause. Zero-Shot heißt: Du stellst die Aufgabe ohne Beispiel. Few-Shot heißt: Du gibst ein bis fünf Beispiele für gewünschte Ein- und Ausgaben mit, und das Modell setzt das Muster fort. Der Begriff geht auf das GPT-3-Papier von 2020 zurück, das zeigte, dass ein großes Modell neue Aufgaben allein aus wenigen Beispielen im Prompt lösen kann, ohne nachtrainiert zu werden [3].
In der Praxis: Solange die Aufgabe alltäglich ist, reicht Zero-Shot. Sobald du ein bestimmtes Format, einen Ton oder eine fachliche Konvention brauchst, schlägt Few-Shot fast jede Beschreibung. Ein gutes Beispiel ist wie eine Musterlösung im Praktikum: Es zeigt, was gemeint ist, statt es zu erklären.
So sieht der Unterschied aus
Schwach:
„Schreib was über Quantisierung.“

Stärker:
„Erkläre Quantisierung von Sprachmodellen in 150 Wörtern
für Leser ohne Informatik-Hintergrund. Nutze die Analogie
einer komprimierten Fotodatei. Keine Formeln. Nenne am
Ende zwei Grenzen des Verfahrens.“
Der zweite Prompt deckt alle fünf Bausteine ab: Aufgabe (erklären), Kontext (Zielgruppe ohne Informatik), Format (150 Wörter, keine Formeln), Beispiel (die Analogie) und Prüfkriterium (zwei Grenzen am Ende). Das Ergebnis wird nicht jedes Mal perfekt sein, aber es wird messbar näher an dem liegen, was du willst.
Iterieren statt perfekt formulieren
Beide Anbieter empfehlen ausdrücklich, Prompts schrittweise zu verbessern statt den perfekten ersten Versuch zu suchen [1][2]. Der Arbeitsablauf ist immer derselbe: Ergebnis lesen, die größte Abweichung benennen, die Anweisung genau an dieser Stelle schärfen, erneut versuchen. Nach zwei bis drei Runden sitzt der Prompt meist. Wer dieselbe Aufgabe öfter hat, speichert die funktionierende Fassung als Vorlage – daraus wird mit der Zeit eine persönliche Prompt-Bibliothek.
Was Prompting nicht ändert
Drei Grenzen bleiben, egal wie gut der Prompt ist. Erstens: Das Modell weiß nur, was in seinen Trainingsdaten oder im Kontext steht; fehlt das Wissen, erfindet es manchmal – eine Halluzination. Kein Prompt-Verbot macht erfundene Quellen unmöglich, nur das Prüfen schützt. Zweitens: Die Temperatur steuert, wie zufällig das Modell wählt; bei höherer Temperatur streuen die Antworten stärker. Drittens: Modelle neigen zu Sycophancy, sie bestätigen dich eher, als dich zu korrigieren. Wer ehrliche Kritik will, sollte sie ausdrücklich einfordern: „Finde drei Schwächen in meinem Text.“
Damit ist der Grundkurs fertig. Vertiefen kannst du ihn mit Few-Shot-Prompting in der Praxis, System-Prompts und Rollen und Prompt-Iteration und Debugging. Für eigene Qualitätskontrollen lohnt danach der Artikel Evals: Testen statt Bauchgefühl.
Methode
Gelesen wurden am 20. Oktober 2026 der Prompt-Engineering-Leitfaden von OpenAI, die Prompt-Engineering-Übersicht von Anthropic und der Abstract sowie die Einleitung des GPT-3-Papiers (arXiv:2005.14165). Die fünf Bausteine sind eine redaktionelle Verdichtung der beiden Anbieter-Leitfäden, das Code-Beispiel ist ein eigenes Praxisbeispiel der Redaktion. Der Text entstand mit KI-Unterstützung und wurde von der Redaktion verantwortet.
Grenzen
Die Leitfäden der Anbieter werden laufend überarbeitet; einzelne Empfehlungen (etwa zu Reasoning-Modellen) gelten nur für bestimmte Modellserien. Von den gelesenen Papieren wurde beim GPT-3-Papier nicht der Volltext, sondern Abstract und Einleitung ausgewertet. Die Baustein-Tabelle vereinfacht bewusst: Profi-Techniken wie Chain of Thought oder strukturierte Ausgaben sind eigenen Artikeln vorbehalten.
Quellen
- Prompt engineering (Leitfaden), OpenAI, Plattform-Dokumentation (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4
- Prompt engineering overview, Anthropic, Claude-Dokumentation (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4
- Language Models are Few-Shot Learners (Brown u. a., 2020), arXiv:2005.14165 (abgerufen 2026-10-20) ↩