 KI
Manche Anweisungen will man einem Sprachmodell gar nicht in Worte fassen. Wie klingt unsere Antwort an verärgerte Kunden? Nach welchem Muster kürzen wir Überschriften? Statt drei Absätze Regeln zu schreiben, ist es oft wirksamer, dem Modell einfach zwei oder drei fertige Beispiele vorzulegen. Genau das ist Few-Shot-Prompting: Der Prompt enthält einige gelöste Beispielfälle, danach folgt die neue, ungelöste Aufgabe. Das Modell setzt das Muster fort, ohne dass ein einziges Gewicht verändert wird.
Erfunden hat die Technik nicht der Alltag, sondern ein Paper: In Language Models are Few-Shot Learners zeigten OpenAI-Forschende 2020, dass GPT-3 mit 175 Milliarden Parametern Aufgaben lösen kann, die es nie trainiert hat, allein weil ein paar Beispiele im Eingabetext stehen. Sie nannten das In-Context Learning und testeten drei Stufen: Zero-Shot (nur die Anweisung), One-Shot (ein Beispiel) und Few-Shot (typischerweise 10 bis 100 Beispiele, soweit sie ins Kontextfenster passten) [1].
Was die Zahlen zeigen
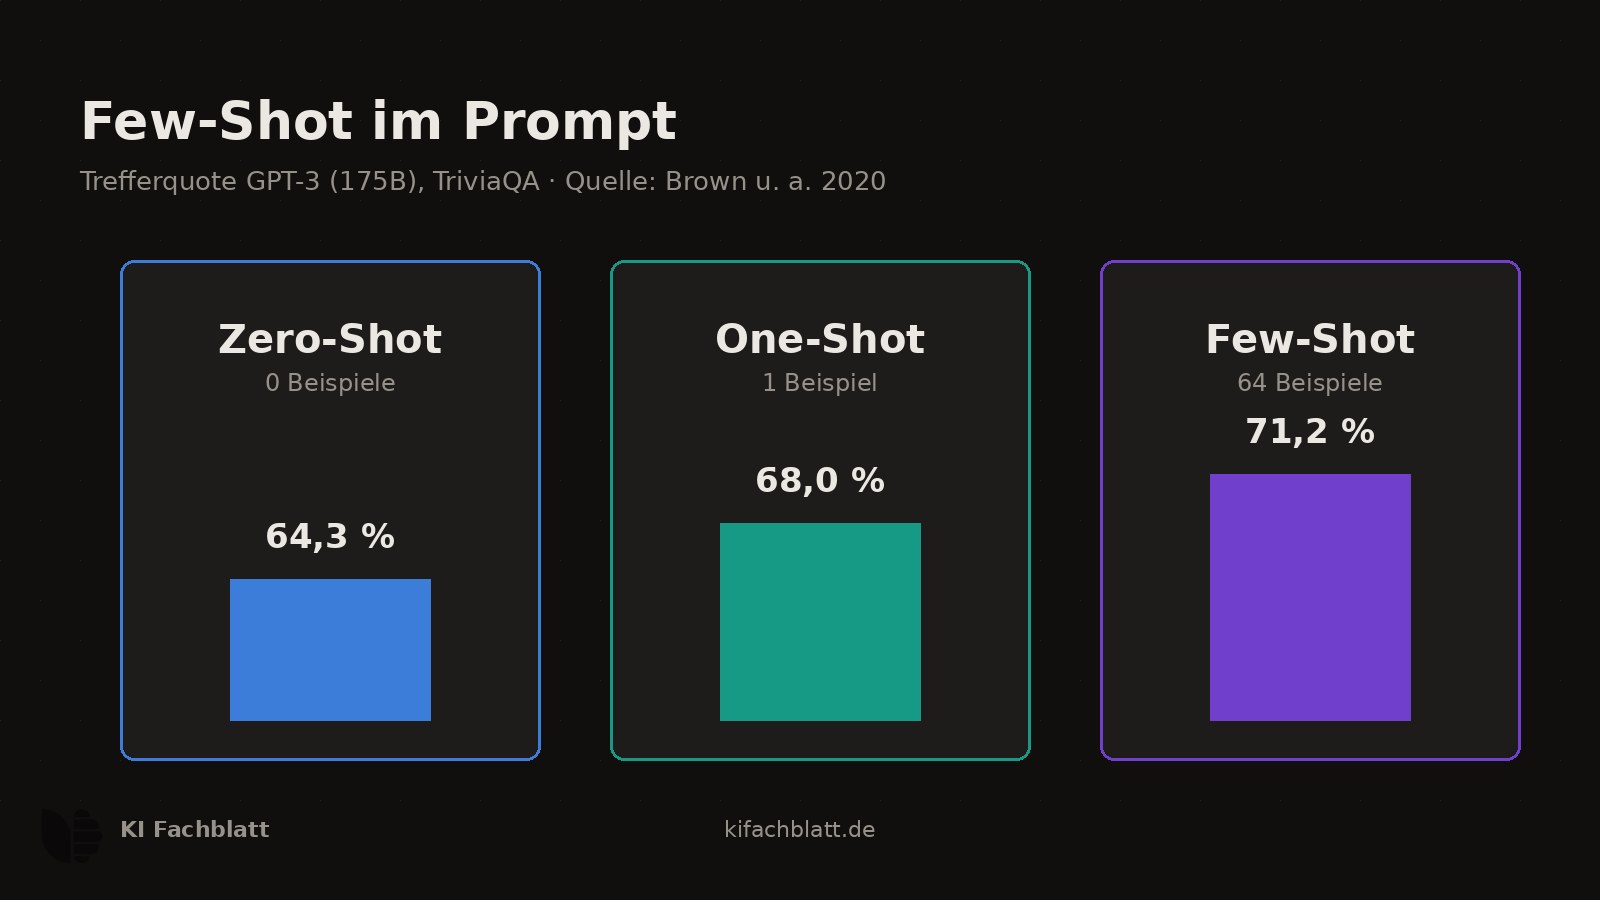
Die gemessenen Sprünge sind je nach Aufgabe unterschiedlich groß, folgen aber einem stabilen Muster: Der größte Gewinn entsteht schon beim ersten Beispiel. Bei der Wissensaufgabe TriviaQA stieg GPT-3 (175B) von 64,3 % (Zero-Shot) auf 68,0 % (One-Shot) und 71,2 % (64 Beispiele). Bei LAMBADA, einer Aufgabe zum Vervollständigen von Textstellen, stieg die Trefferquote von 68,4 % über 73,2 % auf 76,2 % [1].
- TriviaQA
- LAMBADA
Daten als Tabelle
| TriviaQA | LAMBADA | |
|---|---|---|
| Zero-Shot | 64,3% | 68,4% |
| One-Shot | 68% | 73,2% |
| Few-Shot (64) | 71,2% | 76,2% |
Quelle: Brown u. a. 2020 [1]
Werte aus dem GPT-3-Paper [1]; jeweils Zero-Shot, One-Shot und Few-Shot (64 Beispiele). Eigene Darstellung.
Zwei Lesarten sind wichtig. Erstens: Few-Shot ist kein Freifahrtschein. Bei vielen Aufgaben blieb GPT-3 auch mit Beispielen hinter feinabgestimmten Modellen zurück, und das Paper weist selbst auf Aufgaben hin, bei denen Beispiele fast nichts brachten [1]. Zweitens: Die Kurve flacht ab. Vom nullten zum ersten Beispiel ist der Sprung groß, vom zehnten zum sechzigsten klein. Wer Beispiele in den Prompt packt, kauft jedes weitere mit teurer werdenden Token bei sinkendem Zusatznutzen.
Der überraschende Befund: Falsche Antworten schaden kaum
Die gängige Annahme war lange: Beispiele wirken, weil das Modell aus ihnen die richtige Zuordnung lernt. Die Arbeit Rethinking the Role of Demonstrations (Min u. a., 2022) hat das direkt geprüft. Das Ergebnis: Ersetzt man in den Beispielen die korrekten Antworten durch zufällige Antworten aus demselben Antwortraum, fällt die Leistung nur um wenige Prozentpunkte. Fast ebenso gut funktionierten also Beispiele mit falschen Lösungen [2].
Was stattdessen trug, waren drei Dinge: dass die Beispiele den möglichen Antwortraum zeigen (zum Beispiel die Kategorien positiv, negativ, neutral), dass die Beispieleingaben aus derselben Art von Aufgaben stammen, und dass das Format von Eingabe und Ausgabe konsistent ist [2]. Für die Praxis heißt das: Perfektion bei jedem Beispiel ist weniger wichtig als ein sauberes, einheitliches Schema. Ein Tippfehler in einer Beispielantwort ist verzeihlich, ein wechselndes Antwortformat nicht.
Beispiele richtig bauen: die fünf Hebel
Aus den Befunden und der Dokumentationspraxis lassen sich fünf Hebel ableiten, die in der Reihenfolge ihrer Wirkung geprüft werden sollten [2][4]:
- Format zuerst. Alle Beispiele folgen exakt demselben Muster: gleiche Trenner, gleiche Reihenfolge von Eingabe und Ausgabe, gleiche Schreibweise der Antwort. Die neue Aufgabe am Ende sieht genauso aus, nur ohne Antwort.
- Antwortraum zeigen. Jede Kategorie, die das Modell benutzen darf, sollte mindestens einmal vorkommen. Wer drei Klassen will, aber nur zwei zeigt, bekommt selten die dritte.
- Typische Fälle, keine Kunststücke. Beispiele sollen die Verteilung der echten Anfragen abbilden: häufige Fälle zuerst, ein bis zwei Grenzfälle, keine Sammlung von Spezialfällen, die im Alltag nie vorkommen.
- Anzahl klein halten. Beginne mit zwei bis vier Beispielen. Mehr Beispiele kosten Token und bringen nach dem Paper-Verlauf wenig zusätzliche Trefferquote [1]. Nur wenn Fehler auftreten, gezielt ergänzen.
- Reihenfolge prüfen. Sprachmodelle gewichten das Ende des Prompts stark. Das Beispiel direkt vor der neuen Aufgabe sollte ein klarer, unstrittiger Fall sein, kein Grenzfall.
Was Beispiele kosten: eine kleine Rechnung
Beispiele werden bei jeder Anfrage erneut mitgeschickt. Acht Beispiele mit je rund 100 Token sind 800 Eingabe-Token zusätzlich pro Aufruf. Bei 100.000 Aufrufen im Monat summiert sich das auf 80 Millionen zusätzliche Eingabe-Token (eigene Rechnung: 800 mal 100.000). Je nach Modell und Preisliste kann das die Kosten einer Integration spürbar verschieben; die genauen Sätze hängen vom Anbieter ab und ändern sich regelmäßig. Gegenmittel: weniger, dafür treffendere Beispiele, Prompt-Caching, wo der Anbieter es anbietet, oder bei sehr stabilen Aufgaben ein Fine-Tuning, das die Beispiele ins Modell verlagert.
Wann Few-Shot nicht reicht
Bei Aufgaben mit Zwischenschritten, etwa Rechenwegen oder mehrstufigen Schlüssen, helfen reine Antwortbeispiele wenig. Hier zeigt die Arbeit zu Chain of Thought den Ausweg: Die Beispiele enthalten nicht nur die Lösung, sondern den ausgeschriebenen Lösungsweg. Ausreichend große Modelle imitieren dann den Weg, nicht nur das Ergebnis, und verbessern sich bei Rechen- und Logikaufgaben deutlich [3]. Wer also Beispiele für knifflige Aufgaben baut, sollte den Rechenweg im Beispiel vormachen, nicht nur das Resultat.
Und es gibt den umgekehrten Fall: Moderne Reasoning-Modelle und gut instruct-trainierte Modelle lösen viele Standardaufgaben inzwischen ohne Beispiele zuverlässig. Bevor man eine Few-Shot-Konstruktion baut, lohnt der einfache Test: dieselbe Aufgabe einmal ohne Beispiel stellen. Bringt das Modell die Leistung schon mit, kosten Beispiele nur Token und Wartung. Few-Shot ist ein Werkzeug für den Fall, dass Anweisungen allein das gewünschte Format oder die gewünschte Entscheidungslogik nicht zuverlässig treffen; kein Pflichtbestandteil jedes Prompts.
Methode
Gelesen wurden am 19. Oktober 2026 die arXiv-Seiten der drei zitierten Papers (GPT-3, Rethinking Demonstrations, Chain-of-Thought) sowie die Few-Shot-Seite des Prompting Guide. Die Werte für TriviaQA und LAMBADA sind den Ergebnistabellen des GPT-3-Papers entnommen und wurden hier als Diagramm neu dargestellt. Die Token-Kostenrechnung ist eine eigene Rechnung mit gerundeten Annahmen (100 Token pro Beispiel, 100.000 Aufrufe) und dient der Größenordnung, nicht der Abrechnung.
Grenzen
Alle Leistungszahlen stammen aus den Papers der jeweiligen Autoren, gemessen an GPT-3 und den dortigen Testdaten; sie wurden nicht unabhängig reproduziert und lassen sich nicht eins zu eins auf heutige Modelle übertragen. Der Befund zu zufälligen Antworten [2] wurde an Klassifikations- und Multiple-Choice-Aufgaben erhoben und gilt nicht ohne Weiteres für freie Textgenerierung. Der Prompting Guide ist ein Community-Projekt ohne Peer-Review.
Quellen
- Language Models are Few-Shot Learners, arXiv:2005.14165 (Brown u. a., OpenAI, NeurIPS 2020) (abgerufen 2026-10-19) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- Rethinking the Role of Demonstrations: What Makes In-Context Learning Work?, arXiv:2202.12837 (Min u. a., EMNLP 2022) (abgerufen 2026-10-19) ↩1 ↩2 ↩3 ↩4 ↩5
- Chain-of-Thought Prompting Elicits Reasoning in Large Language Models, arXiv:2201.11903 (Wei u. a., Google Research, NeurIPS 2022) (abgerufen 2026-10-19) ↩1 ↩2
- Few-Shot Prompting, Prompting Guide (DAIR.AI, Community-Projekt) (abgerufen 2026-10-19) ↩