 KI
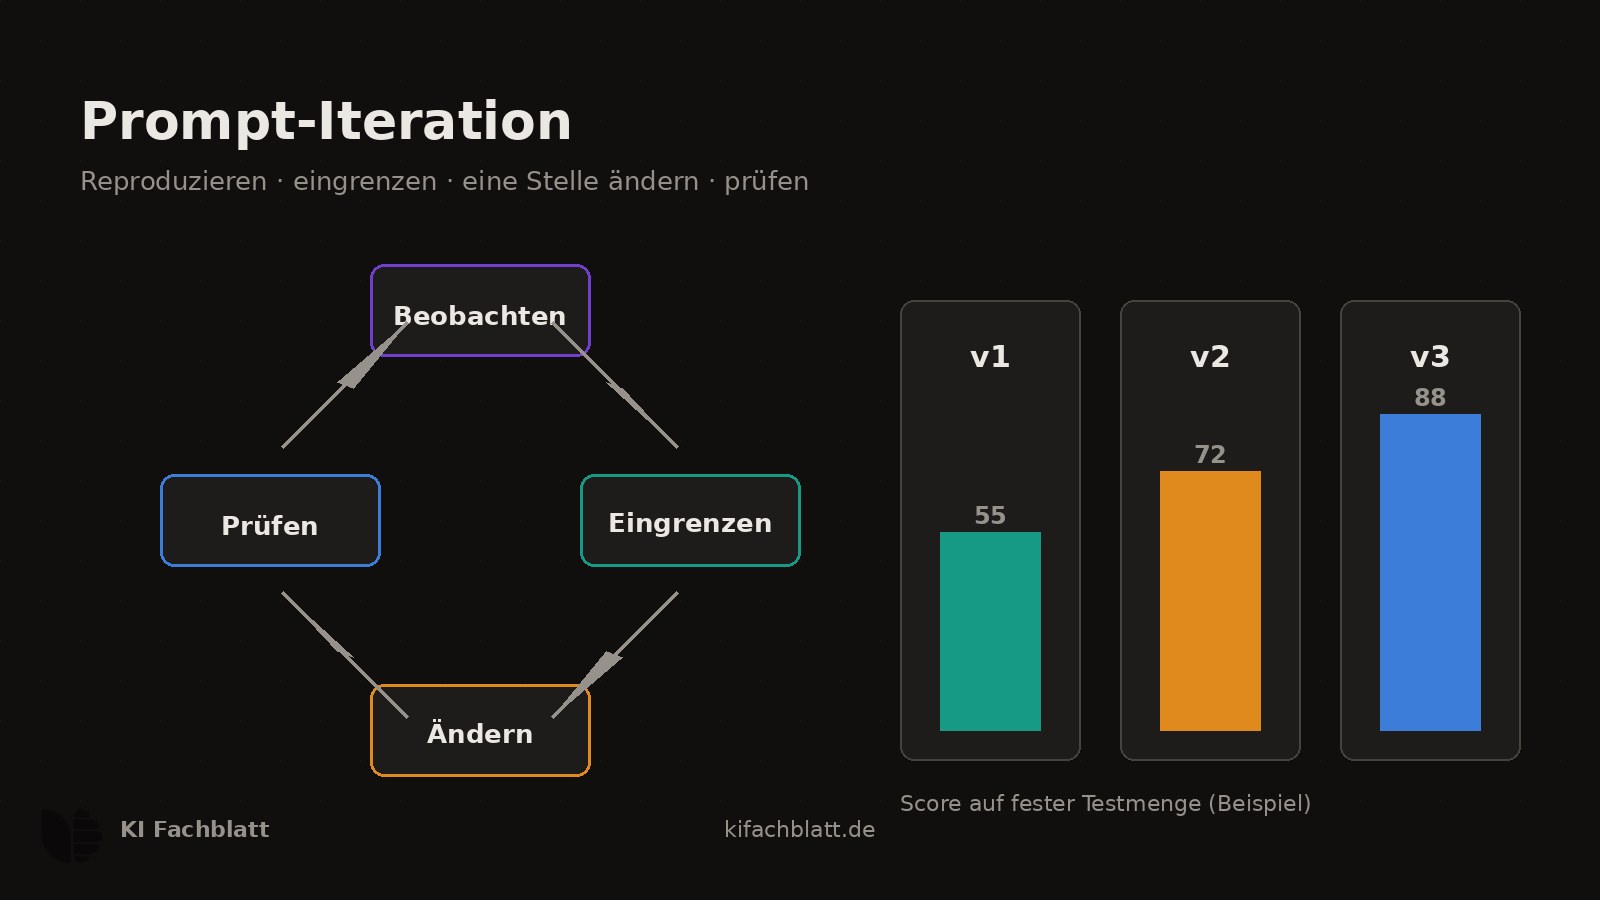
Jeder kennt die Situation: Der Prompt ist formuliert, die Antwort kommt, und sie ist falsch, ausweichend oder im falschen Format. Was viele dann tun, ist der natürliche, aber schlechteste Reflex: den ganzen Prompt umschreiben und hoffen. Damit verwirft man alles, was schon funktionierte, und lernt nichts über die eigentliche Ursache. Prompt-Engineering-Dokumentationen beider großer Anbieter empfehlen stattdessen seit Jahren dasselbe Vorgehen, das Programmierer vom Debuggen kennen: Fehler festhalten, Ursache eingrenzen, gezielt ändern, prüfen [1][2][4].
Schritt 1: Den Fehler festhalten, nicht das Gefühl
Schlecht ist keine Diagnose. Bevor irgendetwas geändert wird, wird der Fehler notiert: Eingabe, erhaltene Ausgabe, erwartete Ausgabe. Dieser Dreiklang ist die kleinste verwertbare Fehlerbeschreibung. Anthropic nennt im Evaluationsleitfaden genau das den Startpunkt: reale Eingaben sammeln, bei denen das System versagt hat, und sie als Testfälle konservieren [1]. Wer nur im Kopf festhält der Text war zu lang, verliert nach zwei Runden den Überblick, was schon versucht wurde.
Schritt 2: Die fünf Fehlerklassen
Fast jeder Promptfehler fällt in eine von fünf Klassen. Die Einordnung bestimmt die Reparatur, deshalb lohnt die ehrliche Zuordnung vor jeder Änderung:
| Fehlerklasse | Woran man es erkennt | Passende Reparatur |
|---|---|---|
| Unklare Anweisung | Das Modell beantwortet eine andere Frage als gemeint | Aufgabe in einen Satz mit Verb, Objekt und Erfolgskriterium fassen |
| Fehlender Kontext | Antwort ist allgemein richtig, aber nutzlos für den konkreten Fall | Fakten, Zielgruppe und Rahmen nachliefern; nicht raten lassen |
| Formatbruch | Inhalt stimmt, Struktur nicht (Länge, Aufbau, Schema) | Format explizit vorgeben oder ein Few-Shot-Beispiel zeigen |
| Erfundener Inhalt | Quellen, Zahlen oder Namen, die es nicht gibt | Kontext liefern, Unsicherheit erlauben, Quellenpflicht formulieren; siehe Halluzinationen |
| Überladung | Ein Teil der Anforderungen wird ignoriert | Aufgabe teilen oder Anforderungen priorisieren und nummerieren |
Die Klassen schließen einander aus, und das ist der Punkt: Wer eine Formatbruch mit mehr Kontext repariert, macht den Prompt länger und den Fehler nicht besser. Die Erfahrung aus der Praxis deckt sich mit den Evaluationsleitfäden: Erst wenn der Fehlertyp benannt ist, ist die Reparatur meist eine Sache von Minuten [1][3].
Schritt 3: Eine Stelle pro Runde ändern
Die wichtigste Disziplinregel lautet: Pro Iteration genau eine Änderung. Wer Anweisung, Beispiele und Tonalität gleichzeitig umbaut und danach eine bessere Antwort bekommt, weiß nicht, welcher Eingriff wirkte, und ob einer der anderen den Effekt teilweise wieder zunichtegemacht hat. OpenAIs Evaluationsanleitung verlangt für Prompt-Änderungen dasselbe wie für jeden Eingriff ins System: an einer festen Testmenge messen, nicht am Einzeleindruck [2]. Dazu gehört auch ein einfaches Versionsprotokoll: v1, v2, v3 mit Datum, geänderter Stelle und Ergebnis. Drei Zeilen Text pro Version genügen; der Artikel Prompt-Bibliothek zeigt, wie man daraus einen dauerhaften Bestand aufbaut.
Schritt 4: Mit einer kleinen Testmenge prüfen
Eine einzelne gute Antwort beweist nichts, weil Sprachmodelle von Lauf zu Lauf variieren. Der Ausweg ist eine kleine, feste Testmenge: 15 bis 30 echte Fälle, darunter die typischen und die bisher gescheiterten. Anthropic empfiehlt, mit einer überschaubaren Menge realer Fälle zu starten und bei jeder Prompt- oder Modelländerung erneut zu messen [1]. OpenAI beschreibt denselben Aufbau: feste Eingaben, definierte Bewertungskriterien, Vergleich vor und nach der Änderung [2]. Wie man so eine Testmenge in einer Stunde baut und auswertet, steht ausführlich in Evals statt Bauchgefühl. Wer keine automatische Auswertung aufsetzen will, prüft die Fälle von Hand; entscheidend ist nur, dass die Fälle und die Bewertung gleich bleiben.
Wenn Reparieren nicht trägt: die drei Abbiegungen
Manche Prompts lassen sich nicht retten, und es ist Stärke, das früh zu erkennen. Drei Abbiegungen sind dokumentiert und in der Praxis tragfähig: Erstens die Aufgabe teilen: Ein Prompt, der recherchiert, zusammenfasst und formatiert, wird zu drei Aufrufen mit Zwischenergebnissen; Anthropic beschreibt diese Zerlegung als Standardmuster für komplexe Aufgaben [1]. Zweitens Kontext beschaffen statt formulieren: Wenn das Modell Fakten erfindet, fehlt selten ein Satz im Prompt, sondern das Dokument, aus dem die Antwort kommen soll. Drittens das Modell wechseln: Für manche Aufgaben ist ein anderes Modell schlicht besser geeignet, und die eigenen Testfälle liefern den fairen Vergleich, statt sich auf Marketingzahlen zu verlassen [2][3]. Was man nicht tun sollte: die Temperatur als Reparatur missverstehen. Sie ändert die Streuung der Antworten, nicht deren Wahrheitsgehalt und nicht ihre Struktur.
Methode
Gelesen wurden am 19. Oktober 2026 die Evaluations-Dokumentation von Anthropic (Test and Evaluate), der Evaluationsleitfaden von OpenAI, der Anthropic-Engineering-Artikel zu Evaluationsmethodik und das OpenAI Cookbook. Die fünf Fehlerklassen und der Ablauf sind eine redaktionelle Verdichtung dieser Quellen und gängiger Prompting-Praxis, kein wörtliches Schema aus einer einzelnen Quelle.
Grenzen
Die genannten Dokumente beschreiben Vorgehensweisen der Anbieter, keine unabhängig gemessene Wirksamkeit; kontrollierte Studien zur Frage, welche Prompt-Reparatur im Mittel am meisten bringt, gibt es kaum. Die Empfehlung 15 bis 30 Testfälle ist ein pragmatischer Richtwert für redaktionelle und geschäftliche Standardfälle, kein statistisch abgesicherter Schwellenwert. Modellverhalten ändert sich mit Versionen; ein gewarteter Prompt kann nach einem Modellupdate erneut geprüft werden müssen.
Quellen
- Test and evaluate: Overview, Anthropic Documentation (abgerufen 2026-10-19) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- Evals, OpenAI Platform Documentation (abgerufen 2026-10-19) ↩1 ↩2 ↩3 ↩4 ↩5
- Demystifying evals for AI agents, Anthropic Engineering Blog (abgerufen 2026-10-19) ↩1 ↩2
- OpenAI Cookbook, OpenAI (GitHub) (abgerufen 2026-10-19) ↩