 KI
KI-Features scheitern im Alltag selten daran, dass das Modell zu schwach ist. Sie scheitern daran, dass Nutzer ihnen entweder blind vertrauen oder nach den ersten Fehlern gar nicht mehr. Beides ist ein Gestaltungsproblem, kein Modellproblem. Dieser Beitrag fasst zusammen, was die Forschung zur Mensch-KI-Interaktion dazu sagt: die 18 Gestaltungsrichtlinien von Microsoft Research [1], Jakob Nielsens Einordnung des neuen Interaktionsparadigmas [2] und zwei Untersuchungen der Nielsen Norman Group dazu, wie Nutzer mit KI-Fehlern umgehen [3], [4].
Ein neues Paradigma, eine neue Last
Jakob Nielsen beschreibt generative KI als das erste neue Interaktionsparadigma seit rund sechzig Jahren: Nutzer geben nicht mehr Befehle, sondern formulieren ein gewünschtes Ergebnis, die „intent-based outcome specification“ [2]. Die Kontrolle darüber, wie das Ergebnis zustande kommt, wandert damit vom Nutzer zum System. Das entlastet beim Einstieg und belastet bei der Prüfung: Wer den Weg nicht kennt, kann das Ergebnis schwer beurteilen. Nielsen erwartet deshalb hybride Oberflächen, die KI-Ergebnisse mit klassischen, kontrollierbaren Bedienelementen verbinden [2].
Für die Produktgestaltung folgt daraus: Ein KI-Feature ist kein Formular mit Knopf, sondern eine Zusammenarbeit mit einem System, das auch bei gleicher Eingabe unterschiedlich antworten kann. Oberflächen müssen diese Unsicherheit transportieren, statt sie hinter einem sicheren Dauergrinsen zu verstecken.
Vertrauen kalibrieren statt maximieren
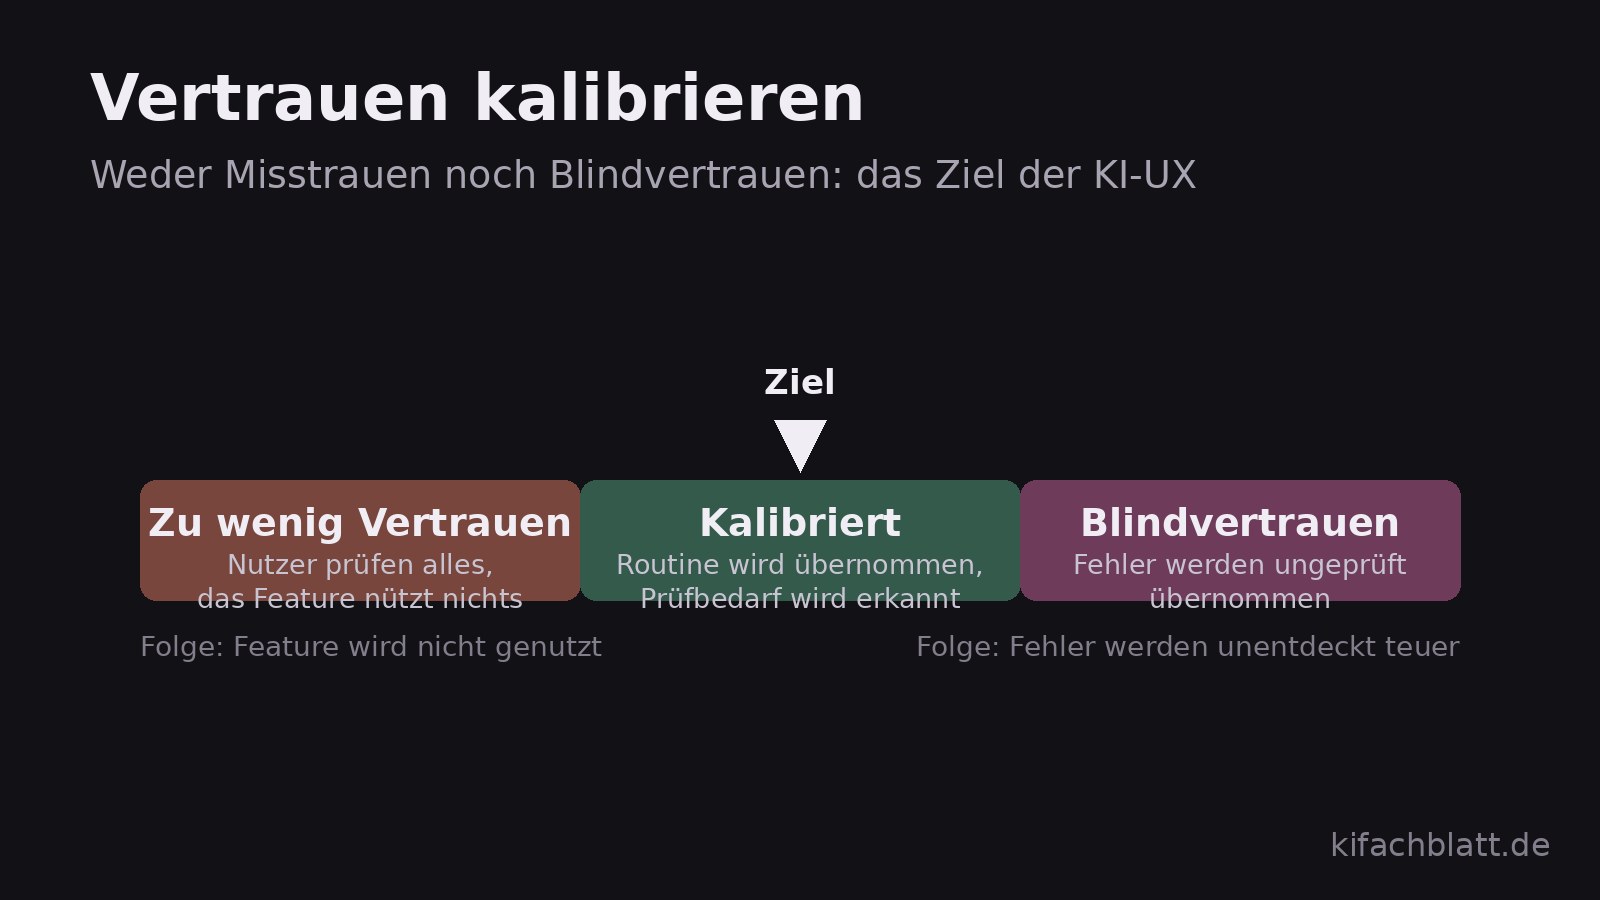
Die 18 Gestaltungsrichtlinien für Mensch-KI-Interaktion von Microsoft Research, aus über zwei Jahrzehnten Forschung destilliert und mit 49 Designern an 20 Produkten geprüft, verlangen unter anderem: Mach klar, was das System kann und was nicht; zeige Unsicherheit, wenn sie besteht; ermögliche effizientes Korrigieren und Verwerfen [1]. Dahinter steht ein Ziel, das Marketingsprech oft verfehlt: nicht maximales, sondern kalibriertes Vertrauen. Zu viel Vertrauen führt zu ungeprüften Fehlern, zu wenig zur Abwanderung, beides mit denselben Nutzern nacheinander.
Die Hürde liegt auf Nutzerseite, und sie ist teuer. Pavel Samsonov zeigt, dass KI-Ausgaben durch sicheren Tonfall, saubere Grammatik und Formatierung autoritär wirken; der Halo-Effekt überträgt den guten Eindruck auf die Richtigkeit [3]. Eine Antwort wirklich zu prüfen heißt: ganz lesen, prüfpflichtige Behauptungen erkennen, Quellen aufsuchen und bewerten, Schlussfolgerungen nachvollziehen, Korrekturen formulieren und das Ergebnis erneut prüfen, ohne Garantie, dass der neue Versuch besser ist [3]. Samsonovs Fazit ist deutlich: Es ist unverantwortlich, Nutzer für von KI erzeugte Falschinformation verantwortlich zu machen. Wenn Prüfung zu teuer ist, muss das Produkt sie billiger machen [3].
Fehlerfälle als Normalfall entwerfen
Halluzinationen sind kein Bug, der demnächst verschwindet, sondern ein Artefakt der Funktionsweise: Das Modell ergänzt statistisch plausible Fortsetzungen und kann dabei Fakten nicht von Erfindungen unterscheiden [4]. Die Größenordnung ist real. In einer von Page Laubheimer zitierten Untersuchung des Columbia Journalism Review ordnete ChatGPT 76 Prozent von 200 Zitaten aus Nachrichtenseiten falsch zu, und nur in 7 von 153 Fehlerfällen wies es auf eigene Unsicherheit hin [4]. Das RegLab der Stanford University fand bei spezialisierten juristischen KI-Werkzeugen falsche Angaben in mindestens jeder sechsten Benchmark-Anfrage, ebenfalls bei [4] referiert.
Daten als Tabelle
| Anteil | Anteil |
|---|---|
| Zitate falsch zugeordnet | 76 % |
| Fehler mit Unsicherheitshinweis | 5 % |
Quelle: Columbia Journalism Review, zitiert bei [4]
Ergebnis der bei [4] referierten CJR-Untersuchung: 76 % von 200 Zitaten falsch zugeordnet; nur 7 von 153 Fehlerfällen trugen einen Unsicherheitshinweis (hier gerundet 5 %).
Konsequenz für den Entwurf: Behandeln Sie Fehlerklassen wie erste Bürger des Produkts. Vier kommen in fast jedem KI-Feature vor, und jede braucht ihre eigene Antwort in der Oberfläche.
| Fehlerklasse | Beispiel | UX-Antwort |
|---|---|---|
| Inhaltlich falsch | Erfundene Quelle, falsche Zahl | Quellen und Zwischenschritte zeigen, Melden-Knopf, Korrekturpfad |
| Unsicher | Modell rät bei seltenem Fall | Unsicherheit aussprechen, Alternativen oder Nachfrage anbieten |
| Verweigert oder abgebrochen | Richtlinie greift, Kontext zu lang | Grund nennen und nächsten sinnvollen Schritt vorschlagen |
| Nicht verfügbar | Dienst überlastet, Zeitüberschreitung | Ehrlicher Status, gespeicherter Stand, Fallback-Angebot |
Fallbacks: der Plan für den schlechten Tag
Ein Fallback ist die geordnete Degradation, wenn die beste Stufe nicht trägt. Für KI-Features hat sich eine Stufenfolge bewährt: Erst die Anfrage enger fassen oder mit mehr Kontext wiederholen, dann auf eine einfachere, deterministische Antwort zurückfallen (Suchergebnisliste statt generierter Antwort, Formular statt Freitext), und bei hohen Einsätzen einen Human-in-the-Loop vorsehen, der vorbereitete Fälle freigibt. Die Microsoft-Richtlinien fassen das als effizientes Korrigieren, Verwerfen und Wiederherstellen zusammen [1]. Wichtig ist, dass jede Stufe ehrlich beschriftet ist: „Dafür reicht mein Wissen nicht, hier ist die Suchliste“ erhält Vertrauen; eine dünnere Antwort im selben selbstsicheren Ton zerstört es. Welche Schutzschichten auf Technikseite dazu gehören, beschreibt Guardrails im Glossar und der Beitrag Sicherheit für Agenten-Systeme.
Erwartungsmanagement: Onboarding ohne Übertreibung
Die ersten Minuten legen das mentale Modell fest, mit dem Nutzer jedes spätere Ergebnis bewerten. Die Richtlinien verlangen, Fähigkeiten und Grenzen zu Beginn und im Verlauf sichtbar zu machen [1]. Praktisch heißt das: Starten Sie mit echten Beispielaufgaben statt mit „Frag mich alles“, benennen Sie, wo das System stark und wo es schwach ist, und zeigen Sie bei längeren Arbeiten den Bearbeitungsstand, damit Warten nicht wie Hängenbleiben aussieht. Pauschale Fußnoten wie „KI kann Fehler machen“ reichen nach dem Befund von [3] und [4] nicht: Sie verschieben die Prüflast auf die Nutzer, statt das Produkt zu ändern. Wirksamer sind Prüfhilfen direkt am Ergebnis, etwa verlinkte Belege je Aussage und ein sichtbarer Konfidenz- oder Quellenhinweis dort, wo er gebraucht wird. Auch die Gefahr der Schmeichelei ist real: Sycophancy beschreibt, warum Modelle eher zustimmen als widersprechen, und gehört in dieselbe Designprüfung.
Checkliste für die Praxis
- Kann ein neuer Nutzer nach dem Onboarding benennen, was das Feature kann und was nicht?
- Zeigt jede inhaltliche Antwort, worauf sie sich stützt, oder ist sie bewusst als Entwurf markiert?
- Gibt es für jede der vier Fehlerklassen eine beschriftete, geübte Oberfläche?
- Ist der Fallback-Pfad einmal durchgespielt worden, inklusive komplettem Modellausfall?
- Werden Korrekturen der Nutzer erfasst und fließen in Testmenge und Produkt zurück?
- Verspricht irgendein Text, eine Demo oder ein Ladezustand mehr, als die Messung hergibt?
KI-UX ist am Ende ein Versprechen-Management: Das Produkt verspricht, was die Messung hergibt, zeigt, woran das festgemacht ist, und bleibt an den schlechten Tagen ehrlich. Features, die so gebaut sind, verlieren nach Fehlern weniger Vertrauen, weil sie nie welches verschenkt haben.
Methode
Gelesen wurden am 20. Oktober 2026 die vier genannten Quellen: die Beschreibung der 18 Gestaltungsrichtlinien bei Microsoft Research [1], Nielsens Paradigma-Aufsatz [2] und die beiden Fachartikel der Nielsen Norman Group zu Fehlerprüfung [3] und Halluzinationen [4]. Die Zahlen des Columbia Journalism Review und des Stanford RegLab sind Sekundärzitate aus [4] und wurden nicht an der Originalstudie gegengeprüft; sie sind im Text als solche gekennzeichnet.
Grenzen
Die zitierten Studien untersuchen Chat-Oberflächen und bestimmte Modellgenerationen; Fehlerraten ändern sich mit Modellen und Werkzeugen. Die Fehlerklassen-Tabelle ist eine redaktionelle Einordnung, keine Norm. Der Beitrag ersetzt keine Nutzerforschung im eigenen Produkt.
Quellen
- Guidelines for Human-AI Interaction, Amershi u. a., CHI 2019 (Microsoft Research) (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- AI: First New UI Paradigm in 60 Years, Jakob Nielsen, Nielsen Norman Group, 18. Juni 2023 (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4
- AI Chatbots Discourage Error Checking, Pavel Samsonov, Nielsen Norman Group, 16. Mai 2025 (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- AI Hallucinations: What Designers Need to Know, Page Laubheimer, Nielsen Norman Group, 7. Februar 2025 (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6