 KI
Seit Anfang 2025 bieten die großen KI-Anbieter einen Modus an, der mehr tut als eine Chat-Antwort: Deep Research. Sie stellen eine Frage, das System legt eigenständig einen Rechercheplan an, führt Dutzende Suchanfragen aus, liest hunderte Seiten und liefert nach einigen Minuten einen Bericht mit Zitaten. Für Redaktionen klingt das nach einem Volontär, der über Nacht das Themenfeld kartiert. Dieser Text ordnet ein, was die Werkzeuge von OpenAI, Google, Perplexity und Anthropic tatsächlich leisten, was die Benchmarks bedeuten und welche Prüfpflichten bleiben.
Was Deep Research von der Chat-Antwort unterscheidet
Ein normaler Chatbot antwortet aus dem Modellgedächtnis in einem Zug. Deep Research arbeitet dagegen agentisch: Das System zerlegt die Frage, sucht mehrfach, bewertet Zwischenergebnisse und passt den Plan an, bevor es den Bericht schreibt. OpenAI beschreibt seinen Modus als eigenen Agenten, der „hunderte Online-Quellen findet, analysiert und zusammenführt“ und dafür je nach Aufgabe 5 bis 30 Minuten braucht [1]. Perplexity nennt Dutzende Suchen und hunderte gelesene Quellen bei einer Laufzeit von 2 bis 4 Minuten [3]. Anthropic beschreibt den Research-Modus von Claude als aufeinander aufbauende Suchen mit Zitaten zum Gegenprüfen [4].
Zwei Folgen für die Praxis: Erstens kostet eine Anfrage Minuten statt Sekunden und ist meist kontingentiert. Zweitens ist das Ergebnis kein Gespräch, sondern ein Dokument mit Quellenverzeichnis; der Wert liegt in der Quellenkarte, nicht im Fließtext.
Der Ablauf ist bei allen vier ähnlich: Sie formulieren den Auftrag im Chat, gegebenenfalls mit Dateianhang oder Quellenauswahl, das System zeigt einen Rechercheplan oder beginnt direkt, und nach einigen Minuten liegt ein Bericht vor. Bei Gemini lässt sich der Rechercheplan vor dem Start ansehen und anpassen; Quellen wie Gmail, Drive oder NotebookLM-Notizbücher können gezielt zu- oder abgewählt werden [2]. Bei Perplexity lässt sich der fertige Bericht als PDF exportieren oder als geteilte Seite weitergeben [3].
Die vier Angebote im Überblick
| Anbieter | Laufzeit (Herstellerangabe) | Besonderheit | Zitate |
|---|---|---|---|
| OpenAI: Deep Research in ChatGPT | 5-30 Minuten | eigenes Agentenmodell auf o3-Basis; Bericht mit Quellenverzeichnis | ja, mit Quellenverzeichnis |
| Google: Deep Research in Gemini | Minutenbereich | Quellen wählbar: Google Suche, Gmail, Drive, NotebookLM; Tageslimits je nach Tarif | ja |
| Perplexity: Deep Research | 2-4 Minuten | kostenlos nutzbar (begrenzt), Pro mit höherem Kontingent; Export als PDF | ja |
| Anthropic: Research in Claude | Minutenbereich | durchsucht Web und optional Google Workspace (Mail, Kalender, Docs) | ja, inline |
Die Unterschiede liegen weniger im Prinzip als im Datenraum: Google und Anthropic binden auf Wunsch eigene Inhalte ein (E-Mails, Dokumente, Kalender), was für Auswertung des eigenen Materials nützlich ist, aber Datenschutzfragen aufwirft. OpenAI und Perplexity konzentrieren ihre Darstellung auf die öffentliche Websuche. Preise und Kontingente ändern sich laufend; die Anbieterseiten geben den jeweils aktuellen Stand an [1][2][3][4].
Was die Benchmarks aussagen und was nicht
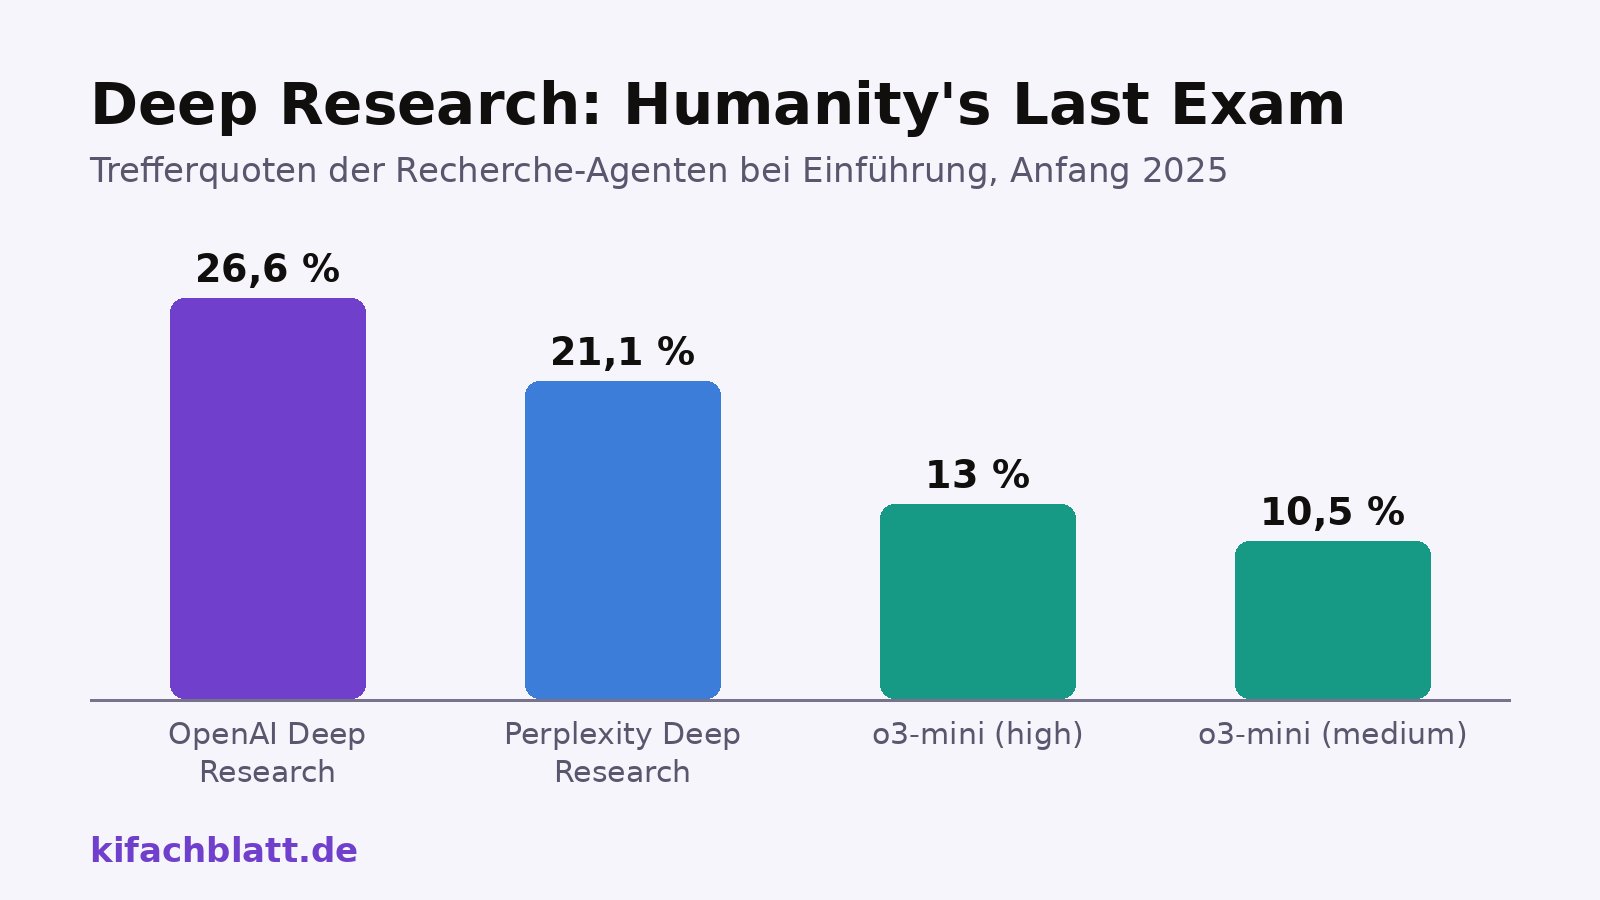
Zwei Prüfstande tauchen in den Produktankündigungen immer wieder auf. GAIA ist ein Benchmark für Assistenten mit 466 praxisnahen Fragen, die Recherche, Werkzeugnutzung und mehrstufiges Schlussfolgern verlangen; Menschen lösten in der Veröffentlichung 92 Prozent, GPT-4 mit Plugins nur 15 Prozent [5]. Humanity's Last Exam (HLE) ist eine Sammlung von über 3.000 Expertenfragen aus mehr als 100 Fachgebieten [1][3].
Daten als Tabelle
| System | Trefferquote |
|---|---|
| OpenAI Deep Research | 26,6 % |
| Perplexity Deep Research | 21,1 % |
| o3-mini (high) | 13 % |
| o3-mini (medium) | 10,5 % |
Quelle: Eigene Darstellung nach [1][3]
Trefferquoten auf HLE laut den Einführungsbeiträgen von OpenAI und Perplexity Anfang 2025; aktuelle Modellversionen können abweichen. Eigene Darstellung nach [1][3].
Zur Einordnung: 26,6 Prozent auf einer Prüfung, die Expertinnen und Experten an ihre Grenzen bringt, ist ein starker Wert für ein Recherche-System und zugleich weit von Zuverlässigkeit entfernt. Die Werte stammen aus den Ankündigungen der Anbieter, sind nicht unabhängig nachgemessen und beziehen sich auf die Modelle von Anfang 2025. Benchmark-Spitzenplätze wechseln schnell; unser Porträt von Humanity's Last Exam und die Seite Modelle und Agenten richtig evaluieren zeigen, wie man solche Angaben liest.
Wann sich der Einsatz lohnt und wann nicht
Stark sind die Agenten überall dort, wo die Antwort im offenen Web verteilt liegt: Überblick über ein neues Themenfeld, Markt- und Wettbewerbslage, Technikvergleiche, das Sammeln von Studien und Behördendokumenten zu einer Frage. Schwach sind sie bei allem, was hinter Paywalls, in Fachdatenbanken, in Akten oder in Köpfen liegt, und bei sehr neuen Entwicklungen der letzten Stunden. Für die klassische journalistische Kernarbeit, also Gespräche, Dokumente und Exklusives, bleiben sie ein Vorarbeit-Werkzeug.
Die Grenzen: Was die Anbieter selbst einräumen
- Halluzinationen bleiben. OpenAI schreibt, das System könne Fakten erfinden oder falsche Schlüsse ziehen, wenn auch seltener als bisherige Modelle, und habe Schwächen, Unsicherheit korrekt anzuzeigen [1].
- Autorität wird nicht erkannt. Die Systeme unterscheiden schlecht zwischen belastbarer Quelle und Gerücht; OpenAI nennt das ausdrücklich als bekannte Schwäche [1].
- Quellenarbeit fehleranfällig. In den unabhängigen Tests des Tow Center zitierten KI-Suchwerkzeuge häufig falsche Originale oder erfanden Links; Details in unserem Artikel Faktencheck mit KI.
- Aktualität und Sperren. Bezahlschranken, gesperrte Crawler und sehr neue Ereignisse bleiben Lücken; ein Bericht kann überzeugend aussehen und trotzdem die entscheidende Primärquelle vermissen lassen.
- Vertraulichkeit. Was Sie in den Auftrag schreiben (Interna, Informantenhinweise), verlässt Ihr Haus. Für vertrauliche Recherchen sind diese Dienste tabu, wie es auch die AP-Standards für ihre Journalisten festlegen.
Ein Arbeitsablauf für die Redaktion
- Auftrag präzisieren. Frage, Zeitraum, Region und gewünschte Quellentypen (Primärquellen, Studien, Behörden) in den Auftrag schreiben; vage Aufträge liefern glatte Allgemeinplätze.
- Bericht als Landkarte lesen. Struktur und Stichwortliste übernehmen, Fließtext ignorieren. Der Wert ist das Inhaltsverzeichnis des Themas.
- Zitate stichprobenartig öffnen. Jede Aussage, die in den Artikel soll, am Original prüfen: Existiert die Quelle, sagt sie das Behauptete, ist sie aktuell? Grundregeln im Artikel Faktencheck mit KI.
- Lücken notieren. Was der Agent nicht gefunden hat (Paywalls, Fachdatenbanken, Graupapier), gezielt selbst recherchieren.
- Einsatz dokumentieren. Wenn KI-Recherche in einen Beitrag eingeflossen ist, gehört das in die Transparenz-Angabe des Mediums; wie das aussehen kann, zeigt unsere Seite KI in der Redaktion deklarieren.
Wer die technische Grundlage verstehen will, findet sie im Glossar unter Agent, Grounding und Chain of Thought. Für die wissenschaftliche Variante der Themenlage verweisen wir auf den Lernpfad-Artikel Literaturrecherche mit KI.
Methode
Gelesen wurden am 20. Oktober 2026 die Einführungsbeiträge und Hilfeseiten von OpenAI (deep research), Google (Deep Research in Gemini), Perplexity (Deep Research) und Anthropic (Research) sowie das GAIA-Paper auf arXiv. Laufzeiten, Funktionsumfang und Benchmark-Werte sind Herstellerangaben aus diesen Quellen; sie wurden nicht unabhängig nachgemessen. Der Text entstand mit KI-Unterstützung und wurde von der Redaktion verantwortet.
Grenzen
Funktionsumfang, Preise, Kontingente und Modellversionen der vier Angebote ändern sich laufend; die Angaben sind der Stand der Produktseiten vom 20. Oktober 2026. Benchmark-Werte stammen aus Anbieter-Kommunikation und beziehen sich auf Modelle von Anfang 2025. Ein eigener Vergleichstest der Systeme wurde für diesen Artikel nicht durchgeführt.
Quellen
- Introducing deep research, OpenAI (2025) (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- Use Deep Research in Gemini Apps, Google Gemini Apps Help (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4
- Introducing Perplexity Deep Research, Perplexity (2025) (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- Claude takes research to new places, Anthropic (2025) (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4
- GAIA: a benchmark for General AI Assistants, arXiv:2311.12983 (Mialon u. a., 2023) (abgerufen 2026-10-20) ↩1 ↩2