 KI
Die klassische Literaturrecherche beginnt in einer Datenbank mit einem Stichwort und endet mit vierzig offenen Tabs. KI-Recherchewerkzeuge versprechen, diesen Weg abzukürzen: Frage in ganzen Sätzen stellen, Antwort mit Quellenangaben bekommen. Das funktioniert inzwischen gut genug, um Stunden zu sparen. Es funktioniert aber nur, wenn man versteht, welche Werkzeuge wirklich in der Literatur suchen und welche sie bloß simulieren.
Zwei Werkzeugtypen, ein wichtiger Unterschied
Der erste Typ sind Literaturdatenbanken mit KI-Schicht: Sie suchen in einem echten, gepflegten Korpus aus Verlagsdaten, Crawls und Partnerschaften und setzen die KI zum Finden, Einordnen und Zusammenfassen ein. Der zweite Typ sind allgemeine Chat-Assistenten, die aus ihrem Trainingswissen antworten. Nur der erste Typ liefert überprüfbare Treffer; der zweite liefert plausible Beschreibungen von Treffern. Der Unterschied entscheidet, ob eine Recherche belastbar ist.
Die Datenbasis: wer wie viel abdeckt
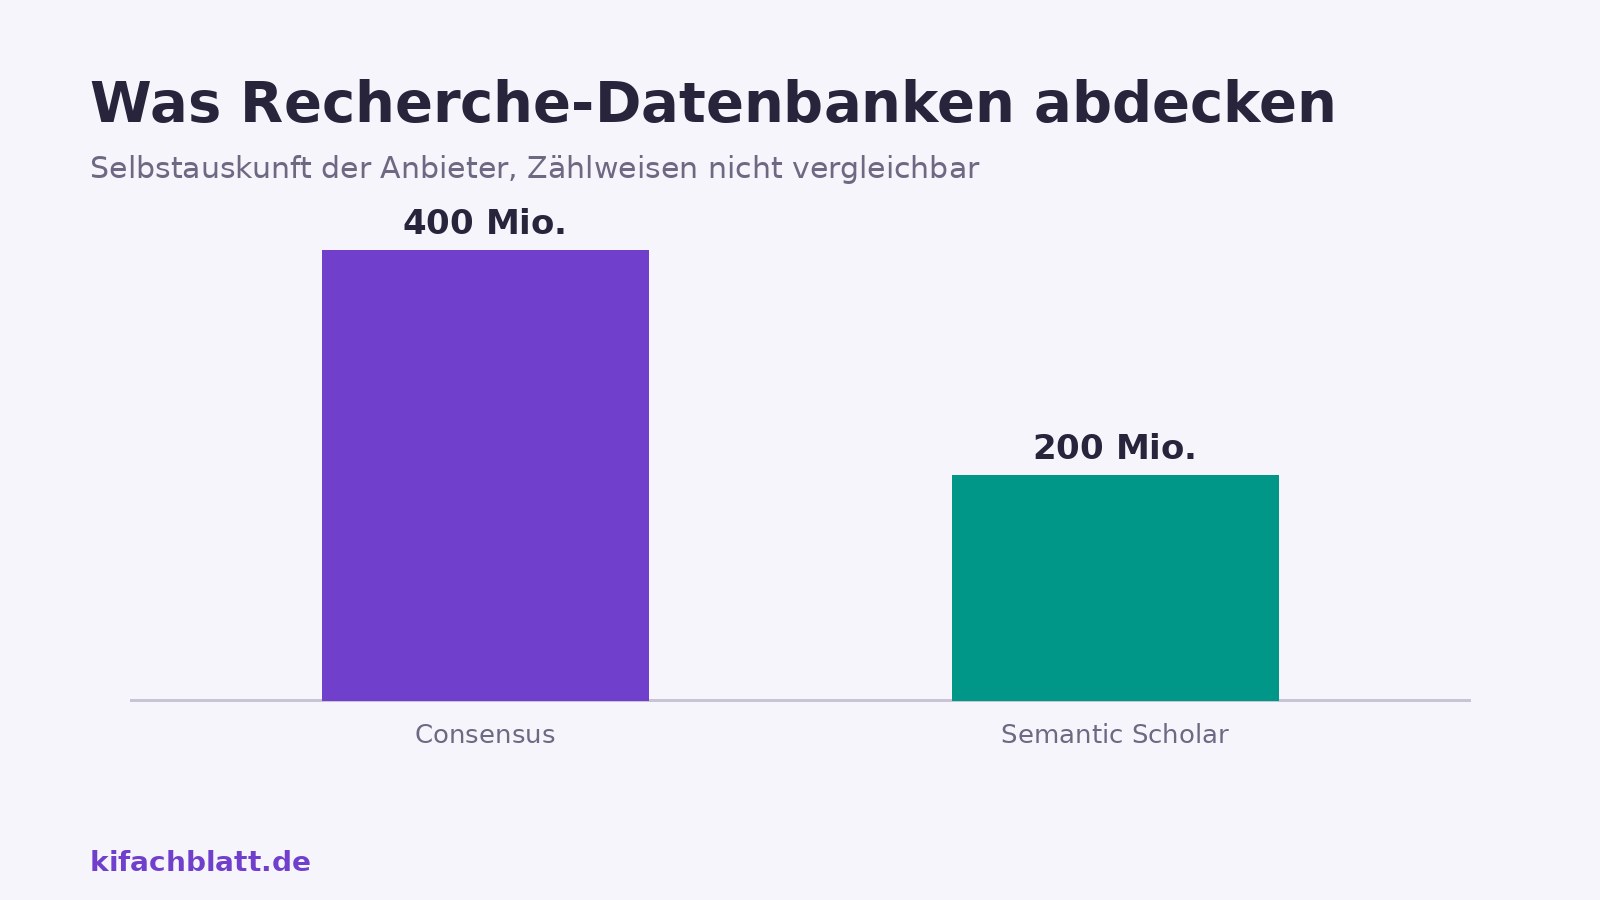
Semantic Scholar, ein Projekt des gemeinnützigen Allen Institute for AI, indexiert nach eigenen Angaben über 200 Millionen wissenschaftliche Papers aus Verlagskooperationen, Datenlieferanten und Web-Crawls und stellt Suche, APIs und Datensätze kostenlos bereit [1]. OpenAlex ist ein offener Katalog der weltweiten Forschung mit dokumentierter API und freiem Datenzugang, geeignet auch für eigene Auswertungen und systematische Reviews [2]. Scopus AI von Elsevier arbeitet auf dem kuratierten, peer-reviewten Bestand von Scopus und erzeugt zu einer Frage Themenzusammenfassungen mit Referenzen; jede Antwort nennt die genutzten Quellen samt Relevanz-Konfidenz, und bei dünner Evidenzlage soll das System das ausdrücklich sagen und Alternativfragen vorschlagen [3].
Auf dieser Basis setzen KI-Aufsätze wie Consensus und Elicit. Consensus bewirbt eine Suche über mehr als 400 Millionen wissenschaftliche Papers, mit Zusammenfassungen, einem „Consensus Meter“ für Ja- und Nein-Fragen und Studien-Steckbriefen [4]. Elicit kombiniert Literatursuche mit strukturierter Datenextraktion aus Papers und gibt für diesen Schritt eine eigene Validierung an: 99,4 Prozent Extraktionsgenauigkeit in der hauseigenen Prüfung [5]. Solche Herstellerangaben sind Angaben der Anbieter, keine unabhängigen Messungen, aber sie zeigen die Richtung: Die Werkzeuge konkurrieren über Nachprüfbarkeit.
Für den Zugang gilt eine grobe Dreiteilung: Semantic Scholar und OpenAlex sind dauerhaft kostenlos und offen [1][2], Consensus und Elicit arbeiten mit kostenlosen Kontingenten und Bezahlstufen [4][5], Scopus AI läuft über institutionelle Lizenzen, also typischerweise über die Hochschulbibliothek [3]. Für Studierende und Forschende heißt das: Ein Großteil der beschriebenen Arbeitsschritte ist ohne Budget möglich; die Frage, welche Datenbanken die eigene Einrichtung lizenziert hat, beantwortet die Bibliothek.
Ein Beispiel zeigt, wie weit die Angebote inzwischen gehen: Scopus AI baut zu einer Frage nicht nur eine belegte Zusammenfassung, sondern schlägt Vertiefungsfragen vor, listet grundlegende Arbeiten des Feldes, erzeugt Konzeptlandkarten aus den Abstracts und bietet einen Deep-Research-Modus, der eigenständig einen Rechercheplan erstellt und als Bericht ausliefert [3]. Das ist nützlich für den Einstieg in ein fremdes Gebiet. Es ersetzt aber nicht die Bewertung der einzelnen Studie, denn schon die Auswahl, was zusammengefasst wird, ist eine redaktionelle Entscheidung des Systems.
| Werkzeug | Datenbasis | Zugang | Stärke |
|---|---|---|---|
| Semantic Scholar | Über 200 Mio. Papers | Kostenlos | Offene Suche, APIs und Datensätze |
| OpenAlex | Offener Forschungskatalog | Kostenlos | Dokumentierte API für eigene Auswertungen |
| Scopus AI | Kuratierter Peer-Review-Bestand | Institutionslizenz | Belegte Zusammenfassungen mit Relevanz-Konfidenz |
| Consensus | Über 400 Mio. Papers (Anbieterangabe) | Freemium | Consensus Meter, Studien-Steckbriefe |
| Elicit | Literaturdatenbank plus Extraktion | Freemium | Strukturierte Datenextraktion aus Papers |
Die Blindgänger: erfundene Literatur und unsichtbare Lücken
Das größte Risiko bleibt die erfundene Referenz. Walters und Wilder ließen GPT-3.5 und GPT-4 kurze Literaturübersichten erstellen und prüften alle 636 genannten Quellen: Bei GPT-3.5 waren 55 Prozent komplett erfunden, bei GPT-4 immerhin 18 Prozent [6]. Die Titel klingen echt, die Journalnamen existieren, oft stimmen sogar die Autorennamen annähernd. Genau deshalb ist die Gefahr in der Literaturrecherche größer als in jeder anderen KI-Anwendung: Eine erfundene Quelle im Literaturverzeichnis ist schlimmer als keine Quelle.
Der zweite Blindgänger ist subtiler: Auch echte Treffer können falsch gewichtet sein. Datenbanken decken Verlagsliteratur gut ab, graue Literatur, Preprints ohne Indexierung, deutschsprachige Fachartikel und sehr neue Beiträge schlechter. Wer nur über eine KI-Oberfläche sucht, sieht die Lücken des Korpus nicht. Und schließlich das Aktualitätsproblem: Eine zurückgezogene Studie bleibt in vielen Systemen als normaler Treffer sichtbar. Die Retraction-Watch-Datenbank, seit 2023 im Besitz von Crossref und komplett offen, erlaubt den Gegencheck, ob eine Arbeit zurückgezogen wurde [7].
Ein Workflow, der trägt
- Breit starten, spezialisiert vertiefen. Erste Orientierung über eine KI-Oberfläche wie Consensus oder Scopus AI; die Begriffe und Kernarbeiten dort einsammeln, nicht die Formulierungen.
- Jede Quelle einzeln verifizieren. Titel und DOI aufrufen, Abstract lesen. Erst wenn die Quelle existiert und das Behauptete sagt, kommt sie in die eigene Sammlung. Zur Erinnerung: 18 bis 55 Prozent Erfundenes sind der Ausgangspunkt, nicht der Ausnahmefall [6].
- Retraction-Check machen. Für jede zentrale Quelle prüfen, ob sie zurückgezogen wurde, etwa über die offene Retraction-Watch-Datenbank [7].
- Korpuslücken bewusst schließen. Deutschsprachige und fachspezifische Datenbanken, Bibliothekskataloge und die Referenzlisten der Kernpapers von Hand ergänzen.
- Recherche dokumentieren. Suchbegriffe, Datenbanken, Datum und Auswahlkriterien festhalten, damit die Recherche nachvollziehbar und wiederholbar bleibt.
Grenzen, die bleiben
- Zusammenfassungen verkürzen Studienlage. Eine KI-Antwort über „den Stand der Forschung“ gewichtet unsichtbar; welche Studien ein- und welche ausgeblendet wurden, ist nicht transparent.
- Herstellerangaben sind keine Audits. Werte wie die 99,4 Prozent von Elicit stammen aus der eigenen Validierung des Anbieters [5].
- Kostenlose Zugänge sind begrenzt. Umfang und Funktionen der freien Kontingente ändern sich laufend; Stand prüfen.
- Kein Ersatz fürs Lesen. Wer eine Quelle zitiert, muss sie gelesen haben, mindestens Abstract und die zitierte Stelle; die KI-Zusammenfassung zählt nicht als Lektüre.
Richtig eingesetzt, verändern diese Werkzeuge die Recherche: Die Erschließung eines Themas dauert Stunden statt Tage. Die Verantwortung für die Quellenlage bleibt beim Forschenden, und der Preis für die Geschwindigkeit ist Pflichtprogramm: verifizieren, gegenprüfen, dokumentieren. Wie man die gefundenen Quellen korrekt prüft und zitiert, zeigt der nächste Artikel; warum Sprachmodelle überhaupt Quellen erfinden, erklärt der Text über <a href="/halluzinationen">Halluzinationen</a> und das Glossar unter <a href="/glossar#halluzination">Halluzination</a> und <a href="/glossar#grounding">Grounding</a>.
Methode
Gelesen wurden am 20. Oktober 2026: die Anbieterseiten von Semantic Scholar, Consensus, Elicit und Scopus AI, das OpenAlex-Hilfezentrum, die Ankündigung von Retraction Watch zur Übernahme durch Crossref sowie die Zitationsstudie von Walters und Wilder in Scientific Reports. Abdeckungszahlen und Genauigkeitswerte sind Herstellerangaben und als solche gekennzeichnet; das Diagramm stellt die Selbstauskünfte zweier Anbieter gegenüber, ohne die Zählweisen gleichzusetzen. Der Text entstand mit KI-Unterstützung und wurde von der Redaktion verantwortet.
Grenzen
Abdeckung und Funktionen der Werkzeuge ändern sich laufend; alle Zahlen sind Selbstauskünfte der Anbieter mit Stand vom 20. Oktober 2026. Die Zitationsstudie stammt aus 2023 und bezieht sich auf GPT-3.5 und GPT-4; neuere Modelle können besser abschneiden, das Grundproblem bleibt. Fachspezifische Datenbanken (etwa PubMed, Juris, FIS) wurden nicht getestet.
Quellen
- About Semantic Scholar, Semantic Scholar (Allen Institute for AI) ↩1 ↩2 ↩3 ↩4
- OpenAlex Help Center, OpenAlex ↩1 ↩2 ↩3
- Scopus AI, Elsevier ↩1 ↩2 ↩3 ↩4 ↩5
- Consensus: KI-Suche über wissenschaftliche Literatur, Consensus ↩1 ↩2 ↩3 ↩4
- Elicit: AI for research, Elicit ↩1 ↩2 ↩3 ↩4
- Fabrication and errors in the bibliographic citations generated by ChatGPT (Walters & Wilder), Scientific Reports / Nature Portfolio (2023) ↩1 ↩2 ↩3
- The Retraction Watch Database becomes completely open (Übernahme durch Crossref), Retraction Watch (2023) ↩1 ↩2 ↩3