 KI
Eine CSV-Datei mit Umfragedaten, eine Abschlussarbeit im Zeitplan, keine Routine in Python: Das ist die Ausgangslage, in der KI-Assistenten ihre vielleicht überzeugendste Leistung zeigen. Datei hochladen, Auftrag in einem Satz beschreiben, und der Assistent erzeugt nicht nur eine Antwort, sondern den ausgeführten Analyse-Code samt Diagramm [1]. Der Weg von der Frage zur ersten Auswertung schrumpft auf Minuten. Die entscheidende Frage ist, wie viel davon hält.
Was die Assistenten tatsächlich tun
Technisch ist der Ablauf bei den verbreiteten Assistenten ähnlich: Sie laden eine Datei in den Chat, etwa eine Tabelle; das Modell schreibt daraufhin Python-Code, meist mit der Standardbibliothek pandas [5], führt ihn in einer abgeschotteten Umgebung aus und erläutert das Ergebnis. ChatGPT beschreibt genau diesen Ablauf für Dokumente, Tabellen, Präsentationen, Bilder und Audio, verfügbar je nach Dateityp und Tarif, mit tarifabhängigen Upload-Grenzen [1]. Derselbe Mechanismus steckt in Jupyter-Notebooks, der Arbeitsumgebung, in der viele Forschende ohnehin rechnen: Code, Ergebnis und Grafik stehen untereinander in einem dokumentierbaren Ablauf [3].
Am stärksten ist der Einsatz dort, wo die Richtung schon klar ist: Daten bereinigen und formen, Formate vereinheitlichen, eine erste Visualisierung der Verteilungen, ein schneller Blick auf Ausreißer. Diese Schritte sind Handwerk mit bekanntem Ziel, und genau dafür sind die Bibliotheken gebaut, die die Modelle am besten beherrschen [5]. Je mehr die Aufgabe dagegen inhaltliche Entscheidungen verlangt, etwa welche Gruppierung fachlich sinnvoll ist, desto mehr wird der Assistent zum Diskussionspartner statt zum Rechner.
Wie gut der Code wirklich ist
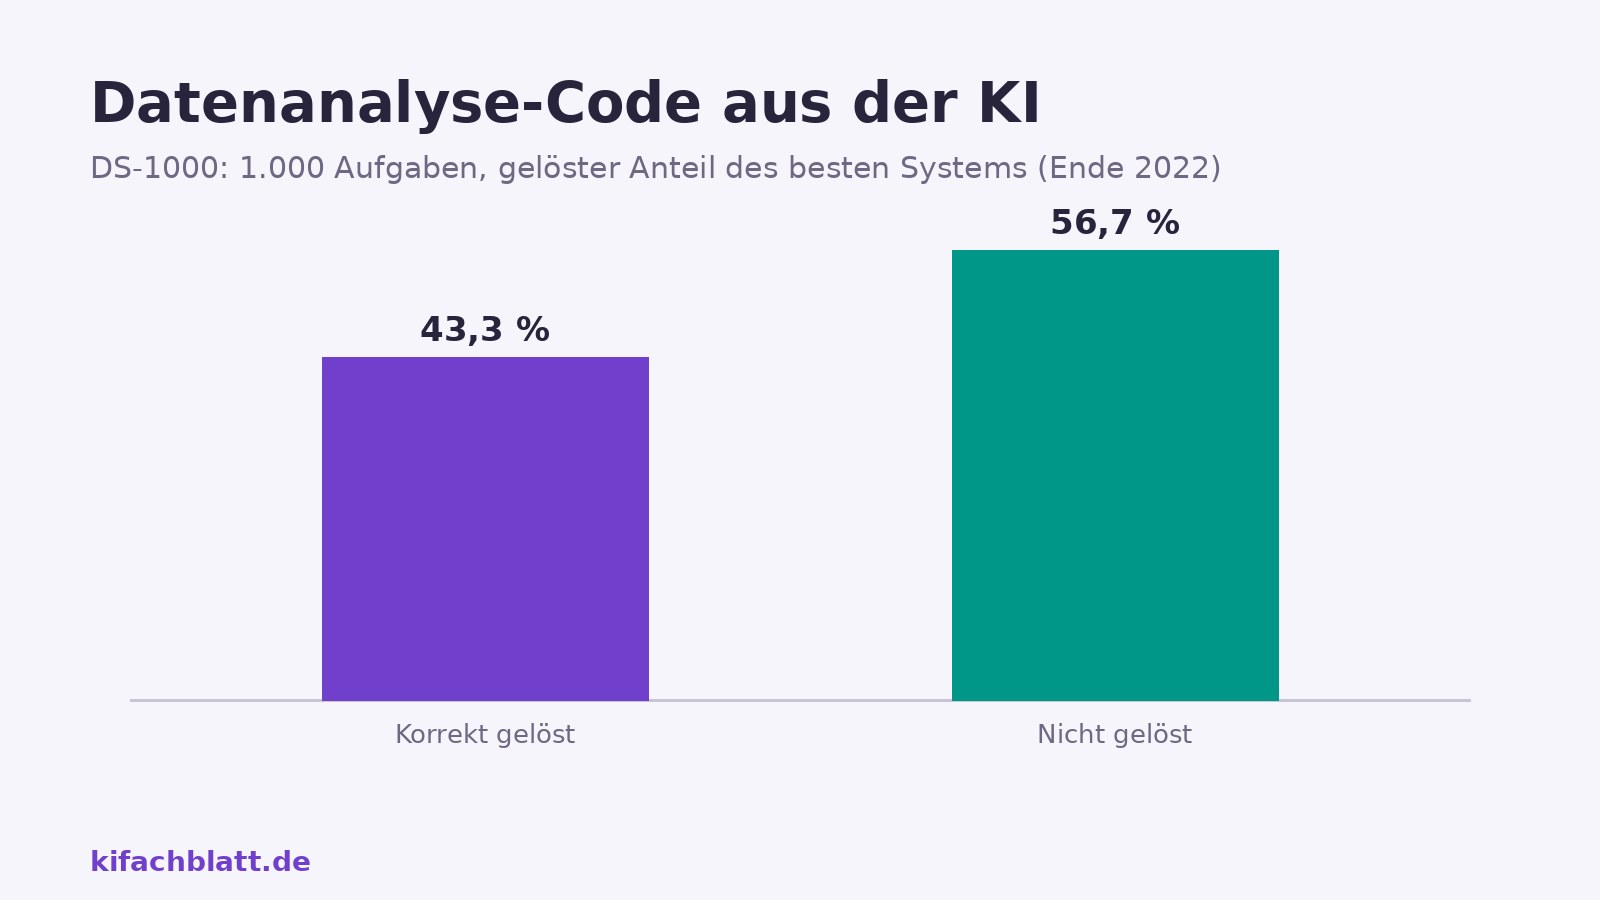
Zwei Details des Benchmarks machen die Zahl belastbar: Die Aufgaben stammen aus echten Nutzerfragen, wurden aber so abgewandelt, dass Auswendiglernen nicht hilft; und die automatische Bewertung akzeptierte nur 1,8 Prozent falsche Lösungen irrtümlich als korrekt [2]. Was dort als Fehler zählt, ist also kein Schönheitskriterium, sondern nachweislich falsches Verhalten des Codes.
Ein ehrliches Qualitätsmaß liefert der Benchmark DS-1000: tausend Datenwissenschafts-Aufgaben über sieben Python-Bibliotheken wie NumPy und pandas, gesammelt aus echten StackOverflow-Fragen und so verändert, dass die Modelle sie nicht auswendig kennen können. Bei Veröffentlichung Ende 2022 löste das beste System, Codex-002, 43,3 Prozent der Aufgaben korrekt [2]. Die Werte neuerer Modelle liegen deutlich höher, aber die Lektion des Benchmarks bleibt: Selbst Routine-Analysen mit Standardbibliotheken sind für Sprachmodelle keine Formsache, und die Fehler sind nicht als solche markiert.
Dazu kommt eine Fehlerklasse, die kein Benchmark misst: Das Modell kennt Ihre Daten nicht. Es rät, dass „date“ das Erhebungsdatum ist und nicht das Lieferdatum, dass fehlende Werte Null bedeuten, dass die Zahlen in Euro und nicht in Tausend Euro vorliegen. Der Code läuft fehlerfrei durch, das Diagramm sieht professionell aus, und die Aussage ist falsch. Solche Annahmen stehen mitten im erzeugten Code, aber ohne Warnung.
| Stille Annahme | Beispiel | Gegenprobe |
|---|---|---|
| Spaltenbedeutung geraten | „date“ ist Lieferdatum, nicht Erhebungsdatum | Zwanzig Zeilen Rohdaten selbst ansehen |
| Fehlende Werte als Null | Leere Zellen werden zu 0 im Mittelwert | Fehlwerte-Zählung pro Spalte verlangen |
| Einheiten verwechselt | Euro statt Tausend Euro | Größenordnung einer Kernzahl überschlagen |
| Zeitraum falsch gefiltert | Kalenderjahr statt Erhebungszeitraum | Min/Max der Datumsspalte ausgeben lassen |
| Gruppierung ohne Fachlogik | Altersgruppen quer zum Untersuchungsdesign | Gruppierung im Auftrag explizit vorgeben |
Plausibilität als Pflichtprogramm
- Daten zuerst selbst ansehen. Zwanzig Zeilen der Datei, die Spaltennamen, die Einheiten. Wer die Daten nicht kennt, kann die Antwort nicht bewerten.
- Den Auftrag eng formulieren. „Berechne den Median von Spalte X, gruppiert nach Spalte Y, ohne Zeilen mit fehlenden Werten“ statt „analysiere die Datei“. Je enger der Auftrag, desto weniger Raum für Annahmen.
- Den Code lesen. Der Assistent zeigt den erzeugten Code; er ist die eigentliche Arbeitsdatei. Wer kein Python liest, lässt sich vom Modell Zeile für Zeile erklären, was jede Zeile tut und welche Annahme darin steckt.
- Jede Kernzahl gegenrechnen. Eine zweite, unabhängige Berechnung derselben Zahl, per Hand, per Tabellenkalkulation oder per zweitem, anders formuliertem Auftrag. Zwei verschiedene Wege zum gleichen Ergebnis sind der stärkste Plausibilitätsbeweis.
- Randfälle prüfen. Leere Spalten, Duplikate, Ausreißer, Zeitzonen. Gerade die Zeilen, die man nicht erwartet, entscheiden, ob die Analyse trägt.
- Den Ablauf dokumentieren. Datei-Stand, Auftrag, Code und Ergebnis gehören zusammen abgelegt, etwa als Notebook [3]. Nur so ist die Auswertung später reproduzierbar.
Datenschutz: Was mit den hochgeladenen Daten passiert
Vor dem ersten Upload gehört ein Blick in die Datenverwendung des Anbieters. Bei OpenAI etwa können Inhalte aus den Verbraucher-Produkten wie ChatGPT zum Training der Modelle genutzt werden; widersprechen lässt sich das über das Datenschutzportal („do not train on my content“) oder per Temporärem Chat, der gar nicht erst ins Training einfließt. Bei den Angeboten für Organisationen, also Team, Enterprise und API, werden Ein- und Ausgaben dagegen standardmäßig nicht fürs Training verwendet [4]. (Stand: 13. März 2026; Konditionen prüfen.) Für personenbezogene oder vertrauliche Daten gilt dasselbe wie überall: erst klären, ob sie das System überhaupt verlassen dürfen; die Grundlagen dazu behandelt der Artikel über <a href="/dsgvo-und-ki">DSGVO und KI</a>.
Grenzen, die bleiben
- Keine Statistikberatung. Der Assistent rechnet, was verlangt wird; ob der Test zum Design passt, ob Korrelation als Kausalität gelesen wird, liegt bei Ihnen.
- Halluzinierte Fakten in der Interpretation. Der Kommentar zum Diagramm kann genauso danebenliegen wie jede andere Modellaussage; Zahlen im Fließtext gegen den Code prüfen.
- Upload-Grenzen und Dateiformate. Welche Dateien in welcher Größe akzeptiert werden, hängt von Tarif und Anbieter ab und ändert sich laufend [1].
- Vertraulichkeit. Sensible Rohdaten gehören nicht in Verbraucher-Chats; Widerspruch und Business-Tarife sind die dokumentierten Wege [4].
Datenanalyse mit KI-Assistenten ist ein Produktivitätsgewinn, solange die Arbeitsteilung klar bleibt: Das Modell beschleunigt Code und Darstellung, der Mensch liefert Kontext, Prüfung und Interpretation. Wer diese Reihenfolge umdreht, produziert schön formatierte Fehler. Wie die Nutzung in wissenschaftlichen Arbeiten zu deklarieren ist, zeigt der Artikel über <a href="/ki-deklaration-wissenschaft">KI-Deklaration in der Wissenschaft</a>; die Suche nach der passenden Literatur zur Methodik behandelt <a href="/literaturrecherche-ki">Literaturrecherche mit KI</a>; Fachbegriffe erklärt das Glossar, etwa <a href="/glossar#halluzination">Halluzination</a> und <a href="/glossar#prompt">Prompt</a>.
Methode
Gelesen wurden am 20. Oktober 2026: die OpenAI-Hilfeseite zu Datei-Uploads und Datenanalyse, das DS-1000-Paper (arXiv, Volltext), die OpenAI-Seite zur Datenverwendung für das Modelltraining (Stand 13. März 2026), die Projektseite von Jupyter und die pandas-Dokumentation. Die Trefferquote im Diagramm ist der Wert des besten Systems bei Veröffentlichung des Benchmarks, kein aktueller Messwert. Der Text entstand mit KI-Unterstützung und wurde von der Redaktion verantwortet.
Grenzen
Der DS-1000-Wert stammt von Ende 2022 und beschreibt das damals beste System; aktuelle Modelle liegen höher, ein vergleichbar sauberer, memorisierungsgeschützter aktueller Wert liegt nicht vor. Tarife, Upload-Grenzen und Datennutzungsregeln der Anbieter ändern sich laufend und sind zum jeweiligen Nutzungszeitpunkt zu prüfen. Der Artikel ersetzt keine statistische Beratung und keine Rechtsberatung zum Datenschutz.
Quellen
- Uploading files and audio to ChatGPT, OpenAI Help Center ↩1 ↩2 ↩3 ↩4
- DS-1000: A Natural and Reliable Benchmark for Data Science Code Generation, arXiv (2022) ↩1 ↩2 ↩3
- Project Jupyter, jupyter.org ↩1 ↩2
- How your data is used to improve model performance, OpenAI (Stand 13. März 2026) ↩1 ↩2 ↩3
- pandas documentation, pandas (pydata.org) ↩1 ↩2