 KI
Ein 45-minütiges Interview liegt als Audiodatei vor, die Abgabefrist rückt näher, und früher hieß das: eine Stunde Abtippen, eher zwei. Heute lädt man die Datei in ein Transkriptionswerkzeug und bekommt nach wenigen Minuten ein durchsuchbares Skript mit Zeitstempeln. Der Zeitgewinn ist real. Die entscheidende Frage ist nur, wo das Transkript endet und wo journalistische Prüfung beginnt.
Spracherkennung ist erwachsen geworden
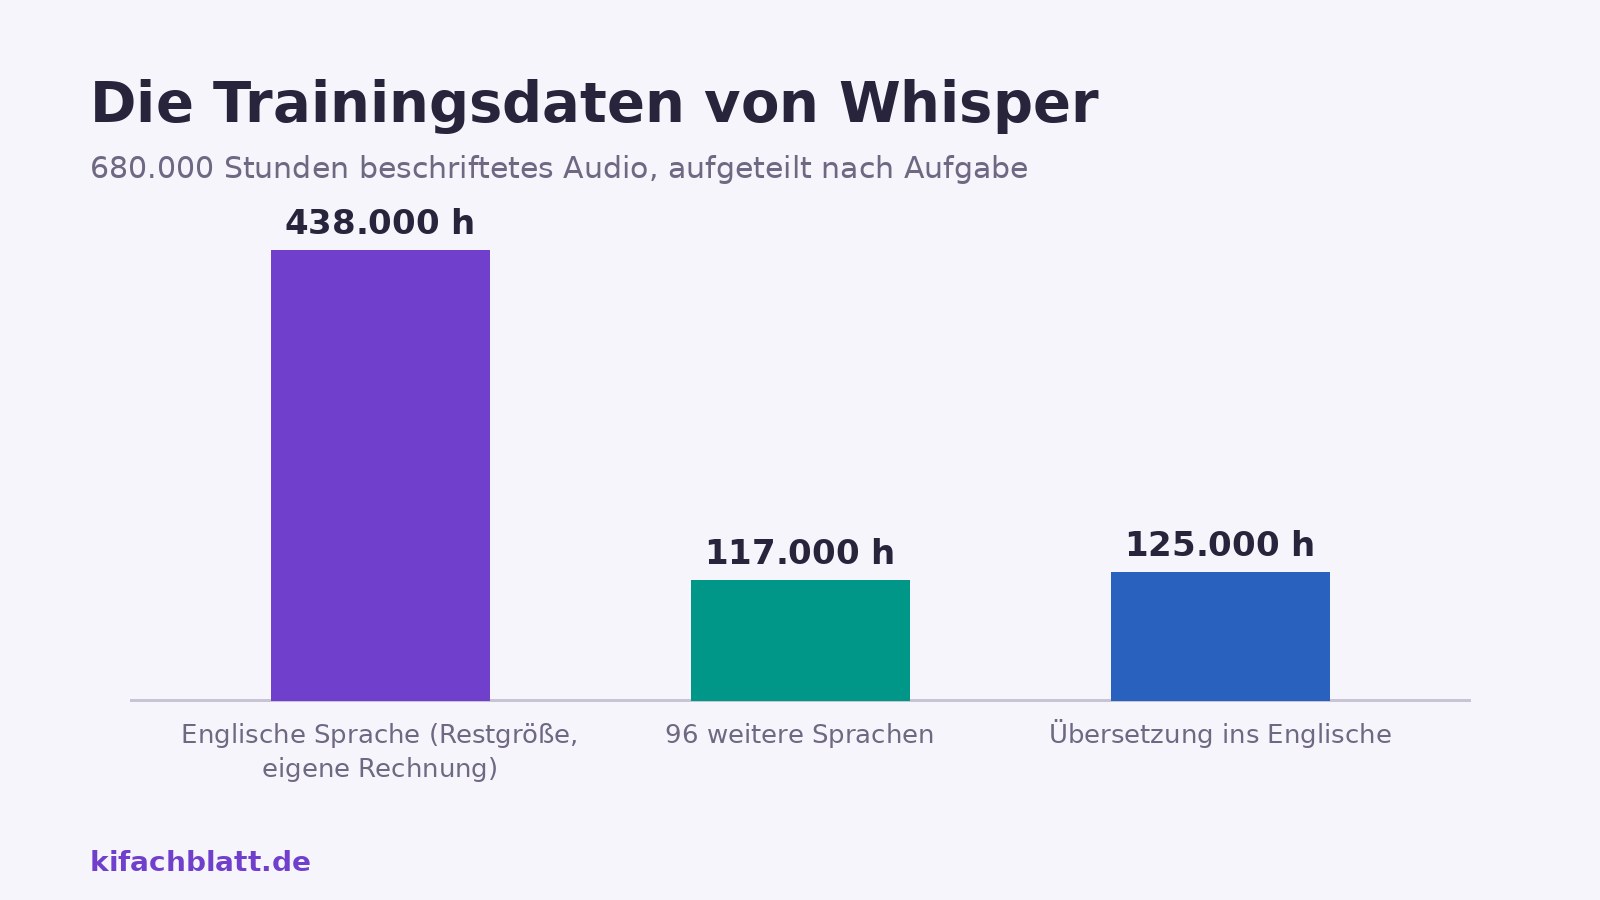
Der Referenzpunkt ist Whisper, ein 2022 von OpenAI veröffentlichtes Modell, das mit 680.000 Stunden beschrifteter Audiodaten trainiert wurde. Davon entfallen 117.000 Stunden auf 96 Sprachen jenseits des Englischen und 125.000 Stunden auf Übersetzungsdaten [1]. Zwei Ergebnisse der Studie sind für die Praxis zentral. Erstens: Das Modell verallgemeinert ungewöhnlich gut. Auf fremden Aufnahmen, die es nie im Training gesehen hat, machte es im Schnitt 55,2 Prozent weniger Fehler als ein Vergleichsmodell, das auf dem Referenzdatensatz fast gleichauf lag [1]. Zweitens: In einem Vergleich mit professionellen menschlichen Transkriptionsdiensten lag Whisper nur einen Bruchteil eines Prozentpunktes hinter den rein menschlichen Anbietern; der beste computergestützte Dienst war 1,15 Prozentpunkte besser [1].
Mindestens ebenso wichtig wie die Qualität ist die Verfügbarkeit. OpenAI hat Code und Modelle quelloffen veröffentlicht, in sieben Größen von 39 Millionen bis 1,55 Milliarden Parametern [2]. Die kleinen Varianten laufen auf einem normalen Redaktionslaptop, die großen auf einer Workstation mit Grafikkarte. Transkription ist damit kein Cloud-Dienst mehr, den man pro Minute bezahlt, sondern ein Werkzeug, das auf dem eigenen Gerät läuft, inklusive der Frage, welche Daten das Gerät überhaupt verlassen müssen.
Warum die Datenmenge so zählt, zeigt eine Rechenregel aus dem Paper: Bei den untersuchten Sprachen halbierte sich die Fehlerrate jeweils, wenn die Trainingsdaten einer Sprache versechzehnfacht wurden [1]. Wer viel gesprochenes Material im Netz hinterlässt, wird gut verstanden; wer eine kleine Sprache oder einen starken Dialekt spricht, eben nicht. Genau daraus folgen die wichtigsten Praxisgrenzen weiter unten.
Was für deutschsprachige Redaktionen zählt
Für deutsche Interviews ist die Sprachabdeckung der entscheidende Faktor. Hier ist seit 2025 ein zweites offenes Modell relevant: NVIDIAs Parakeet-TDT-0.6B-v3 wurde gezielt für 25 europäische Sprachen trainiert, Deutsch ausdrücklich eingeschlossen. Das Modell setzt automatisch Punktuation und Großschreibung, liefert Zeitstempel auf Wortebene, verarbeitet bis zu 24 Minuten Audio mit voller Aufmerksamkeit und bis zu drei Stunden mit lokaler Aufmerksamkeit. Es steht unter der permissiven CC-BY-4.0-Lizenz, die auch die kommerzielle Nutzung erlaubt [4].
Welches Modell für welches Material am besten passt, lässt sich nicht pauschal beantworten. Die Fehlerraten unterscheiden sich je nach Sprache, Aufnahmequalität und Sprecher stark. Die Modellkarte von Whisper weist die Fehlerrate je Sprache gesondert aus und warnt vor schwächeren Ergebnissen bei Dialekten, Akzenten und Sprachen mit wenig Trainingsmaterial; dort steigt auch die Neigung, Text zu erfinden oder zu wiederholen [3]. Einen laufend gepflegten Vergleich bietet das Open ASR Leaderboard auf Hugging Face, das aktuelle Modelle auf standardisierten Datensätzen misst [5]. Vor der Einführung lohnt ein eigener Test: ein typisches Redaktionsinterview, zwei Modelle, zehn Minuten Nachzählen.
| Eigenschaft | Whisper (large-v3) | Parakeet-TDT-0.6B-v3 |
|---|---|---|
| Anbieter | OpenAI | NVIDIA |
| Parameter | 1,55 Milliarden | 600 Millionen |
| Sprachen | 99 (unterschiedliche Qualität) | 25 europäische, Deutsch enthalten |
| Lizenz | MIT (Code und Modelle offen) | CC-BY-4.0, kommerziell nutzbar |
| Besonderheiten | Zeitstempel, Spracherkennung, Übersetzung ins Englische | Auto-Punktation, Wort-Zeitstempel, bis 3 h Audio |
Vom Transkript zur Zusammenfassung
Das Transkript ist erst der Rohstoff. Der zweite Schritt im Alltag ist das Verdichten: ein <a href="/glossar#sprachmodell-llm">Sprachmodell</a> gliedert das Gespräch nach Themen, zieht Kernaussagen heraus oder baut ein Exposé. Das spart erneut Zeit, verschiebt aber das Risiko. Während das Transkriptionsmodell Wörter verwechselt, kann das Sprachmodell Inhalte verschieben: Es lässt Einwände weg, glättet Widersprüche oder ergänzt Zusammenhänge, die so nicht gesagt wurden. Die Analyse „Why Language Models Hallucinate“ beschreibt den Grund: Modelle werden darauf trainiert, immer eine plausible Antwort zu liefern, statt Wissenslücken offenzulegen [6]. Eine Lücke im Transkript wird so schnell zur elegant überbrückten Lücke in der Zusammenfassung. Wer tiefer einsteigen will, findet den Mechanismus im Artikel über <a href="/halluzinationen">Halluzinationen</a>.
Die praktische Konsequenz: Die Zusammenfassung ist ein Arbeitsentwurf, nie ein Protokoll. Sie eignet sich, um ein langes Gespräch zu erschließen, Zitate zu finden und einen Artikel zu strukturieren. Sie eignet sich nicht, um ungesehen in Text oder Rechercheakte zu wandern.
Ein Workflow für den Redaktionsalltag
- Einwilligung und Aufnahme klären. Wie bei jeder Aufzeichnung gilt: Die Gesprächspartner müssen der Aufnahme zustimmen. Schon der Upload der Audiodatei in einen Cloud-Dienst ist eine Verarbeitung personenbezogener Daten.
- Lokal oder Cloud bewusst wählen. Sensible Interviews, etwa mit Informanten, gehören auf ein lokales Modell wie Whisper oder Parakeet; die Datei verlässt dann den eigenen Rechner nicht [2][4]. Für unverfängliches Material sind Cloud-Dienste bequemer. Was dabei rechtlich zu prüfen ist, skizziert der Artikel über <a href="/dsgvo-und-ki">DSGVO und KI</a>.
- Transkript mit Zeitstempeln erzeugen. Zeitstempel sind kein Luxus: Sie machen jede Stelle mit einem Klick am Original nachprüfbar [4].
- Stichproben am Audio prüfen. Zwei, drei Passagen gegen die Aufnahme hören genügen, um die Qualität des jeweiligen Materials einzuschätzen: Namen, Zahlen, Fachbegriffe.
- Zusammenfassung gezielt beauftragen. „Gliedere das Transkript nach Themen und liste je die Kernaussagen mit Zeitstempel“ funktioniert besser als „Fasse zusammen“, weil der Zeitstempel den Rückweg ans Original offenhält.
- Wörtliche Zitate immer am Original prüfen. Ausnahmslos. Ein Transkript ist eine Näherung, und genau die prägnantesten Formulierungen sind die, bei denen ein einziges falsches Wort den Sinn dreht.
Grenzen, die bleiben
- Eigennamen und Fachvokabular. Was selten im Trainingsmaterial vorkommt, wird durch Ähnliches ersetzt. Namen von Personen, Firmen und Orten sind die klassischen Fehlerstellen.
- Dialekt und Akzent. Die Fehlerrate steigt messbar bei Sprechern, deren Aussprache im Trainingsmaterial unterrepräsentiert ist [3].
- Übersprechen und Hall. Sobald mehrere Menschen gleichzeitig reden oder der Raum schallt, wächst die Fehlerquote; die Zuordnung von Sprechern ist ohnehin ein separates Problem, das Whisper nicht löst [1].
- Sprachen abseits der Hauptdaten. Die Qualität hängt stark vom Datenvolumen je Sprache ab; bei wenig Material drohen <a href="/glossar#halluzination">Halluzinationen</a>, also frei erfundene Passagen im Transkript [3].
- Stille Korrekturen bei der Zusammenfassung. Das Sprachmodell kennzeichnet nicht, was es weggelassen oder ergänzt hat [6]. Ohne Rückgriff auf Transkript und Audio bleibt das unsichtbar.
Transkription und Zusammenfassung gehören zu den reifsten KI-Anwendungen im Redaktionsalltag: Der Nutzen ist groß, die Fehler sind systematisch und damit beherrschbar. Wer die Prüfung am Original als festen Schritt einbaut, gewinnt Stunden, ohne die Sorgfaltspflicht auszulagern. Wie die Redaktion selbst mit KI-Werkzeugen arbeitet, legt die Seite <a href="/transparenz">Transparenz</a> offen.
Methode
Gelesen wurden am 20. Oktober 2026: das Whisper-Paper von Radford und Kollegen (arXiv, Volltext), das Whisper-Repository von OpenAI, die Modellkarten von openai/whisper-large-v3 und nvidia/parakeet-tdt-0.6b-v3 auf Hugging Face, das Open ASR Leaderboard sowie die Analyse „Why Language Models Hallucinate“ (arXiv). Alle Zahlen zu Trainingsdaten, Modellgrößen und Fehlerraten stammen aus diesen Quellen; das Diagramm zu den Trainingsdaten ist eine eigene Darstellung, der englische Anteil darin eine als solche markierte eigene Rechnung. Der Text entstand mit KI-Unterstützung und wurde von der Redaktion verantwortet.
Grenzen
Die zitierten Vergleiche mit menschlichen Transkriptoren stammen aus dem Jahr 2022 und beziehen sich auf Englisch; für Deutsch liegt keine entsprechende Untersuchung vor. Fehlerraten hängen stark von Aufnahmequalität, Sprechern und Sprache ab und können mit neueren Modellversionen anders ausfallen. Die praktischen Empfehlungen ersetzen keine Rechtsberatung zum Datenschutz.
Quellen
- Robust Speech Recognition via Large-Scale Weak Supervision (Whisper-Paper), arXiv (OpenAI, 2022) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- openai/whisper (Quellcode und Modelle), GitHub ↩1 ↩2 ↩3 ↩4
- Modellkarte: openai/whisper-large-v3, Hugging Face ↩1 ↩2 ↩3 ↩4
- Modellkarte: nvidia/parakeet-tdt-0.6b-v3, Hugging Face (NVIDIA) ↩1 ↩2 ↩3 ↩4 ↩5
- Open ASR Leaderboard, Hugging Face Spaces ↩
- Why Language Models Hallucinate, arXiv (Kalai u. a., 2025) ↩1 ↩2 ↩3