 KI
Ein Pressebüro bekommt einen Leserbrief, der verdächtig glatt klingt. Eine Lehrkraft liest eine auffällig fehlerfreie Hausarbeit. Ein Redakteur prüft einen PR-Text auf Maschinensatz. Die Frage ist immer dieselbe: Hat hier ein Mensch geschrieben oder ein Modell? Die Antwort des Marktes lautet: Dutzende Detektoren versprechen genau das. Die Antwort der Forschung lautet: trau ihnen nicht.
Zwei Wege, KI-Text zu erkennen
Grundsätzlich gibt es zwei technische Ansätze. Der erste ist die nachträgliche Erkennung (post hoc): Ein Klassifikator analysiert einen fertigen Text und schätzt statistische Merkmale, etwa wie vorhersagbar die Wortfolge ist. Diese Werkzeuge brauchen keine Mitarbeit der Modellanbieter, funktionieren aber nur, solange sich maschineller und menschlicher Stil statistisch unterscheiden. Der zweite Ansatz ist das <a href="/glossar#watermarking-bei-ki-text">Wasserzeichen</a>: Der Anbieter markiert den Text schon bei der Erzeugung, indem er die Wortwahl nach einem geheimen, rekonstruierbaren Muster steuert. Erkennung ist dann ein Messvorgang, keine Stildeutung [1].
Es gab auch einen dritten, theoretischen Weg: Anbieter könnten jede erzeugte Antwort zentral speichern und spätere Anfragen gegen dieses Archiv abgleichen. Das scheitert praktisch am Aufwand, an der nötigen Koordination aller Anbieter und nicht zuletzt am Datenschutz, denn es setzte ein Protokoll sämtlicher Nutzeranfragen voraus [1]. Übrig bleiben die beiden Wege, die heute real existieren: nachträgliche Stilanalyse und Wasserzeichen bei der Erzeugung.
Warum die Stilanalyse strukturell ins Hintertreffen gerät, beschreibt schon das SynthID-Paper: Detektoren müssen ständig nachgeschärft werden, weil neue Modelle immer menschenähnlicher schreiben, und sie versagen außerhalb der Textsorten, auf denen sie trainiert wurden [1]. Es ist ein Wettrüsten, bei dem die Erkennung der Erzeugung hinterherläuft.
Wasserzeichen: SynthID als Praxistest
Das prominenteste Text-Wasserzeichen ist SynthID-Text von Google DeepMind, 2024 in Nature beschrieben und in Gemini im Produktivbetrieb. Das Verfahren verändert nicht das Modell, sondern nur die Auswahl der <a href="/glossar#token">Tokens</a>: Bei jedem Schritt konkurrieren Kandidaten in einem turnusartigen Verfahren („Tournament Sampling“), und pseudozufällige Bewertungsfunktionen entscheiden mit, wer gewinnt. Das Muster dieser Entscheidungen ist das Wasserzeichen; die Erkennung braucht das Sprachmodell selbst nicht und misst nur, wie stark ein Text zu den Bewertungsfunktionen passt [1].
Die Kennzahlen sind beeindruckend: Im Test an einem 7-Milliarden-Parameter-Modell erhöhte sich die Rechenzeit pro Token um nur 0,57 Prozent, und in einem Livetest mit rund 20 Millionen Gemini-Antworten blieb die von Nutzern bewertete Textqualität unverändert [1]. Google DeepMind bietet SynthID als Werkzeug zur Kennzeichnung und Erkennung KI-generierter Inhalte an [5].
Die Grenzen liegen in der Architektur, nicht in der Qualität. Ein Wasserzeichen funktioniert nur bei Anbietern, die es einbauen; bei offenen Modellen, die jeder selbst betreiben kann, lässt es sich schwer durchsetzen. Und es verträgt keine Bearbeitung: Wer den Text umschreibt, etwa durch ein anderes Modell paraphrasieren lässt, schwächt das Signal deutlich [1]. Wasserzeichen beantworten also nur die Frage „Kommt dieser Text aus diesem System?“, nicht die Frage „Ist das KI?“.
Detektoren: Was die Studien zeigen
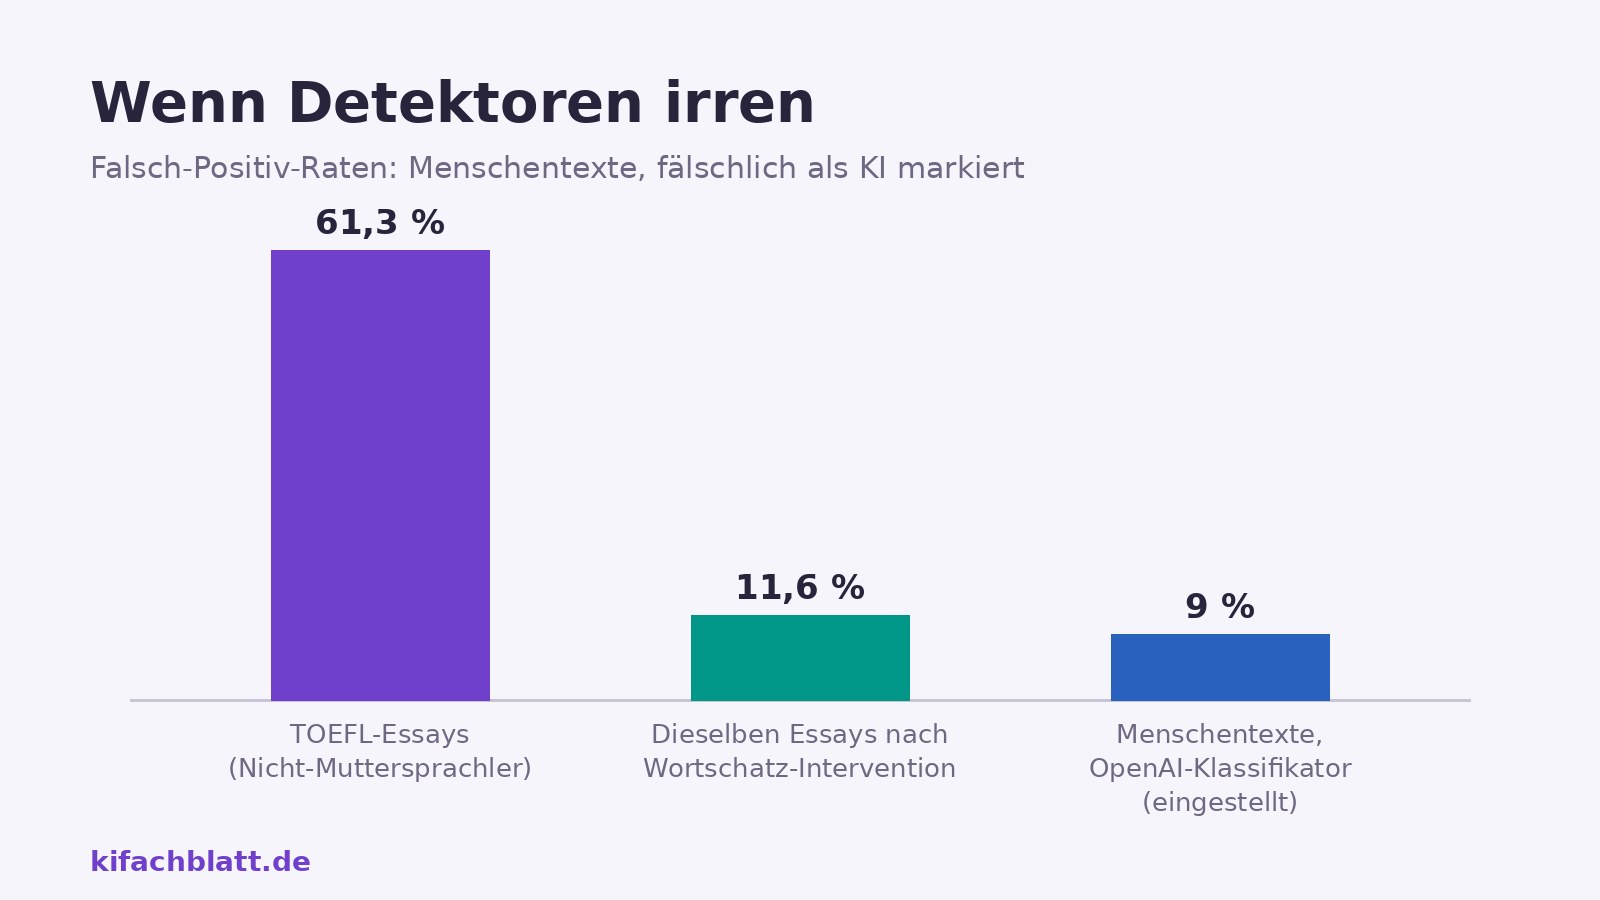
Bei den nachträglichen Detektoren ist die Befundlage eindeutig. OpenAI selbst stellte seinen Klassifikator für KI-geschriebenen Text am 20. Juli 2023 wegen zu geringer Genauigkeit ein. Das Unternehmen hatte bei Veröffentlichung eingeräumt, dass das Werkzeug im Test nur 26 Prozent der KI-Texte als solche erkannte und zugleich 9 Prozent der Menschentexte fälschlich als KI markierte [2].
Ein Team der Stanford University legte 2023 den systematischen Fehler dahinter offen: Sieben verbreitete Detektoren prüften 91 TOEFL-Essays nicht-muttersprachlicher englischer Autoren und markierten im Mittel 61,3 Prozent davon fälschlich als KI-generiert; mindestens ein Detektor schlug bei 97,8 Prozent der Essays an. Die Kontrollgruppe, Aufsätze von US-Achtklässlern, wurde dagegen weitgehend korrekt eingeordnet. Der Mechanismus: Die Werkzeuge messen, wie „überrascht“ ein Sprachmodell vom Text ist, und einfacher, formelhafter Wortschatz wirkt wie Maschinensatz. Als die Forschenden den Wortschatz der Essays per ChatGPT anreicherten, sank die Falsch-Positiv-Rate von 61,3 auf 11,6 Prozent. Ihre Empfehlung: solche Detektoren nicht in bewertenden Kontexten einsetzen [3].
Die bislang umfassendste Prüfung kommt von einer Gruppe um die Informatikerin Debora Weber-Wulff: Vierzehn Werkzeuge, darunter die Hochschul-Systeme Turnitin und PlagiarismCheck, wurden mit menschlichen, maschinellen und absichtlich verschleierten Texten getestet. Ergebnis: Die Werkzeuge waren weder genau noch zuverlässig, tendierten eher dazu, KI-Text als menschlich durchgehen zu lassen, und verloren durch einfache Tricks wie Umsortieren von Wörtern oder maschinelles Paraphrasieren weiter an Treffsicherheit [4].
| Untersuchung | Jahr | Geprüft | Zentrales Ergebnis |
|---|---|---|---|
| OpenAI, eigener Klassifikator | 2023 | Englische Testtexte | Nur 26 % der KI-Texte erkannt, 9 % der Menschentexte fälschlich markiert; Dienst eingestellt |
| Liang u. a. (Stanford) | 2023 | 7 Detektoren, 91 TOEFL-Essays | 61,3 % Falsch-Positiv-Rate bei Nicht-Muttersprachlern |
| Weber-Wulff u. a. | 2023 | 14 Werkzeuge inkl. Turnitin | Weder genau noch zuverlässig; Verschleierung verschlechtert die Erkennung deutlich |
Was das für Redaktionen und Prüfer bedeutet
- Kein Detektor-Ergebnis als Beweis. Ein Score ist eine Stildeutung mit messbaren systematischen Fehlern. Als alleinige Grundlage für einen Vorwurf, etwa in Personal- oder Prüfungsverfahren, taugt er nicht [3][4].
- Herkunft statt Stil prüfen. Was belastbar ist: Quellen nachvollziehen, Fakten gegen Originale prüfen, Arbeitsstände und Entwürfe anfordern, bei Bildern und Audio auf C2PA-Herkunftsnachweise achten. Die Faktenseite eines Textes ist prüfbar, seine Entstehung meist nicht.
- Wasserzeichen als Plus, nicht als Pflichtbeweis. Wo SynthID oder vergleichbare Verfahren aktiv sind, liefern sie ein starkes Signal [1][5]. Wo sie fehlen, sagt ihr Fehlen nichts aus.
- Eigene Texte nicht „detektor-sicher“ schreiben. Wer sich vor Falschverdacht schützen will, dokumentiert seinen Arbeitsprozess. Sich am Stil von Detektoren zu orientieren, würde den Fehler der Werkzeuge zur Schreibregel machen.
Die Erkennungsfrage wird bleiben, aber die Antwort verschiebt sich: Weg von der Stilanalyse einzelner Texte, hin zu Herkunftsnachweisen, die bei der Erzeugung beginnen. Bis die flächendeckend wirken, gilt für alle, die KI-Texte vermuten: prüfen, was geprüft werden kann, und den Rest offen benennen. Wie Redaktionen ihren eigenen KI-Einsatz sauber deklarieren, beschreibt der Artikel über <a href="/ki-deklaration-redaktion">KI-Deklaration in der Redaktion</a>; die technischen Hintergründe erklärt das Glossar unter <a href="/glossar#watermarking-bei-ki-text">Watermarking</a> und <a href="/glossar#halluzination">Halluzination</a>.
Methode
Gelesen wurden am 20. Oktober 2026: der Nature-Artikel zu SynthID-Text (Volltext), die Produktseite von SynthID bei Google DeepMind, OpenAIs Ankündigung und Einstellung des AI Classifier, die Studie von Liang und Kollegen in Patterns (Cell Press) sowie die Untersuchung von Weber-Wulff und Kollegen im International Journal for Educational Integrity (beide Open Access). Alle Prozentwerte stammen aus den jeweiligen Veröffentlichungen; das Diagramm fasst Falsch-Positiv-Raten als eigene Darstellung zusammen, ohne die Messgegenstände gleichzusetzen. Der Text entstand mit KI-Unterstützung und wurde von der Redaktion verantwortet.
Grenzen
Die Studien stammen aus 2023 und 2024 und beziehen sich auf die damals getesteten Werkzeuge und Modelle; neuere Detektoren können besser abschneiden, die Grundprobleme (Stil ist keine Herkunft, Wasserzeichen brauchen Mitwirkung der Anbieter) bleiben bestehen. Die 61,3 Prozent aus der Stanford-Studie gelten für englische TOEFL-Essays und sind nicht auf Deutsch übertragbar. Zu Bild-, Audio- und Video-Kennzeichnung (etwa C2PA) sagt dieser Artikel nichts.
Quellen
- Scalable watermarking for identifying large language model outputs (SynthID-Text), Nature (Google DeepMind, 2024) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- New AI classifier for indicating AI-written text, OpenAI (2023, Hinweis zur Einstellung) ↩1 ↩2 ↩3
- GPT detectors are biased against non-native English writers, Patterns / Cell Press (Liang u. a., 2023) ↩1 ↩2 ↩3 ↩4
- Testing of detection tools for AI-generated text, International Journal for Educational Integrity (Weber-Wulff u. a., 2023) ↩1 ↩2 ↩3 ↩4
- SynthID, Google DeepMind ↩1 ↩2 ↩3