 KI
Ein Redakteur fragt einen KI-Assistenten nach einer Zahl für einen Artikel. Die Antwort kommt in Sekunden, mit Quellenangabe, im Tonfall einer Nachrichtenagentur. Die Zahl ist falsch, die Quelle existiert nicht. Diese Szene ist der Alltag mit Sprachmodellen: Sie liefern flüssige, plausibel wirkende Antworten, und gerade das macht sie für die Recherche gefährlich. Dieser Text erklärt, warum Modelle Fakten erfinden, was die aktuelle Studienlage über Fehlerquoten zeigt und welche Aufgaben im Faktencheck man einem Modell anvertrauen kann und welche nie.
Warum Sprachmodelle Fakten erfinden
Das Grundproblem ist statistisch, nicht böswillig. Ein Sprachmodell lernt aus Text, welche Wortfolgen wahrscheinlich sind, nicht welche Aussagen wahr sind. Wenn es keine Antwort weiß, erzeugt es trotzdem eine, weil seine Trainings- und Bewertungsverfahren das Raten belohnen: In den gängigen Tests gibt es Punkte für eine Antwort und keine Punkte für ein ehrliches „weiß ich nicht“. Das ist das zentrale Ergebnis der Analyse „Why Language Models Hallucinate“ von Forschern um Adam Tauman Kalai: Halluzinationen sind Fehler, die aus dem ganz normalen Lernverfahren entstehen, und sie bleiben bestehen, weil fast alle Bewertungsmaßstäbe unsicheres Verhalten bestrafen [1]. Hintergrund zum Mechanismus liefert unsere Seite Warum Sprachmodelle halluzinieren und der Glossar-Eintrag zur Halluzination.
Dazu kommt eine Eigenschaft, die in der Redaktion besonders tückisch ist: Das Modell klingt immer gleich sicher. Es markiert nicht, wo es weiß und wo es rät. Psychologisch wirkt der flüssige Text wie ein Beleg. Genau dieses „selbstbewusste Falschen“ benennen sowohl das Tow Center als Vertrauensfalle als auch die EBU-Studie als systemisches Muster über alle getesteten Assistenten hinweg [3][4].
Was die Studien zeigen: Fehlerquoten im Überblick
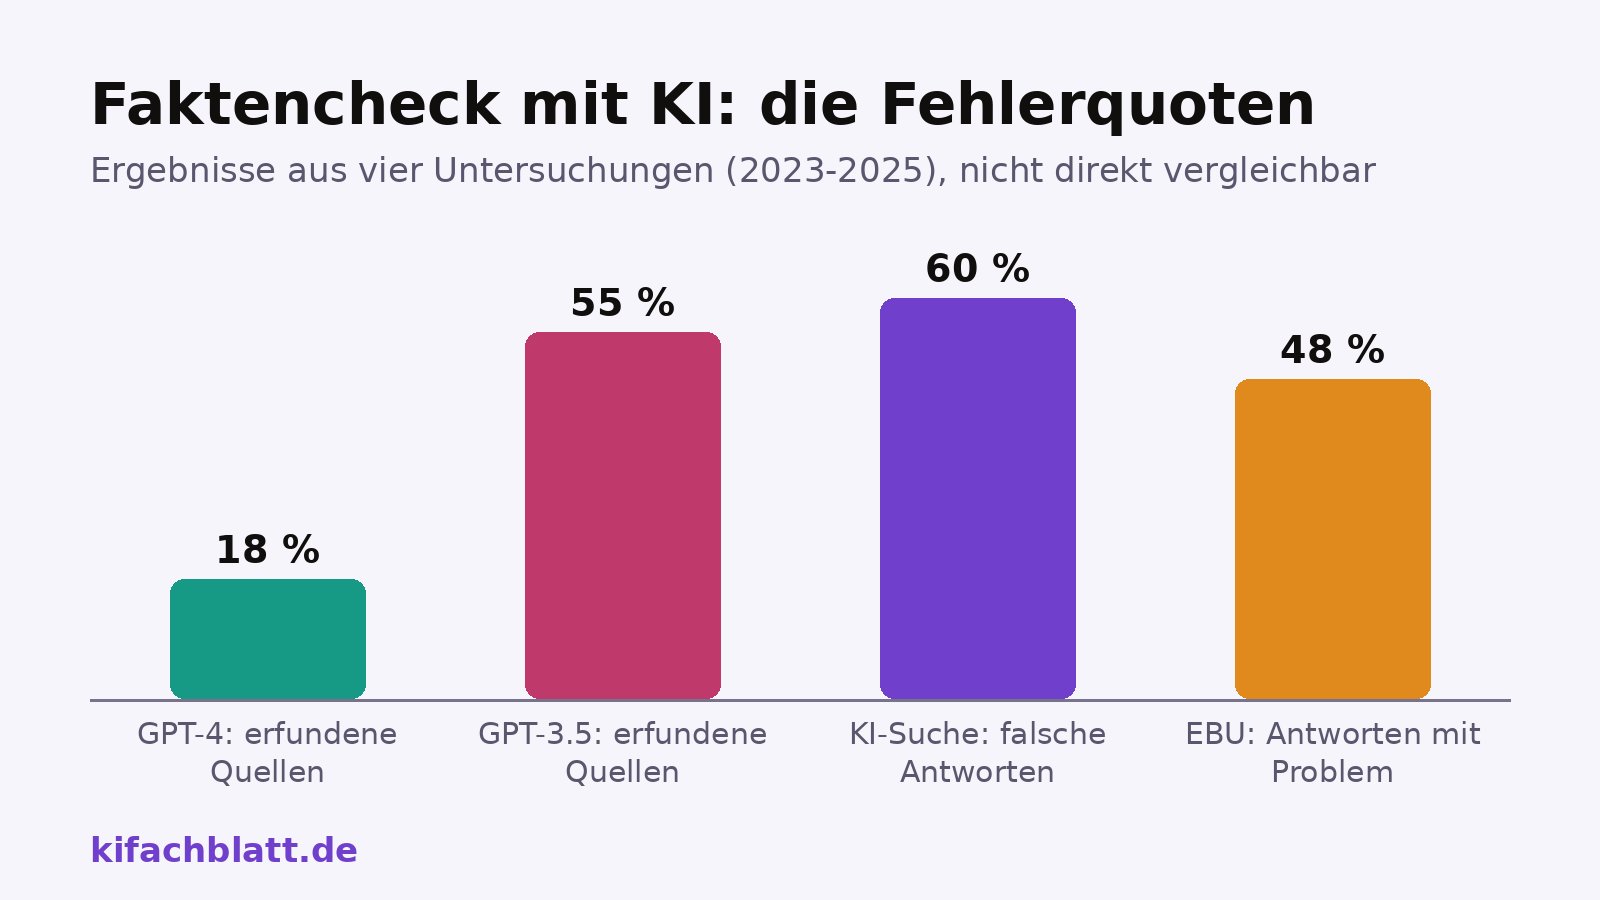
Vier Untersuchungen aus den Jahren 2023 bis 2025 geben ein konsistentes Bild. Sie messen unterschiedliche Dinge, deshalb sind die Prozentwerte nicht direkt vergleichbar; die Richtung aber ist eindeutig.
- Erfundene Literatur. Walters und Wilder ließen GPT-3.5 und GPT-4 kurze Literaturübersichten zu 42 Themen schreiben und prüften alle 636 Quellenangaben nach. Bei GPT-3.5 waren 55 Prozent der Angaben komplett erfunden, bei GPT-4 immer noch 18 Prozent; von den echten Angaben enthielten 24 bis 43 Prozent inhaltliche Fehler wie falsche Jahreszahlen oder Autorennamen [2].
- KI-Suchmaschinen. Das Tow Center for Digital Journalism stellte acht generativen Suchwerkzeugen 1.600 Anfragen zu Nachrichtenartikeln, deren Originalquelle über eine normale Suche leicht zu finden war. Insgesamt waren über 60 Prozent der Antworten falsch; die Spanne reichte von 37 Prozent Fehlern bei Perplexity bis zu 94 Prozent bei Grok 3. Bezahlversionen antworteten selbstbewusster, aber nicht genauer [3].
- Nachrichtenfragen im großen Vergleich. In der Untersuchung „News Integrity in AI Assistants“ bewerteten Journalistinnen und Journalisten von 22 öffentlich-rechtlichen Rundfunkanstalten in 18 Ländern mehr als 3.000 Antworten von ChatGPT, Copilot, Gemini und Perplexity auf Nachrichtenfragen. Fast die Hälfte der Antworten hatte mindestens ein gravierendes Problem, ein Drittel wies ernsthafte Quellenmängel auf, ein Fünftel enthielt grobe inhaltliche Fehler wie halluzinierte oder veraltete Angaben [4].
- Ursache bestätigt. Die OpenAI-nahe Analyse von 2025 liefert die Erklärung dazu: Solange Bewertungen Raten belohnen, bleibt das Raten rational. Die Autoren schlagen vor, die Bewertungskriterien der dominierenden Benchmarks zu ändern, statt nur neue Halluzinationstests anzuhängen [1].
Daten als Tabelle
| Untersuchung | Fehlerquote |
|---|---|
| GPT-4: erfundene Quellen | 18 % |
| GPT-3.5: erfundene Quellen | 55 % |
| KI-Suche: falsche Antworten | 60 % |
| EBU: Antworten mit Problem | 48 % |
Quelle: Eigene Darstellung nach [2][3][4]
Die Studien messen Unterschiedliches (erfundene Quellen, falsche Antworten, Antworten mit gravierendem Problem) und sind nicht direkt vergleichbar. Eigene Darstellung nach den Angaben in [2][3][4].
| Untersuchung | Jahr | Geprüft | Zentrales Ergebnis |
|---|---|---|---|
| Walters & Wilder | 2023 | 636 KI-Literaturangaben | 18 bis 55 % komplett erfunden |
| Tow Center (CJR) | 2025 | 1.600 Anfragen an 8 KI-Suchmaschinen | über 60 % falsche Antworten |
| EBU / BBC | 2025 | 3.000+ Antworten von 4 Assistenten | fast 50 % mit gravierendem Problem |
| Kalai u. a. (OpenAI-nah) | 2025 | Trainings- und Bewertungsverfahren | Raten wird belohnt, Ehrlichkeit bestraft |
Was geht: KI als Prüfassistent, nicht als Quelle
Die schlechte Nachricht ist nicht die ganze Geschichte. Dasselbe Modell, das als Auskunftsperson versagt, kann als Werkzeug im Prüfprozess helfen, weil dort sein Textverständnis zählt und nicht sein Faktenwissen. Sinnvoll eingesetzt wird es bei Aufgaben, deren Ergebnis Sie ohnehin am Original kontrollieren:
- Behauptungen extrahieren. Aus einem eigenen Artikelentwurf eine Liste aller prüfbaren Einzelaussagen ziehen lassen („Zahlen, Namen, Daten, Zitate“). Das Modell findet Prüfpunkte, die ein müder Redakteur übersieht; geprüft wird danach wie immer.
- Gegenleser spielen. Den Entwurf mit der Anweisung prüfen lassen, Widersprüche, unbelegte Superlative und logische Sprünge zu markieren. Das Ergebnis ist eine Liste von Verdachtsmomenten, keine Wahrheitsauskunft.
- Recherchewege sammeln. Fragen formulieren lassen, die man zur Prüfung stellen müsste, und mögliche Primärquellentypen benennen lassen (Statistikamt, Studie, Protokoll). Das ersetzt die Suche nicht, strukturiert sie aber.
- Transkripte und Dokumente durchsuchen. Innerhalb eines von Ihnen bereitgestellten Textes Stellen finden, die eine Aussage stützen oder widerlegen. Hier halluziniert das Modell weniger, weil die Antwort im Dokument steht; die Fundstelle prüfen Sie trotzdem mit einem Blick.
- Formate prüfen. Literaturverzeichnisse auf Vollständigkeit und Stil durchsehen lassen. Ob die Titel existieren, muss separat verifiziert werden, siehe unten.
Was nie geht
- Das Modell als Quelle zitieren. Eine KI-Aussage ist kein Beleg. Sie steht in keiner Datenbank, ist nicht reproduzierbar und kann von niemandem gegengelesen werden. Wer „laut ChatGPT“ schreibt, publiziert eine unprüfbare Behauptung.
- Quellenangaben des Modells ungeprüft übernehmen. Die 18 bis 55 Prozent erfundener Titel aus der Zitationsstudie [2] bedeuten: Jede vom Modell genannte Studie, jeder Link und jede DOI muss einzeln geöffnet werden. Erst was existiert und die Aussage trägt, ist eine Quelle.
- Den Faktencheck an das Modell delegieren. Die Frage „Stimmt das?“ an dasselbe System, das die Antwort erzeugt hat, prüft nichts. Das Modell bestätigt sich mit derselben Überzeugung, mit der es sich geirrt hat; diese Neigung zur Zustimmung ist als Sycophancy beschrieben.
- Aktualität annehmen. Ohne aktive Websuche kennt das Modell die Welt nur bis zu seinem Trainingsstand und auch dann lückenhaft. Preise, Ämter, Kurse und Gesetzestexte sind immer am Original zu prüfen.
- Vertrauliches einspeisen. Unveröffentlichte Recherchen, Informantennamen oder interne Dokumente gehören nicht in fremde KI-Dienste; was Sie eintippen, kann beim Anbieter landen. Die AP-Standards formulieren diese Regel für ihre Redaktion ausdrücklich so.
Ein Workflow, der trägt: Vier-Augen-Prinzip mit Maschine
Aus den Studien und der eigenen Praxis dieser Redaktion lässt sich ein Ablauf ableiten, der die Stärken nutzt und die Schwächen aussperrt:
- Trennen. Formulierung und Faktenbeschaffung sind zwei Schritte. Das Modell darf strukturieren, glätten, gegenlesen; die Fakten kommen aus Primärquellen.
- Behauptungsliste ziehen. Jede prüfbare Aussage des Entwurfs als einzelnen Punkt listen, maschinell vorschlagen lassen, manuell ergänzen.
- Jede Behauptung mit Primärquelle belegen. Originalstudie, Gesetzestext, Statistik, Protokoll. Keine Sekundärquelle zweiter Kette, kein KI-Text.
- Fundstellen dokumentieren. Link und Abrufdatum festhalten, wie es diese Redaktion in jedem Artikel unter „Quellen“ tut (so arbeiten wir).
- Vier Augen drauf. Eine zweite Person liest die heikelsten Stellen: Zahlen, Namen, Zitate. Bei KI-Unterstützung gilt das doppelt, weil Fehler sprachlich sauber verpackt sind.
Wer tiefer einsteigen will: Der Artikel Deep-Research-Werkzeuge in der Recherche zeigt, was die recherchierenden Agenten-Modi der Anbieter leisten und wo sie dieselben Grenzen haben; KI-Texte erkennen behandelt die umgekehrte Frage, ob man fremde KI-Texte als solche identifizieren kann. Die Begriffe Grounding und Temperatur im Glossar erklären zwei Stellschrauben, die Fehlerwahrscheinlichkeit beeinflussen.
Methode
Gelesen wurden am 20. Oktober 2026: die Analyse „Why Language Models Hallucinate“ (arXiv), die Zitationsstudie von Walters und Wilder in Scientific Reports (Volltext), der Bericht des Tow Center for Digital Journalism zu acht KI-Suchwerkzeugen und die Berichtsseite der EBU-Studie „News Integrity in AI Assistants“ mit den Kennzahlen. Prozentwerte stammen aus den jeweiligen Veröffentlichungen; das Diagramm fasst sie als eigene Darstellung zusammen, ohne die Messgegenstände gleichzusetzen. Der Text entstand mit KI-Unterstützung und wurde von der Redaktion verantwortet.
Grenzen
Die vier Studien messen unterschiedliche Dinge (erfundene Quellen, falsche Antworten, Antworten mit gravierendem Problem) und stammen aus den Jahren 2023 bis 2025; neuere Modellversionen können besser oder schlechter abschneiden. Die Werte sind Momentaufnahmen der getesteten Systeme, keine dauerhaften Eigenschaften einzelner Anbieter. Eigene Fehlerquoten deutscher Redaktionen liegen nicht vor.
Quellen
- Why Language Models Hallucinate, arXiv:2509.04664 (Kalai, Nachum, Vempala, Zhang, 2025) (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4
- Fabrication and errors in the bibliographic citations generated by ChatGPT, Scientific Reports (Walters & Wilder, 2023) (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- AI Search Has a Citation Problem, Columbia Journalism Review, Tow Center (Jaźwińska & Chandrasekar, 2025) (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- News Integrity in AI Assistants, EBU mit BBC und 22 öffentlich-rechtlichen Medien (2025) (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6