KI
Verlässlichkeit
Sicherheit für Agenten-Systeme: von Prompt Injection bis Sandbox
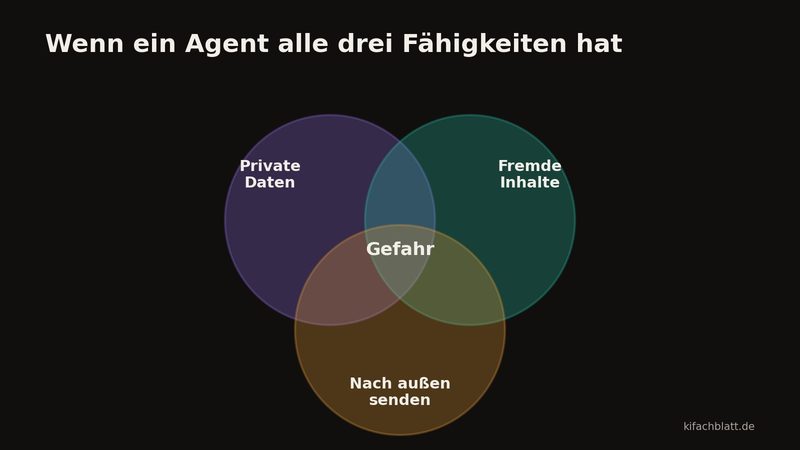
Warum KI-Agenten sich per Text austricksen lassen, was die tödliche Dreierkombination ist und welche Schutzschichten helfen, von Rechten bis Sandbox.
Lesen →
Warum KI-Agenten sich per Text austricksen lassen, was die tödliche Dreierkombination ist und welche Schutzschichten helfen, von Rechten bis Sandbox.
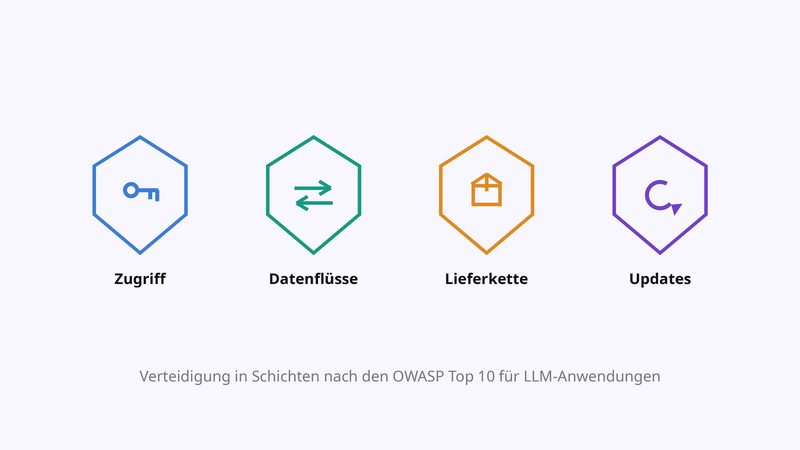
OWASP Top 10 für LLM-Anwendungen, Zugriff mit kleinsten Rechten, saubere Datenflüsse, geprüfte Modelle aus der Lieferkette und ein Patch-Rhythmus, der hält.
Kein Filter und kein System-Prompt stoppt jeden Angriff auf ein LLM-System. Was wirklich trägt: Verteidigung in Schichten, von der Eingabe bis zu den Rechten.
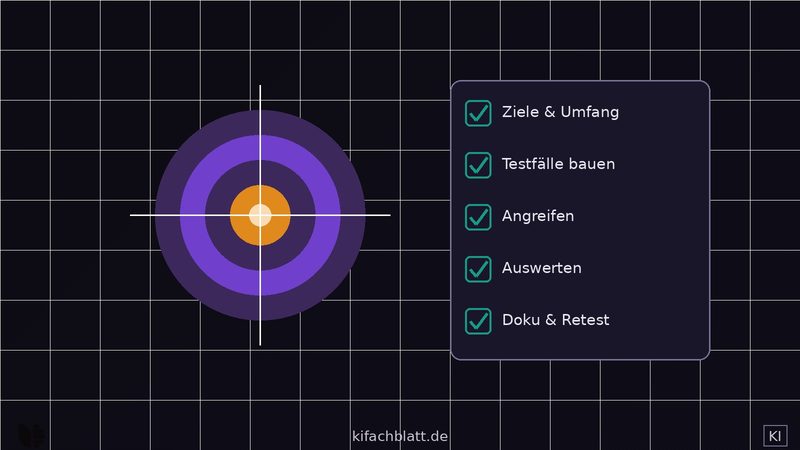
Red Teaming prüft ein KI-System mit bösen Fragen, bevor es andere tun. So planst du Umfang und Vorgehen, dokumentierst sauber und bleibst erlaubt.
Prompt Injection, Jailbreaks, vergiftete Daten, kopierte Modelle: die wichtigsten Angriffsmuster auf LLM-Systeme, eingeordnet anhand der OWASP Top 10 von 2025.
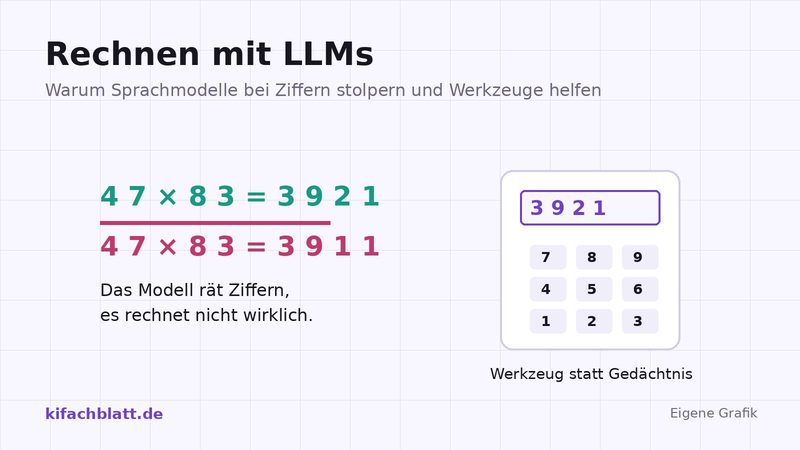
Sprachmodelle raten Ziffern statt zu rechnen. Was Studien zu Multiplikation und Textaufgaben zeigen und wie Werkzeugnutzung das Problem löst.
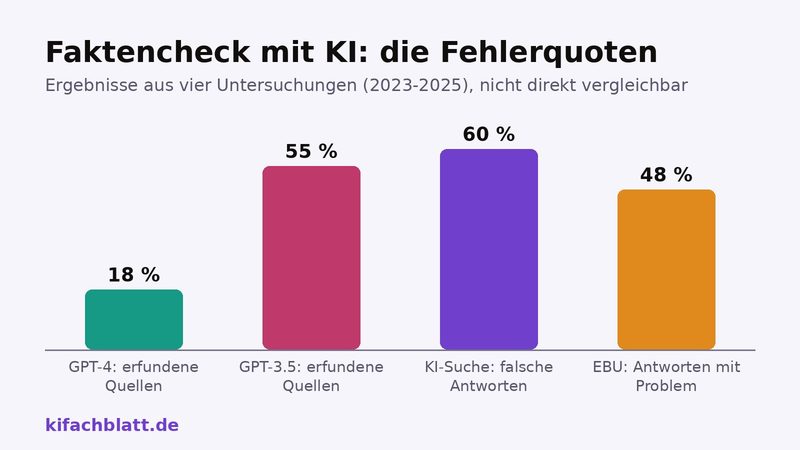
KI-Assistenten erfinden Quellen und nennen falsche Fakten mit voller Überzeugung. Was Studien über Fehlerquoten zeigen und wie ein Prüf-Workflow aussieht.