 KI
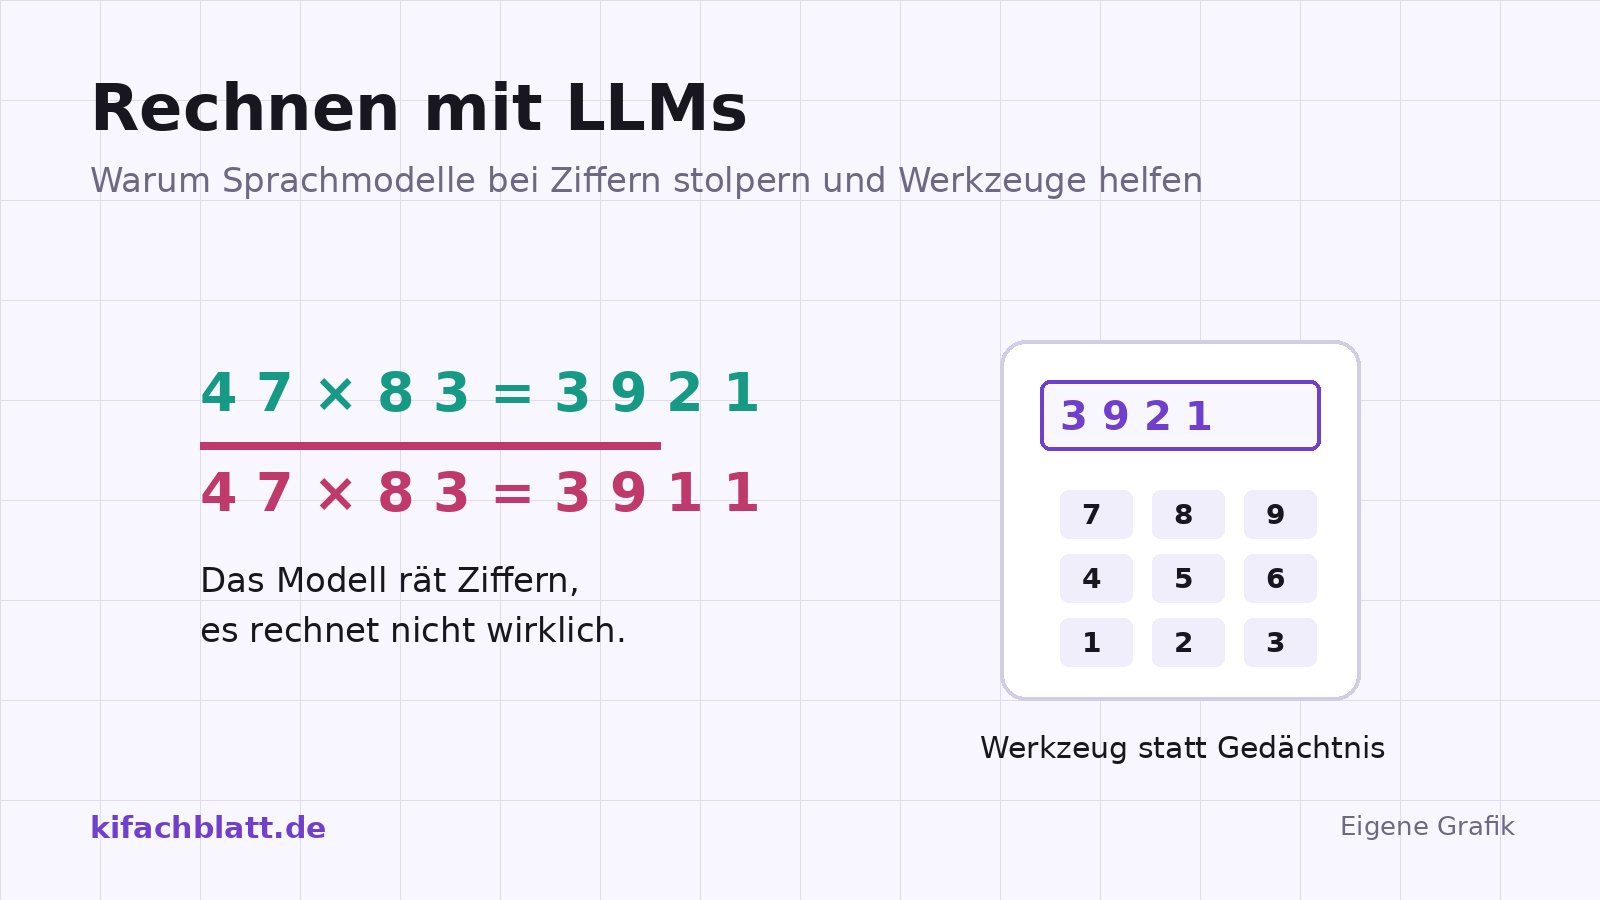
Bitte einmal kurz mitrechnen: Was ist 47 mal 83? Die meisten Menschen brauchen dafür Zettel oder einen Moment - ein Sprachmodell antwortet sofort. Manchmal mit 3.921, manchmal mit einer anderen, ebenso sicher klingenden Zahl. Der Grund: Das Modell hat nicht gerechnet. Es hat geantwortet. Dieser Beitrag erklärt, warum das so ist, was die Forschung dazu gemessen hat und wie du in Zahlenprozessen trotzdem zuverlässig arbeitest.
Warum Sprachmodelle nicht rechnen
Ein Sprachmodell zerlegt Text in Tokens und sagt das wahrscheinlichste nächste voraus. Für Sprache ist das eine Stärke. Für Arithmetik ist es ein Konstruktionsfehler: Multiplikation verlangt Zwischenschritte - Überträge, Stellenwerte, merken und weiterrechnen. Ein Modell ohne Rechenwerkzeug kennt diese Schritte nur als Textmuster. Es hat aus Billionen von Beispielen gelernt, wie korrekte Rechnungen aussehen, und gibt Ziffern wieder, die dazu passen. Bei geübten Mustern - kleine Zahlen, runde Beträge - wirkt das wie Können. Bei ungeübten bricht es zusammen, ohne dass das Modell davor warnt.
Was die Studien gemessen haben
Ein Team der Universität Tokio hat das asymmetrische Fehlerbild präzise beschrieben: Modelle sagen die erste Ziffer einer mehrstelligen Multiplikation häufig korrekt und selbstbewusst voraus, obwohl dafür eigentlich alle Rechenschritte nötig wären. Gleichzeitig scheitern sie an der letzten Ziffer - rechnerisch eine einfache Einstellig-mal-Einstellig-Aufgabe. Konditioniert man das Modell auf die korrekten höherwertigen Ziffern, steigt die Treffsicherheit für die letzte Ziffer deutlich, im Experiment bei 5-mal-5-stelligen Aufgaben um über 230 Prozent bei Llama 2-13B und um 150 Prozent bei Mistral-7B [1]. Die Autoren deuten das als Hinweis auf unvollständig gelernte Rechenwege: Das Modell „weiß“ Teile der Multiplikation, setzt sie aber nicht zuverlässig zusammen [1].
Daten als Tabelle
| Genauigkeit | |
|---|---|
| GPT-4 (allgemein) | 4,3 % |
| Spezialisiertes 2B-Modell | 99,9 % |
Quelle: Yang et al. 2023, MathGLM [2]
Genauigkeit bei mehrstelliger Multiplikation nach den Angaben des MathGLM-Papers: Spezialisiertes Training schlägt allgemeine Modellgröße deutlich [2].
Das zweite Ergebnis kommt aus der entgegengesetzten Richtung: Die Autoren von MathGLM zeigen, dass ein Modell mit nur zwei Milliarden Parametern mehrstellige Arithmetik nahezu fehlerfrei beherrscht, wenn es gezielt darauf trainiert wird - GPT-4 lag in ihrem Vergleich bei mehrstelliger Multiplikation bei 4,3 Prozent [2]. Die Lehre aus beiden Studien ist dieselbe: Arithmetik ist für allgemeine Sprachmodelle keine Nebensache, die mit der Größe kommt, sondern eine Fähigkeit, die man gezielt einbaut - oder auslagert.
Für Textaufgaben - „Lisa hat drei Äpfel mehr als …“ - hat OpenAI schon 2021 mit GSM8K einen eigenen Prüfstand aus achteinhalbtausend Schulaufgaben geschaffen und gezeigt, dass Verifikatoren die Lösungsquote deutlich heben: Ein separates Modell bewertet viele Lösungswege und wählt den besten [3]. Das Muster hält bis heute: Fortschritt bei Mathematik kommt aus schrittweisem Vorgehen, Prüfern und Werkzeugen - nicht aus bloßem Größenwachstum.
Was das für Zahlenprozesse bedeutet
In Controlling und Buchhaltung ist die Gefahr nicht die sichtbar falsche Zahl, sondern die plausible: eine Summe, die um 190 Euro daneben liegt, eine Umsatzsteuer, die 19 statt 7 Prozent annimmt, ein Durchschnitt über die falsche Gruppe. Weil das Modell seine Antwort nicht mit „ungefähr“ markiert, unterscheidet sich eine erfundene Zahl von einer gerechneten nur durch ihre Herkunft. Genau deshalb gilt in Zahlenprozessen eine härtere Regel als in Textprozessen: Keine Zahl aus dem Modell gilt, bevor sie nicht aus Quelldaten nachgerechnet ist.
Die vier Arbeitsregeln
- Modell formuliert, Werkzeug rechnet: Lass das Modell die Formel, den Code oder die Abfrage aufstellen - und führe sie mit einem Rechenwerkzeug aus. Über Function Calling ist das heute Standard.
- Quelldaten statt Gedächtnis: Übergib die Zahlen als Daten (Tabelle, JSON), nicht als Fließtext; je klarer die Struktur, desto weniger Raum für Zahlendreher.
- Gegenrechnung einbauen: Summen aus Positionen prüfen, Anteile gegen Gesamtwerte, Plausibilitätskorridore definieren - Regeln sind billiger als Fehler.
- Zweitmeinung bei Tragweite: Bei Zahlen, die in Buchung, Meldung oder Entscheidung gehen, gilt das Vier-Augen-Prinzip - ein Mensch oder ein zweites, unabhängiges Verfahren prüft nach.
Eine ehrliche Fußnote gehört dazu: Temperatur auf null drehen macht Antworten gleichförmiger, nicht richtiger - die Temperatur steuert die Streuung, nicht die Arithmetik. Und schrittweises Vorgehen (chain of thought) hebt die Trefferquote, beseitigt den Grundfehler aber nicht: Auch eine schöne Rechenkette kann am Ende eine falsche, überzeugend präsentierte Zahl tragen - das ist die Zahlenvariante der Halluzination.
Einordnung
Sprachmodelle sind Analphabeten der Arithmetik mit perfekter Aussprache: Sie lesen Rechnungen flüssig vor, ohne zu rechnen. Wer das akzeptiert und die Rechenarbeit an Werkzeuge delegiert, bekommt das Beste aus beiden Welten - das Modell als Übersetzer zwischen Problem und Formel, das Werkzeug als unbestechlichen Rechner. Wie diese Arbeitsteilung bei Belegen aussieht, zeigt der Beitrag zur Dokumentenanalyse; für die Auswertung von Marktdaten gelten zusätzliche Warnungen im Beitrag zu Marktdaten und Sentiment.
Methode
Grundlage sind drei Forschungsarbeiten: die ACL-2024-Studie zum asymmetrischen Fehlerbild bei Multiplikation, das MathGLM-Paper zu spezialisiertem Arithmetik-Training und die GSM8K-Arbeit zu Verifikatoren bei Textaufgaben. Alle Abstracts und Kennzahlen wurden am 20. Oktober 2026 an den verlinkten Quellen geprüft. Die Arbeitsregeln sind eine redaktionelle Ableitung aus diesen Befunden.
Grenzen
- Die zitierten Messwerte stammen aus den Papers und beziehen sich auf die dort getesteten Modelle und Aufgaben; aktuelle Modelle schneiden anders ab, das Grundmuster (Muster statt Rechenwerk) bleibt bestehen.
- Wir haben für diesen Beitrag keine eigene Testreihe durchgeführt; die Arbeitsregeln beruhen auf den zitierten Befunden und etablierter Praxis.
- Aussagen über konkrete Produkte und deren Werkzeugverhalten ändern sich mit jeder Version.
Quellen
- Language Models Do Hard Arithmetic Tasks Easily and Hardly Do Easy Arithmetic Tasks (Gambardella, Iwasawa, Matsuo), ACL Anthology (ACL 2024) (abgerufen 2026-10-20) ↩1 ↩2 ↩3
- GPT Can Solve Mathematical Problems Without a Calculator (MathGLM), arXiv (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4
- Training Verifiers to Solve Math Word Problems (GSM8K), arXiv (OpenAI) (abgerufen 2026-10-20) ↩1 ↩2