 KI
Red Teaming ist der TÜV mit bösen Fragen: Statt zu prüfen, ob ein KI-System das kann, was es soll, versucht es gezielt, das System zu Dingen zu bringen, die es nicht soll. Dieser Artikel beschreibt, wie du so eine Prüfung für eigene Systeme planst, durchführst und dokumentierst. Er baut auf dem Überblick über Angriffsmuster auf; die Gegenmaßnahmen stehen in Guardrails und sichere Prompts und in Sicherheit für Agenten-Systeme.
Was Red Teaming ist - und was nicht
Red Teaming bedeutet gezieltes Testen eines Systems auf Fehlverhalten durch Angriffsversuche - vor oder nach der Veröffentlichung. Es unterscheidet sich grundlegend vom Benchmarking: Ein Benchmark misst Fähigkeiten mit festen Aufgaben und festem Bewertungsverfahren, Red Teaming sucht offen und kreativ nach dem unbekannten Fehlverhalten einer ganz bestimmten Anwendung. Aus den Erfahrungen des Microsoft AI Red Team mit über hundert geprüften Generative-AI-Produkten lässt sich genau diese Trennung ablesen: Sicherheits- und Schadensfragen lassen sich nicht mit einer einmaligen Punktezahl beantworten, sondern nur im Zusammenspiel aus systematischen Tests und menschlicher Bewertung [3].
Auch der Begriff der Behörden spielt hinein: Das US-amerikanische NIST beschreibt im Generative-AI-Profil seines Risikomanagement-Rahmens (AI 600-1) Prüf-, Mess- und Bewertungsverfahren für generative KI - inklusive angriffsorientierter Tests als Baustein des Risikomanagements [2]. Red Teaming ist damit nicht Bastelei für Spezialisten, sondern ein anerkannter Teil seriöser Systempflege.
Umfang festlegen: vier Ebenen statt Bauchgefühl
Der GenAI Red Teaming Guide des OWASP empfiehlt einen ganzheitlichen Ansatz über vier Ebenen: die Bewertung des Modells selbst, den Test der Implementierung (Prompts, Werkzeuge, Schranken), die Prüfung der Infrastruktur und die Analyse des Verhaltens zur Laufzeit [1]. Für eine erste eigene Runde heißt das: Lege schriftlich fest, was überhaupt getestet wird - nur das Modell, die ganze Anwendung oder inklusive Serverzugängen - und was explizit außen vor bleibt. Diese Spielregeln ('Rules of Engagement') schützen beide Seiten: Das Team weiß, wie weit es gehen darf, und der Betreiber, was ihn erwartet.
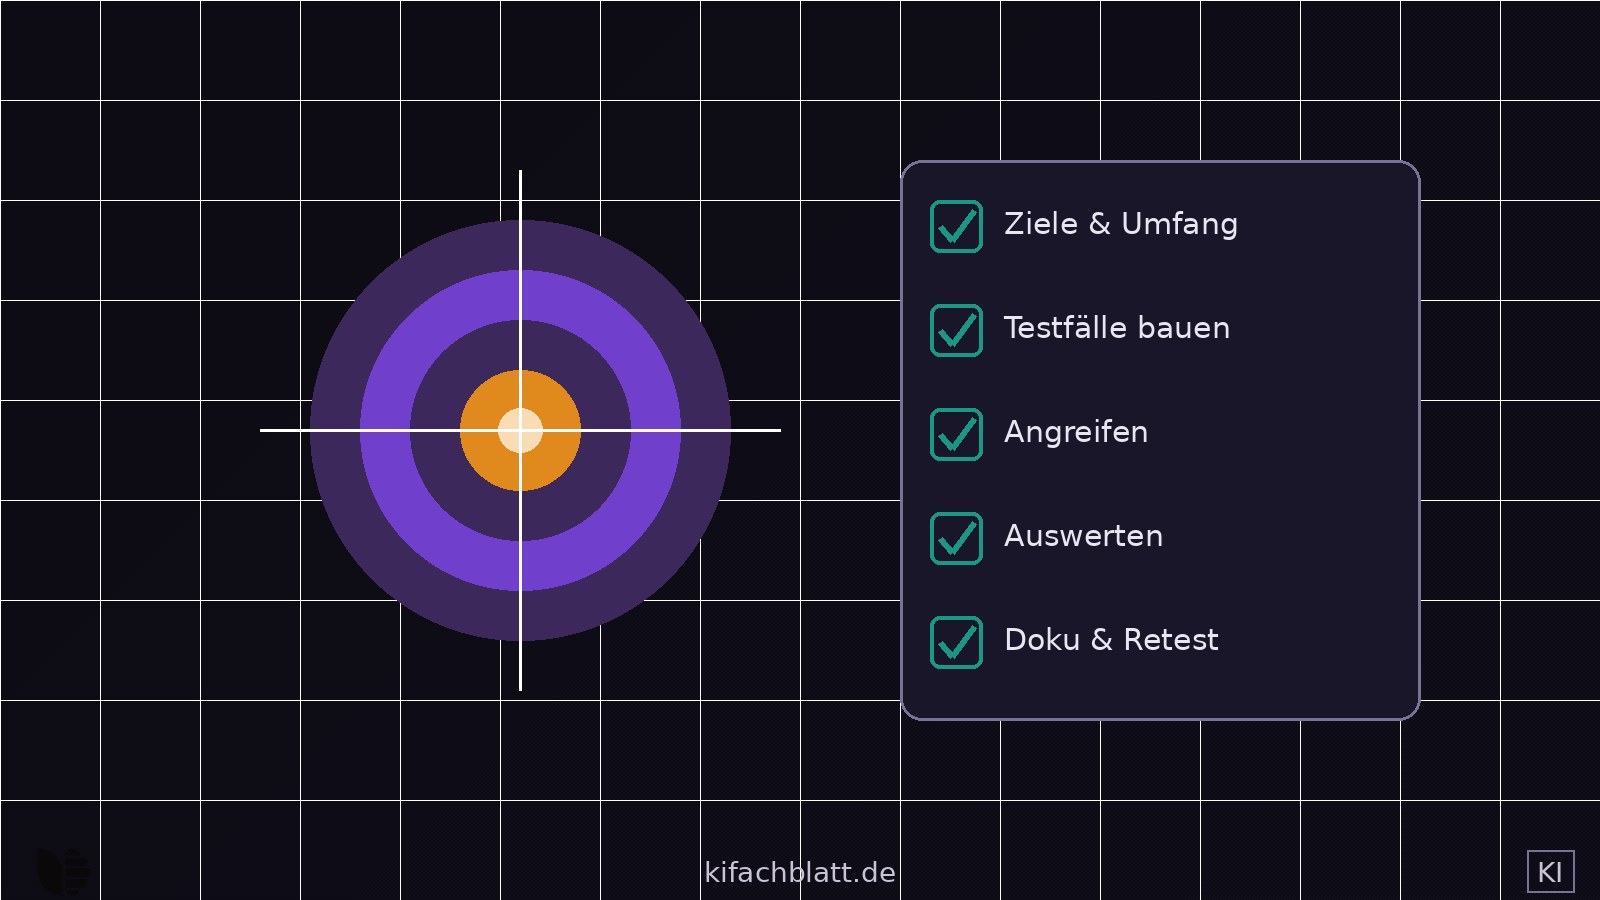
Vorgehen in fünf Schritten
- Ziele und Bedrohungsmodell festlegen: Welches Fehlverhalten wäre am schlimmsten - Datenabfluss, Rufschaden, rechtliche Verstöße, Kosten? Die Angriffsmuster liefern die Kandidatenliste; priorisiere nach Rechten und Daten deines Systems.
- Testfälle bauen: Aus jeder priorisierten Gefahr werden konkrete Szenarien - etwa 'Assistent mit E-Mail-Zugriff liest präparierte Nachricht'. Pro Szenario: erwartetes Fehlverhalten, Erfolgskriterium, Stoppregel.
- Angreifen - manuell und automatisiert: Menschliche Tester variieren Strategien und kombinieren Schritte; Werkzeuge übernehmen die Breite. Microsofts Open-Source-Framework PyRIT (Python Risk Identification Toolkit) orchestriert etwa mehrstufige Angriffsdialoge und protokolliert die Verläufe [4].
- Auswerten und einordnen: Pro Szenario zählt, ob das definierte Fehlverhalten eingetreten ist, wie schwer es wäre und wie zuverlässig es auftritt. Studien zu Red-Teaming-Methoden zeigen, dass Aufbau und Zählsystem der Versuche die Ergebnisse stark beeinflussen - Zählsystem und Kriterien also vorab festlegen [5].
- Dokumentieren, abdichten, erneut testen: Jeder Fund fließt in den Bericht, jede Gegenmaßnahme bekommt einen Wiederholungstest. Erst der Retest macht aus einem Fund eine geschlossene Lücke [1][2].
Mensch und Maschine: die richtige Mischung
Die Praxisberichte der großen KI-Labore zeigen übereinstimmend zwei Dinge: Automatisierung macht Red Teaming erst skalierbar, und sie ersetzt die Menschen nicht [3][5]. Automatisierte Läufe prüfen viele Varianten gleichförmig und liefern vergleichbare Zahlen - etwa wie oft eine Klasse von Angriffen gelingt. Menschliche Tester finden die Angriffe, an die vorher niemand dachte: neue Kombinationen, Mehrstufigkeit, kulturelle und sprachliche Fallen. Für kleine Teams heißt das: Beginne mit einer handschriftlichen Liste realistischer Szenarien aus deinem eigenen Betrieb, automatisiere erst, wenn die Liste stabil ist, und lass Ergebnisse immer von einer zweiten Person einordnen [1][3].
Dokumentation: aus Funden werden Lücken, die zu sind
Ein Red-Teaming-Bericht ist Arbeitsgrundlage, kein Trophäenschrank. Bewährt hat sich eine Tabelle pro Fund:
| Feld | Inhalt | Beispiel |
|---|---|---|
| Szenario | Kurzbeschreibung des Angriffsversuchs | Präparierte E-Mail an Assistenten mit Postfach-Zugriff |
| Ziel-Fehlverhalten | Was hätte nicht passieren dürfen | Weiterleitung von Postfach-Inhalten nach außen |
| Ergebnis | Eingetreten ja/nein, wie reproduzierbar | Ja, in 3 von 5 Versuchen |
| Schweregrad | Auswirkung im eigenen Kontext | Hoch: personenbezogene Daten betroffen |
| Gegenmaßnahme | Was wurde geändert | Rechte entzogen, Ausgabefilter ergänzt |
| Retest | Datum und Ergebnis der Wiederholung | 20.10.2026: Fehlverhalten nicht mehr aufgetreten |
Zwei Ergänzungen machen den Bericht langfristig nützlich: eine Versionsnummer des getesteten Systems (Modell, Prompts, Werkzeugliste) und eine Liste bewusst nicht getesteter Bereiche. Beides verhindert, dass ein alter Bericht falsche Sicherheit suggeriert, wenn das System längst weitergezogen ist.
Wie oft und wie tief?
Die richtige Tiefe hängt vom Risiko ab. Faustregel aus den zitierten Leitfäden: Je mehr Rechte, desto mehr Red Teaming [1][2]. Ein interner Chatbot ohne Werkzeuge kommt mit einer kleinen, regelmäßigen Runde realistischer Szenarien aus. Ein Agent mit Schreibzugriffen, Zahlungsfunktion oder Kundenkontakt braucht eine geplante Prüfung vor dem Start und nach jeder wesentlichen Änderung an Modell, Prompts oder Rechten. Red Teaming ist ein Dauerbetrieb mit wechselnder Schlagzahl - kein Häkchen, das man einmal setzt.
Methode
Gelesen wurden am 20. Oktober 2026 die Ressourcenseite des OWASP GenAI Red Teaming Guide (Version vom 22. Januar 2025), die NIST-Publikationsseite zum Generative-AI-Profil AI 600-1, die arXiv-Seiten der Studien 'Lessons From Red Teaming 100 Generative AI Products' (arXiv:2501.07238) und 'Red Teaming Language Models to Reduce Harms' (arXiv:2209.07858) sowie das PyRIT-Repository auf GitHub. Das Fünf-Schritte-Vorgehen und die Dokumentationsvorlage sind redaktionelle Verdichtungen dieser Quellen, keine zitierten Standards.
Grenzen
- Die genannten Leitfäden sind Empfehlungen ohne normativen Charakter; Branchen mit eigenen Prüfpflichten brauchen darüber hinaus Fachberatung.
- Werkzeuge und ihr Funktionsumfang entwickeln sich schnell weiter; die Beschreibung von PyRIT entspricht dem Repository-Stand vom 20. Oktober 2026.
- Dieser Artikel ersetzt kein professionelles Sicherheitsaudit für Systeme mit hohem Schutzbedarf.
Quellen
- GenAI Red Teaming Guide, OWASP GenAI Security Project (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile (NIST AI 600-1), NIST (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4 ↩5
- Lessons From Red Teaming 100 Generative AI Products (arXiv:2501.07238), arXiv (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4 ↩5
- PyRIT - Python Risk Identification Toolkit, Microsoft (GitHub) (abgerufen 2026-10-20) ↩1 ↩2
- Red Teaming Language Models to Reduce Harms: Methods, Scaling Behaviors, and Lessons Learned (arXiv:2209.07858), arXiv (abgerufen 2026-10-20) ↩1 ↩2