 KI
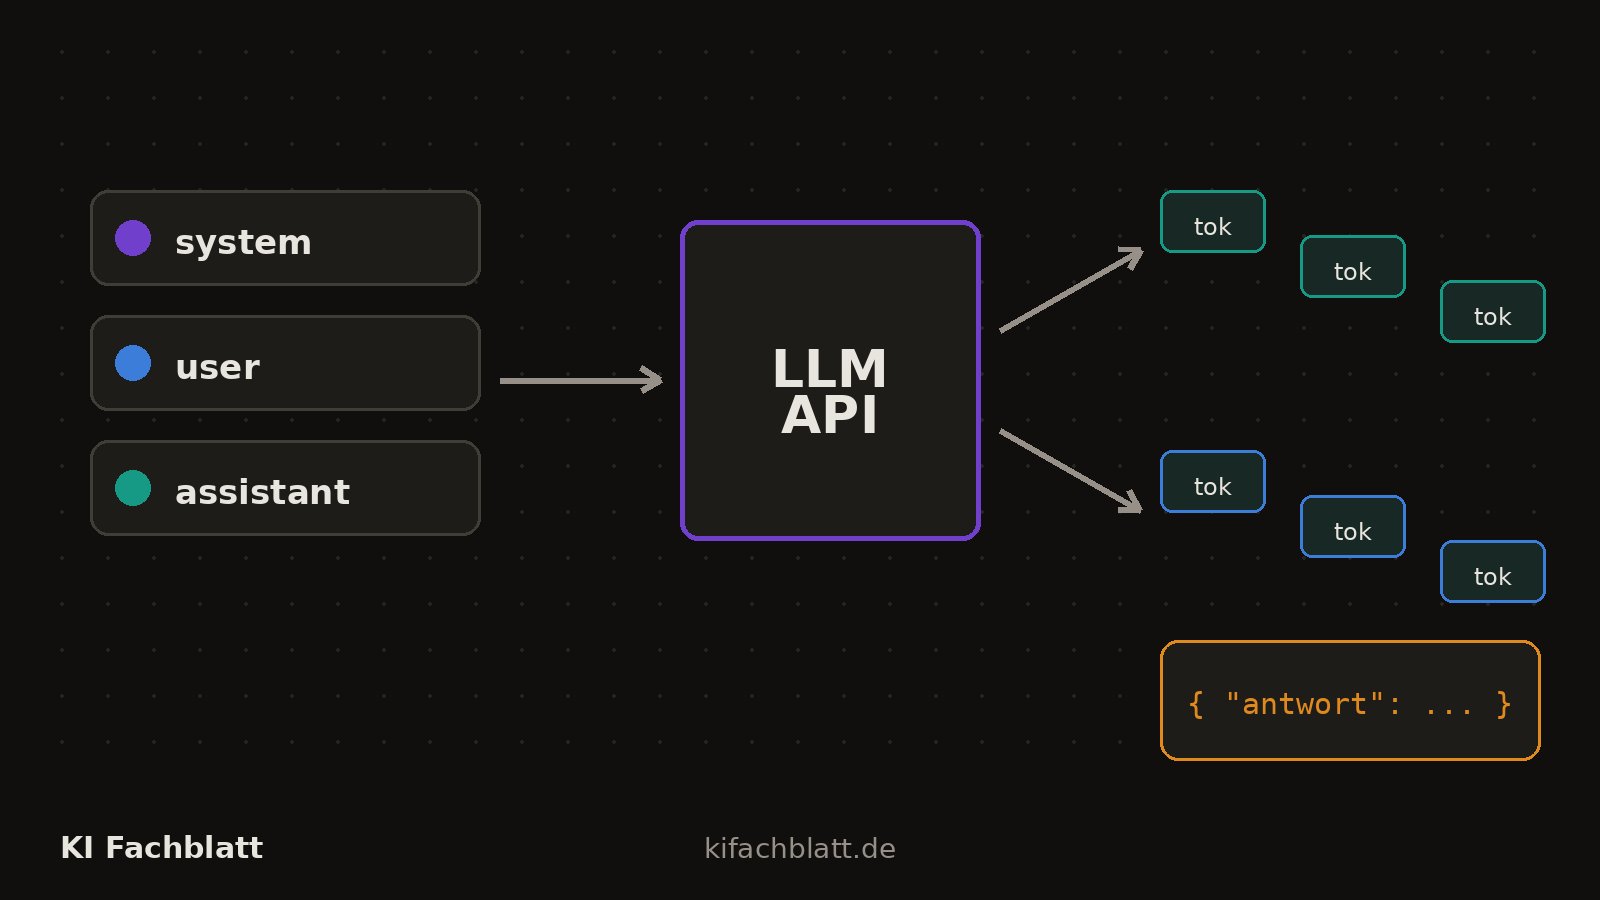
Wer mit Sprachmodellen Software baut, ruft sie nicht mehr im Chatfenster auf, sondern über eine HTTP-API. Die gute Nachricht vorweg: Die drei großen Anbieter OpenAI, Anthropic und Google haben ihre Schnittstellen inzwischen so ähnlich strukturiert, dass das Grundmuster überall dasselbe ist. Du schickst eine Liste von Nachrichten mit Rollen, dazu ein paar Steuerparameter, und bekommst Text, ein strukturiertes Objekt oder einen Werkzeugaufruf zurück. Dieser Artikel geht das Muster Stück für Stück durch: Aufbau eines Requests, die Parameter, die wirklich etwas verändern, Streaming für schnelle Oberflächen und Structured Output für alles, was ein Programm weiterverarbeiten muss.
Der erste Aufruf: Rollen, Nachrichten, Antwort
Der Kern jeder Anfrage ist das messages-Array. Jede Nachricht hat eine Rolle und Inhalt. Die Rolle system (bei OpenAI in neueren Modellen auch developer) trägt die Daueranweisung: Ton, Regeln, Ausgabeformat. user ist die Eingabe der Nutzerin oder des Nutzers, assistant die bisherigen Antworten des Modells. Die Konversation wird bei jedem Aufruf komplett mitgeschickt; die API ist zustandslos und merkt sich nichts. Wer "den Chat" speichert, bist du. [1][3]
Das hat zwei praktische Folgen. Erstens wächst die Rechnung mit der Gesprächslänge, denn jeder Aufruf bezahlt die gesamte Historie erneut als Input-Tokens (Details in Tokens, Kontext, Kosten). Zweitens kannst du die Historie frei redigieren: kürzen, zusammenfassen, Fehler entfernen. Der System-Prompt bleibt dabei der stabilste Anker; Anthropic empfiehlt, langsame, wiederverwendete Inhalte wie Systemanweisungen und Werkzeugdefinitionen vorne zu halten, weil sie sich so im Prompt-Cache wiederfinden (mehr dazu in Kosten- und Latenz-Tuning).
from anthropic import Anthropic

client = Anthropic()

response = client.messages.create(
    model="claude-opus-5",
    max_tokens=1024,
    system="Antworte sachlich und kurz.",
    messages=[
        {"role": "user", "content": "Erkläre Rekursion in zwei Sätzen."}
    ],
)
print(response.content)
Das Beispiel zeigt die Anthropic Messages API; bei OpenAI heißt der entsprechende Endpunkt Chat Completions beziehungsweise die neuere Responses API, das Schema ist aber deckungsgleich: Modellname, Nachrichtenliste, Limit für die Antwortlänge. [1][3]
Die Parameter, die wirklich etwas verändern
Die Referenzen der Anbieter listen Dutzende Felder. In der Praxis stellst du an vier Schrauben: max_tokens, Temperatur, top_p und Stopp-Sequenzen. Alles andere ist Feintuning oder Spezialfall. Nicht jedes Modell akzeptiert jeden Parameter; was für dein Modell gilt, steht in der jeweiligen Referenz. [1][3]
| Parameter | Wirkung | Praxiswert |
|---|---|---|
| max_tokens | Obergrenze für die Länge der Antwort; das Modell darf früher stoppen | Knappe Antworten: 300-800. Bei Anthropic Pflichtfeld [3] |
| temperature | Streut die Token-Auswahl; 0 ist fast deterministisch, hohe Werte variieren stark | Faktenarbeit 0-0,3; Brainstorming 0,7-1,0 |
| top_p | Begrenzt die Auswahl auf die wahrscheinlichsten Tokens, deren Masse p erreicht | Entweder temperature oder top_p drehen, nicht beide |
| stop | Liste von Zeichenketten, bei denen die Ausgabe sofort endet | Rollenmarken wie "User:" in Chat-Protokollen |
Die Temperatur ist der meistmissverstandene Regler. Sie ändert nicht, was das Modell weiß, sondern wie es aus seinen Möglichkeiten auswählt: Bei Temperatur 0 greift es fast immer zum wahrscheinlichsten nächsten Token, die Antwort wird reproduzierbar und nüchtern. Für Extraktion, Klassifikation und Code ist das der richtige Startpunkt. Kreatives Umformulieren verträgt höhere Werte. Wichtig: Auch Temperatur 0 macht aus einer falschen Tatsache keine richtige; der Regler steuert Stilistik und Variation, nicht Wahrheit.
Anthropic bietet zusätzlich top_k an, und seit den Reasoning-Modellen gibt es bei mehreren Anbietern Parameter für sichtbare Denkbudgets: In der Messages API heißt das Feld thinking mit einem budget_tokens-Wert, der mindestens 1.024 Tokens umfassen und unter max_tokens liegen muss; das Denkbudget zählt auf das Ausgabelimit. [3]
Streaming: Antworten in Häppchen
Ohne Streaming wartet deine Anwendung, bis die komplette Antwort fertig ist; bei einer 800-Token-Antwort sind das spürbar viele Sekunden. Mit stream: true liefert die API die Antwort als Server-Sent Events: Das Modell schickt jedes Token-Häppchen (delta) sobald es erzeugt ist, und die Oberfläche kann schon rendern, während hinten noch gerechnet wird. Anthropic arbeitet mit derselben Technik, ebenfalls als SSE-Stream. [1][3]
Gefühlt macht das die Anwendung deutlich schneller, gemessen wird sie es nicht: Die Gesamtdauer bis zum letzten Token bleibt gleich. Was sinkt, ist die wahrgenommene Wartezeit bis zum ersten sichtbaren Zeichen, im Englischen Time to First Token. Für Chat-Oberflächen ist Streaming deshalb Standard, für Hintergrundjobs meist überflüssig.
Zwei Details übersehen viele beim ersten Mal. Erstens der Verbrauch: Bei OpenAI enthält der Stream nur dann Token-Statistik, wenn du stream_options mit include_usage: true setzt; dann kommt ein letzter Chunk, dessen choices-Liste leer ist und der die usage-Werte trägt. Wird die Verbindung vorher abgebrochen, fehlt dieser Abschluss-Chunk und damit die Abrechnungsgrundlage im Stream; du musst die Tokens dann selbst schätzen oder die Antwort verwerfen. [1] Zweitens das Parsen: Wer Streaming nutzt, sollte die Deltas nur aneinanderhängen und nicht zwischendurch als fertigen Text behandeln; ein Wort kann über zwei Chunks geteilt sein.
Structured Output: Schema statt Hoffnung
Sobald ein Programm die Antwort weiterverarbeitet, reicht Fließtext nicht mehr. Der naive Weg ist "antworte als JSON" im Prompt; das funktioniert oft, aber nicht garantiert: Das Modell kann Kommentare drumherum setzen, ein Feld vergessen oder einen Enum-Wert erfinden. Genau dagegen ist Structured Output gebaut. OpenAI beschreibt den Nutzen so: Die Antwort folgt immer dem gelieferten JSON Schema, ohne dass du fehlerhafte Antworten validieren und wiederholen musst, und sicherheitsbedingte Ablehnungen werden programmatisch erkennbar. [2]
Technisch gibt es bei OpenAI zwei Einhängepunkte: Structured Outputs als Ausgabeformat über text.format mit type json_schema und strict: true, oder als Function-Calling-Schema, wenn das Modell ein Werkzeug mit genau diesen Argumenten aufrufen soll. Die Faustregel der Dokumentation: Soll das Modell mit deinem System reden (Funktionen, Daten, Aktionen), nimm Function Calling; soll es dem Nutzer strukturiert antworten, nimm das response_format beziehungsweise text.format. [2] Unterstützt wird das strikte Schema seit den Modell-Snapshots gpt-4o-2024-08-06 und gpt-4o-mini-2024-07-18 sowie allen neueren Modellen. [2]
Die anderen Anbieter lösen dasselbe Problem mit eigenen Namen. Bei Anthropic ist der etablierte Weg ein Werkzeug mit input_schema: Du definierst ein JSON Schema als Werkzeugeingabe und lässt das Modell dieses Werkzeug "aufrufen"; das Ergebnis ist schema-konformes JSON. [3] Google bietet Structured Outputs in der Gemini API direkt als Ausgabeformat an; dort lassen sich strukturierte Antworten auch streamen, und die gestreamten Chunks sind gültige partielle JSON-Strings, die aneinandergehängt das finale Objekt ergeben. [4]
JSON mode: der ältere, schwächere Bruder
Vor Structured Outputs gab es den JSON mode (text.format mit type json_object). Er garantiert nur, dass die Ausgabe syntaktisch gültiges JSON ist; ob sie zu deinem Schema passt, bleibt offen. Zwei Fallstricke aus der Dokumentation sind es wert, wörtlich gewusst zu werden: Im JSON mode musst du das Modell irgendwo im Kontext zur JSON-Ausgabe anweisen, sonst kann es endlos Leerraum erzeugen; die API bricht deshalb mit einem Fehler ab, wenn die Zeichenkette "JSON" nirgends im Kontext vorkommt. Und deine Anwendung muss Randfälle abfangen, in denen die Ausgabe kein vollständiges JSON-Objekt wird, etwa weil max_tokens zuschlägt. [2]
Eigene Rechnung: Was ein Request kostet
API-Preise werden pro Million Tokens getrennt nach Input und Output ausgewiesen. Nach der OpenAI-Preisliste vom 20. Oktober 2026 kostet das Mittelklasse-Modell GPT-5.6 Terra 2,00 US-Dollar pro Million Input-Tokens und 12,00 US-Dollar pro Million Output-Tokens; zwischengespeicherter (gecachter) Input liegt bei 0,20 US-Dollar. Das Flaggschiff GPT-5.6 Sol liegt bei 5,00 beziehungsweise 30,00 US-Dollar, das Spar-Modell GPT-5.6 Luna bei 0,20 beziehungsweise 1,20 US-Dollar. [5]
Eigene Rechnung dazu: Ein typischer Extraktions-Request mit 3.000 Input- und 800 Output-Tokens kostet bei Terra 3.000 × 2,00 $ / 1.000.000 + 800 × 12,00 $ / 1.000.000 = 0,0060 $ + 0,0096 $ = 0,0156 $, also etwa 1,6 Cent. Tausend solcher Aufrufe pro Tag summieren sich auf rund 15,60 $ täglich, knapp 470 $ im Monat. Dieselbe Rechnung mit Luna läge bei etwa 1,16 $ pro Tag. Der Hebel "Modellwahl" ist damit größer als jede Prompt-Kürzung; wie du außerdem mit Caching und Batch weitere 50 bis 90 Prozent holst, rechnen wir in Kosten- und Latenz-Tuning durch. [5]
Typische Fehler am Anfang
- Historie ungeprüft mitwachsen lassen: Jeder Aufruf bezahlt die ganze Konversation erneut; alte Ballast-Nachrichten kosten jedes Mal mit.
- Temperatur hochdrehen, um "bessere" Antworten zu bekommen: Der Regler ändert die Variation, nicht die Korrektheit; für Faktenarbeit ist 0 bis 0,3 der richtige Bereich.
- Fließtext parsen statt Structured Output: Ein Regex auf Prosa bricht beim ersten Kommentar des Modells; ein striktes Schema nicht. [2]
- Streaming ohne include_usage: Ohne den Abschluss-Chunk fehlt dir die Token-Abrechnung, und bei Abbruch stehst du ohne Verbrauchsdaten da. [1]
- max_tokens als Qualitätsziel lesen: Das Limit begrenzt nur die Länge; eine abgeschnittene Antwort sieht aus wie eine schlechte, ist aber eine unvollständige.
Der letzte Punkt verdient ein eigenes Warnwort: Eine bei max_tokens abgeschnittene JSON-Antwort ist exakt der Randfall, den die OpenAI-Dokumentation für den JSON mode nennt. Prüfe im Antwortobjekt den Stop-Grund; bei OpenAI heißt das Feld finish_reason, ein Wert wie length signalisiert den abgebrochenen Fall. [1]
Wie es weitergeht
Mit Request-Aufbau, Parametern, Streaming und Structured Output deckst du den Normalbetrieb ab. Der nächste Schritt ist, das Modell Dinge tun zu lassen: Function Calling und Werkzeugaufrufe erklärt die Schleife aus Werkzeugdefinition, Aufruf und Rückgabe. Wer danach Kosten und Geschwindigkeit drücken will, findet in Kosten- und Latenz-Tuning die Rechnungen zu Prompt-Caching, Batch API und Modellwahl. Und wenn deine Anwendung mit eigenem Wissen antworten soll, führt RAG selbst bauen durch Embeddings, Index und belegte Antworten.
Methode
Gelesen wurden am 20. Oktober 2026 die API-Referenz zu OpenAI Chat Completions, der OpenAI-Leitfaden zu Structured Outputs, die Anthropic-Referenz zur Messages API, die Google-Dokumentation zu Structured Outputs in der Gemini API und die OpenAI-Preisliste. Die Kostenrechnung ist eine eigene Überschlagsrechnung auf Basis der dort genannten Preise und als solche gekennzeichnet. Parameter-Tabellen geben Praxiswerte der Redaktion wieder, keine Herstellervorgaben. Der Text entstand mit KI-Unterstützung und wurde von der Redaktion verantwortet.
Grenzen
APIs und Preise ändern sich schnell; alle Produkt-, Feld- und Preisangaben beziehen sich auf den 20. Oktober 2026 und können kurzfristig überholt sein. Die Referenzen der Anbieter unterscheiden teilweise zwischen Modellgenerationen; was für ein konkretes Modell gilt, steht nur in der jeweils aktuellen Referenz. Wir haben die beschriebenen Aufrufe nicht jede Kombination aus Anbieter und Modell selbst durchgespielt. Praxiswerte in der Tabelle sind redaktionelle Erfahrungswerte, keine Messergebnisse.
Quellen
- Create chat completion (API Reference), OpenAI Platform Docs (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- Structured model outputs, OpenAI Platform Docs (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- Messages (API Reference), Anthropic Docs (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- Structured outputs, Google AI for Developers (abgerufen 2026-10-20) ↩
- OpenAI API Pricing, OpenAI (abgerufen 2026-10-20) ↩1 ↩2 ↩3