 KI
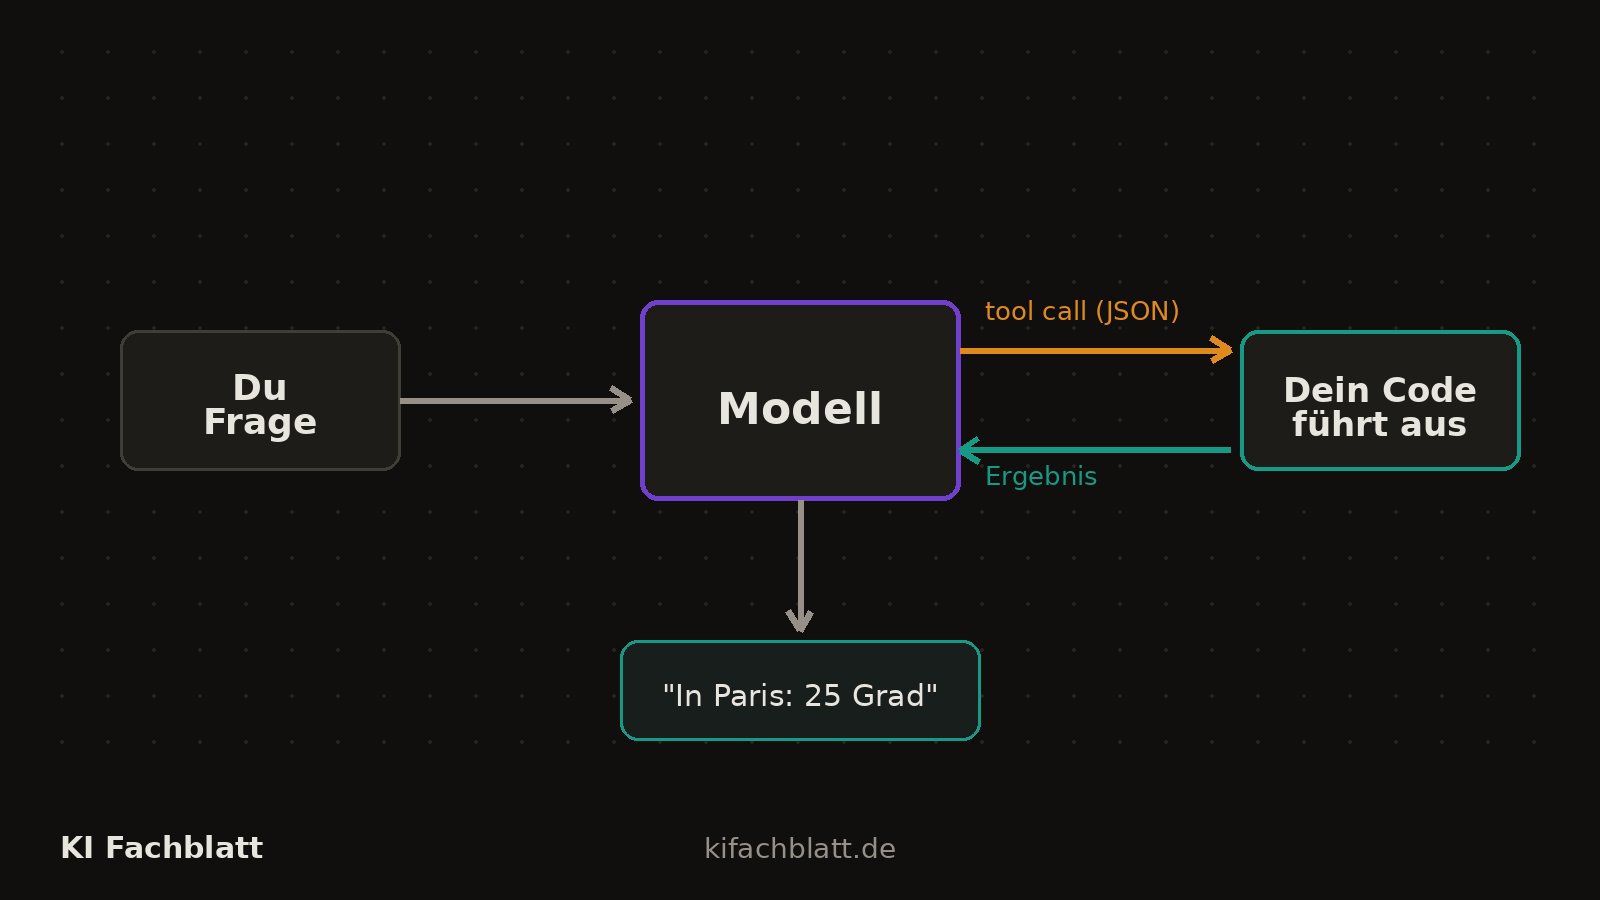
Ein Sprachmodell kann rechnen, schreiben und erklären, aber es kann nichts tun: keine E-Mail verschicken, keine Datenbank abfragen, keinen Termin eintragen. Function Calling schließt genau diese Lücke. Du beschreibst dem Modell eine Liste von Werkzeugen, und statt einer Textantwort bekommst du einen strukturierten Aufruf zurück: Werkzeugname plus Argumente als JSON. Ausgeführt wird der Aufruf von deinem Code, nicht vom Modell. Dieser Artikel zeigt den Mechanismus von der Definition bis zur Schleife, inklusive der Stellen, an denen Anfangsprojekte typischerweise scheitern.
Die Idee: Das Modell bestellt, dein Code liefert
Die Rollenverteilung ist der wichtigste Satz dieses Artikels: Das Modell entscheidet ob und mit welchen Argumenten ein Werkzeug gerufen wird, aber es führt nichts aus. Die OpenAI-Dokumentation beschreibt Function Calling als Brücke zwischen Modell und den Daten und Aktionen deiner Anwendung; Googles Dokumentation nennt drei Einsatzfelder: Aktionen in externen Systemen auslösen (Termine, Rechnungen, E-Mails), Wissen aus Datenbanken und APIs ergänzen und Fähigkeiten erweitern, etwa um einen Taschenrechner. [1][3]
Die Idee ist älter als die aktuellen APIs. Bereits 2023 zeigte der Toolformer von Meta AI, dass ein Sprachmodell selbstüberwacht lernen kann, welche API es wann mit welchen Argumenten ruft: Das Modell entschied selbst, ob es für eine Aufgabe den Rechner, die Suchmaschine, das Übersetzungssystem oder den Kalender brauchte, und verbesserte damit seine Null-Schuss-Ergebnisse deutlich. [4] Die heutigen Werkzeug-APIs sind die produktive, steuerbare Form desselben Prinzips: Du legst die Werkzeugliste fest, das Modell wählt daraus.
Die fünf Schritte der Aufruf-Schleife
Die OpenAI-Dokumentation beschreibt den Ablauf als mehrstufige Unterhaltung zwischen deiner Anwendung und dem Modell: [1]
- Du schickst eine Anfrage mit der Liste der verfügbaren Werkzeuge (Name, Beschreibung, JSON Schema der Argumente).
- Das Modell antwortet statt mit Text mit einem Werkzeugaufruf, etwa get_weather mit dem Argument location: Paris.
- Dein Code führt die Funktion mit diesen Argumenten wirklich aus.
- Du schickst das Ergebnis als neue Nachricht in einem zweiten Request zurück, verknüpft über die Aufruf-Kennung.
- Das Modell antwortet jetzt in Text ("In Paris sind es 25 °C") oder ruft das nächste Werkzeug.
Schritt fünf ist eine Schleife, kein Endpunkt: Die Anwendung kann so lange weitermachen, wie die Aufgabe Aufrufe erfordert. Aus fünf Schritten wird so ein Agent-Loop; die Architektur dahinter vertiefen wir in Agenten-Architekturen.
tools = [{
    "type": "function",
    "name": "get_weather",
    "description": "Aktuelles Wetter für einen Ort abrufen",
    "parameters": {
        "type": "object",
        "properties": {
            "location": {"type": "string", "description": "Stadt, z. B. Paris"},
            "unit": {"type": "string", "enum": ["celsius", "fahrenheit"]}
        },
        "required": ["location"]
    }
}]

# 1. Request mit tools -> 2. Modell antwortet mit tool call
# 3. Dein Code ruft get_weather(location="Paris") wirklich auf
# 4. Ergebnis {"temperature": "25", "unit": "celsius"} zurueck an die API
# 5. Modell antwortet: "In Paris sind es heute 25 Grad."
Client-Tools und Server-Tools
Bei Anthropic heißt die gleiche Mechanik Tool use, mit einer hilfreichen Zusatzunterscheidung: Client-Tools sind Funktionen, die du definierst und die in deiner Anwendung laufen. Das Modell antwortet mit stop_reason: tool_use und einem oder mehreren tool_use-Blöcken; dein Code führt aus und schickt das Ergebnis als tool_result-Block zurück. Server-Tools wie web_search, web_fetch, code_execution oder tool_search laufen dagegen auf Anthropics Infrastruktur; das Ergebnis kommt fertig in der Antwort, ohne dass dein Code etwas ausführt. [2]
Dieselbe Unterscheidung gibt es bei OpenAI zwischen eigenen Funktionen und den eingebauten Werkzeugen der Plattform (Websuche, Code-Ausführung, Zugriff auf MCP-Server). [1] Für die Architektur heißt das: Server-Tools sparen dir Infrastruktur, binden dich aber an das Sicherheits- und Datenmodell des Anbieters; Client-Tools geben dir volle Kontrolle über Rechte und Datenflüsse, kosten dich die Ausführungsschicht.
Werkzeugdefinitionen schreiben, die das Modell versteht
Das Modell sieht von deinem Werkzeug nur drei Dinge: Name, Beschreibung, Schema. Anhand dieser drei Texte entscheidet es, ob und wie es ruft. Anthropic empfiehlt ausdrücklich, Beschreibungen so detailliert wie möglich zu schreiben, weil das Modell umso besser trifft, je mehr es über Zweck und Argumente weiß. [2] Aus der Praxis der Redaktion: Der häufigste Grund für falsche Aufrufe ist keine Modellschwäche, sondern eine mehrdeutige Beschreibung. "Sucht Daten" lädt zu Fehlgriffen ein; "Sucht eine Bestellung anhand der Bestellnummer, Format BD-12345" nicht.
- Namen als Verb_Objekt: search_orders, create_invoice, nicht data oder helper.
- Beschreibung mit Einsatzzweck und Gegenbeispiel: wann das Werkzeug nicht gemeint ist.
- Enums, wo es wenige gültige Werte gibt: Das Modell kann keinen ungültigen Wert wählen, wenn das Schema ihn ausschließt.
- Pflichtfelder knapp halten: Jedes required-Feld ist ein Feld, das das Modell erraten muss, wenn der Nutzer es nicht nennt.
- Fehler als Ergebnis zurückgeben: Ein tool_result mit {"error": "Bestellung nicht gefunden"} lässt das Modell sauber reagieren statt zu raten.
Wenn die Werkzeugliste groß wird, entsteht ein zweites Problem: Jede Definition belegt Kontext in jeder Anfrage. OpenAI bietet dafür ab GPT-5.4 eine Werkzeugsuche (tool_search) an, die selten gebrauchte Werkzeuge zurückstellt und nur lädt, wenn das Modell sie braucht; Anthropic kennt mit tool_search ein entsprechendes Server-Tool. [1][2]
Sicherheit: Der Aufruf ist ein Vorschlag, kein Befehl
Ein Werkzeugaufruf ist ungeprüfter Modell-Output. Bevor dein Code ihn ausführt, gelten dieselben Regeln wie für jede Nutzereingabe: Argumente gegen das Schema validieren, Wertebereiche prüfen, Rechte prüfen. Besonders bei Werkzeugen mit Nebenwirkungen (senden, löschen, bezahlen) gehört eine menschliche Freigabe oder eine Regelschicht dazwischen; das Muster heißt Human-in-the-Loop. Wie du Werkzeugaufrufe zusätzlich gegen Prompt Injection aus gelesenen Inhalten absicherst, ist Thema von Sicherheit für Agenten-Systeme.
Typische Fehler
- Das tool_result vergessen: Ohne Ergebnis-Nachricht wartet das Modell auf Input, der nie kommt; die Kennung (tool_use_id beziehungsweise call_id) muss exakt passen. [1][2]
- Zu viele Werkzeuge auf einmal: Ab einem Dutzend Definitionen steigen Fehlgriffe und Kontextkosten; lieber bündeln oder Werkzeugsuche nutzen. [1]
- Nebenwirkungen ohne Freigabe: Ein send_email-Werkzeug ohne Bestätigungsschritt ist ein Unfall mit Ankündigung.
- Schema und Doku auseinanderlaufen lassen: OpenAI warnt ausdrücklich vor Abweichungen zwischen Schema und Beschreibung; das Modell liest beides. [1]
- Antwort parsen statt prüfen: Prüfe stop_reason beziehungsweise finish_reason; nur bei tool_use liegt ein Aufruf vor, sonst ist es normaler Text.
Wie es weitergeht
Function Calling ist das Fundament der Agenten-Themen dieses Magazins. Agenten-Architekturen baut daraus Planung, Gedächtnis und Orchestrierung; MCP verstehen und einsetzen zeigt den offenen Standard, mit dem Werkzeuge anwendungsübergreifend angeboten werden; und Coding-Agenten im Entwickleralltag beschreibt, was passiert, wenn die Werkzeugliste ein ganzes Terminal umfasst. Grundlagen zur API-Mechanik darunter liefert LLM-APIs in der Praxis.
Methode
Gelesen wurden am 20. Oktober 2026 die Leitfäden zu Function Calling und Tool use von OpenAI, Anthropic und Google sowie das Toolformer-Paper (Abstract und Einleitung). Die fünf Schritte der Aufruf-Schleife folgen der OpenAI-Dokumentation; die Client-/Server-Tool-Unterscheidung der Anthropic-Dokumentation. Die Praxisregeln zu Werkzeugdefinitionen sind redaktionelle Erfahrungswerte und als solche formuliert. Der Text entstand mit KI-Unterstützung und wurde von der Redaktion verantwortet.
Grenzen
Die Schnittstellen ändern sich schnell; alle Feldnamen und Modellvoraussetzungen beziehen sich auf den 20. Oktober 2026. Werkzeugverhalten ist modellabhängig und wurde nicht für jede Modell-Anbieter-Kombination selbst getestet. Die historische Einordnung stützt sich auf das Toolformer-Paper, nicht auf eine vollständige Forschungsgeschichte. Praxisfehler und Faustregeln sind Erfahrungswerte, keine gemessenen Fehlerraten.
Quellen
- Function calling, OpenAI Platform Docs (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- Tool use with Claude, Anthropic Docs (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- Function calling with the Gemini API, Google AI for Developers (abgerufen 2026-10-20) ↩
- Toolformer: Language Models Can Teach Themselves to Use Tools, arXiv:2302.04761 (Schick u. a., Meta AI, 2023) (abgerufen 2026-10-20) ↩1 ↩2