 KI
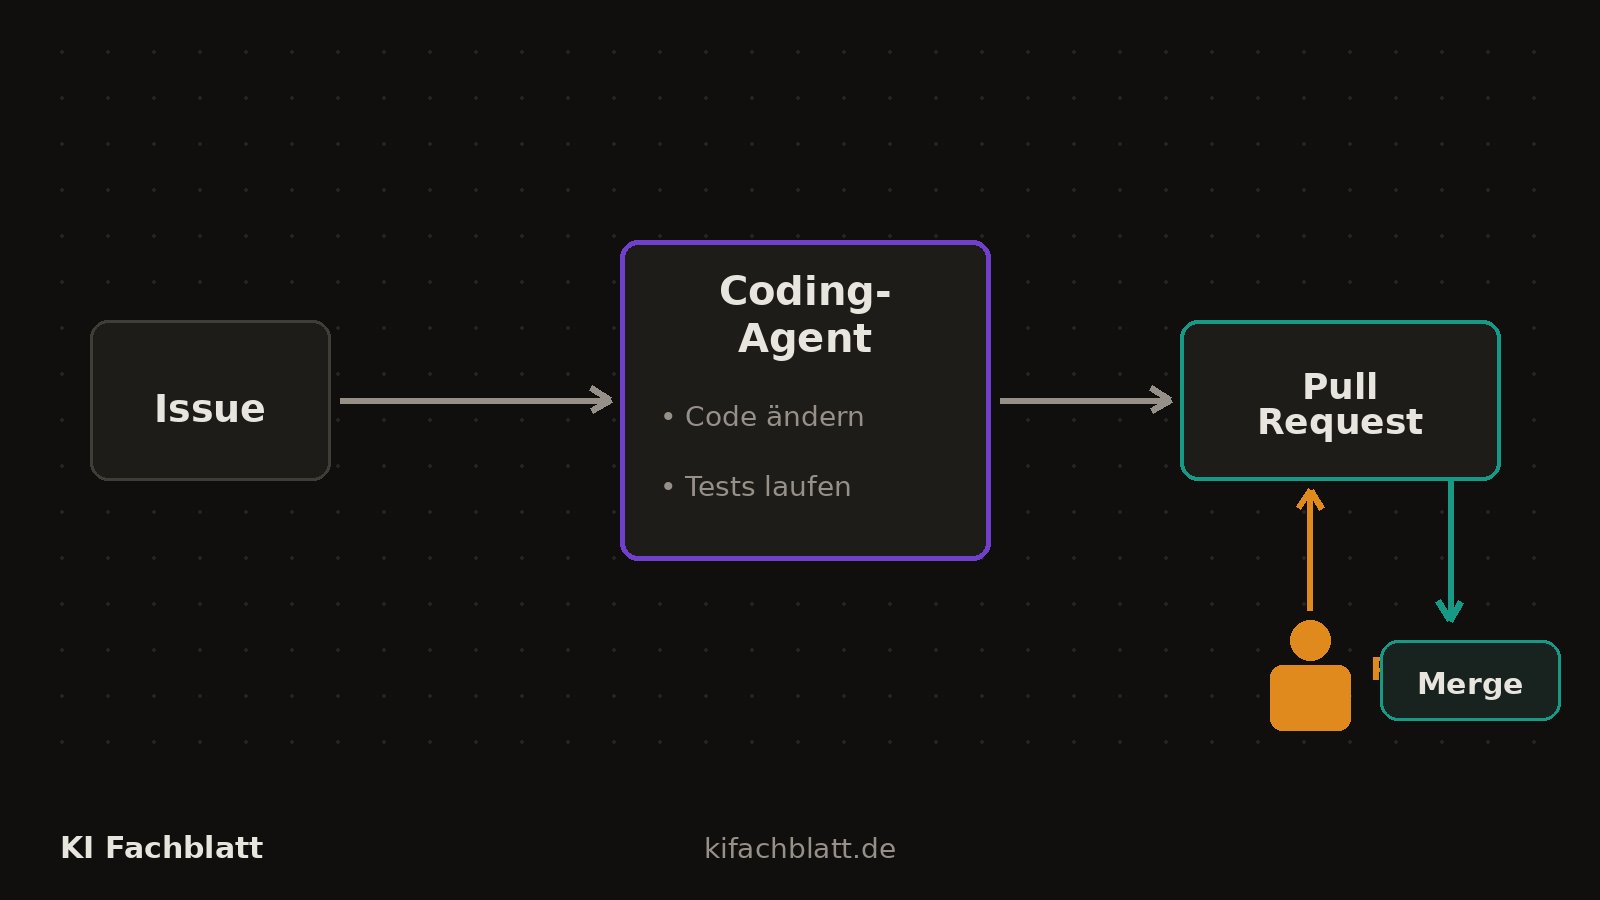
Von allen Agenten-Anwendungen ist keine so konkret geworden wie der Coding-Agent: ein KI-Agent, dessen Werkzeugkiste ein ganzes Entwicklungsprojekt ist, mit Dateisystem, Compiler, Testsuite und Versionskontrolle. Dieser Artikel ordnet den Alltag damit ein: wie die drei prominentesten Vertreter (Claude Code, GitHub Copilot coding agent, OpenAI Codex) heute arbeiten, was Benchmarks dazu sagen, und welche Betriebsregeln aus dem Werkzeug eine Hilfe statt einer Schrottmaschine machen. Die Architektur dahinter (Schleife, Planung, Werkzeuge) erklärt Agenten-Architekturen.
Wie die drei großen arbeiten
Claude Code ist Anthropics Agent für Terminal, VS Code, JetBrains, Desktop und Web. Die Dokumentation beschreibt die Kernaufgaben: aufgeschobene Arbeit automatisieren, Features bauen und Bugs fixen, Commits und Pull Requests erstellen, Werkzeuge per MCP anschließen, mehrere Agenten parallel laufen lassen, per CLI skripten und wiederkehrende Aufgaben planen. [1] GitHubs Copilot coding agent arbeitet eine Ebene höher im Prozess: Du weist ihm ein Issue zu (oder erwähnst @copilot in einem PR), er arbeitet im Hintergrund in einer flüchtigen, von GitHub Actions betriebenen Entwicklungsumgebung, durchsucht den Code, ändert ihn, führt automatisierte Tests und Linter aus und öffnet am Ende einen Pull Request, zu dem er dein Review anfordert; über PR-Kommentare lässt du ihn nachbessern. [2] OpenAIs Codex folgt demselben Grundmuster: Ziel oder Aufgabe formulieren, der Agent sammelt Kontext, handelt und liefert ein prüfbares Ergebnis. [4]
GitHub benennt die Aufgabenliste, für die der coding agent gedacht ist: Bugs fixen, kleinere Features, Testabdeckung erhöhen, Dokumentation aktualisieren, technische Schuld abbauen, Merge-Konflikte auflösen. Die Grenze zieht dieselbe Quelle gleich mit: Der Agent ist für den Rückstau an "nice to have"-Aufgaben und für Gerüstarbeit gedacht; Arbeit, die viel kreatives Denken verlangt, bleibt bei Menschen. [2]
Zwei Betriebsarten nicht verwechseln
GitHub selbst warnt vor der beliebtesten Begriffsverwechslung: Der Copilot coding agent ist nicht der Agent mode in der IDE. Der Agent mode editiert autonom direkt in deiner lokalen Entwicklungsumgebung, synchron, während du zusiehst. Der coding agent arbeitet autonom in einer GitHub-Actions-Umgebung, bekommt Aufgaben über Issues oder Chat und legt das Ergebnis als Pull Request vor. [2] Der Unterschied ist nicht akademisch: Lokal hat der Agent deine Rechte und deine ungespeicherten Dateien; in der Cloud eine frische, wegwerfbare Umgebung mit klarer Prüfschleife. Für Teams ist der PR-Fluss außerdem transparenter: Jeder Schritt landet in einem Commit und ist in den Logs sichtbar. [2]
Was die Benchmarks sagen
Die Standard-Messlatte ist SWE-bench: 2.294 echte GitHub-Issues aus 12 Python-Repositories, gemessen wird der Anteil gelöster Instanzen (% Resolved). Die häufig zitierte Teilmenge Verified umfasst 500 von Menschen geprüfte Aufgaben; daneben gibt es Lite (300 Aufgaben für günstigere Auswertung), Multilingual (300 Aufgaben aus 42 Repositories in neun Sprachen) und Multimodal (480 Aufgaben mit visuellen Elementen). [3] Unser Portrait zu SWE-bench Verified erklärt, warum die Verified-Teilmenge entstand, und das Terminal-Bench-2.1-Portrait zeigt die Terminal-Variante. Wichtig beim Lesen: Scores verschiedener Agenten-Setups auf demselben Benchmark sind nicht ohne Weiteres vergleichbar, weil Umgebung, Schrittlimit und Modellwahl variieren; Grundlagen liefert Modelle und Agenten richtig evaluieren.
Was Benchmarks nicht messen, ist der Alltagsgewinn: GitHub argumentiert, der coding agent übernehme die manuellen Schritte drumherum, Branch, Commit-Nachricht, Push, PR, Beschreibung, und schaffe Transparenz, weil alles auf GitHub passiert. [1][2] Das ist der eigentliche Produktivitätspunkt: nicht dass der Agent besser programmiert als du, sondern dass er die Plackerei um den Patch herum mit erledigt und parallel arbeiten kann, während du etwas anderes tust.
Setup: die Betriebsregeln, die den Unterschied machen
- Aufgaben schreiben wie für eine fremde Kollegin: Ziel, Akzeptanzkriterium, betroffene Dateien, was explizit nicht geändert werden soll. Der Agent liest das Issue wörtlich; Vagheit wird zu Halluzinations-Weitschweifigkeit.
- Tests als Wahrheitsquelle hinterlegen: Der Agent orientiert sich an dem, was grün werden kann; ohne Testsuite optimiert er auf Plausibilität.
- Klein schneiden: Ein Issue, ein PR, eine verantwortbare Änderung. Große Aufträge erzeugen große Diffs, und große Diffs reviewed niemand mehr ehrlich.
- Rechte begrenzen: Nur die Zugänge geben, die die Aufgabe braucht; produktive Zugänge und Geheimnisse gehören nicht in die Agenten-Umgebung (Grundregeln: Sicherheit für Agenten-Systeme).
- Review ernst nehmen: Diff lesen, Tests selbst laufen lassen, Randfälle fragen. Der PR ist ein Vorschlag, kein Ergebnis; die Verantwortung für den Merge trägt der Mensch. [2]
Typische Grenzen im Alltag
- Kontext, den der Agent nicht sehen kann: mündliche Absprachen, Doku im Kopf, Systeme außerhalb des Repos. Was nicht im Issue oder Code steht, existiert für ihn nicht.
- Leise falsche Fixes: Der Test wird grün, weil der Agent den Test anpasst, nicht den Fehler. Diff-Review muss Teständerungen besonders kritisch lesen.
- Kosten bei Dauerbetrieb: Agenten-Schleifen verbrennen Tokens pro Schritt; parallele Agenten auf losen Aufgaben sind ein Budget-Posten, kein Gratis-Feature (Rechnungshilfe: Kosten- und Latenz-Tuning).
- Veraltete Abhängigkeiten im Trainingswissen: Für brandneue Bibliotheksversionen braucht der Agent Websuche, Doku-Resources per MCP oder präzise Beispiele im Issue.
- Sicherheitslücken mit Selbstbewusstsein: Agents erzeugen plausiblen Code, auch unsicheren; Sicherheitsreview bleibt eigenes Gewerk.
Wie es weitergeht
Wer die Architektur-Muster hinter den Werkzeugen verstehen will, liest Agenten-Architekturen; wer eigene Werkzeuge für den Agenten anschließen will, MCP verstehen und einsetzen. Für die Langzeit-Perspektive (was Agenten über Stunden statt Minuten können) empfiehlt sich unsere Analyse der LHTB-2 Langzeit-Benchmark.
Methode
Gelesen wurden am 20. Oktober 2026 die Übersichtsseiten von Claude Code, Copilot coding agent und Codex sowie die SWE-bench-Leaderboard-Seite mit den Benchmark-Umfängen. Die Betriebsregeln und die Grenzenliste sind redaktionelle Erfahrungswerte; die Junior-Entwickler-Formel ist ein bewusstes Bild der Redaktion, keine Anbieter-Aussage. Der Text entstand mit KI-Unterstützung und wurde von der Redaktion verantwortet.
Grenzen
Die Werkzeuglandschaft ändert sich wöchentlich; alle Produktaussagen beziehen sich auf die Dokumentationsstände vom 20. Oktober 2026. Wir zitieren bewusst keine konkreten Benchmark-Scores, weil sie von Agenten-Setup, Modellversion und Umgebung abhängen und schnell überholen. Die Betriebsregeln sind Erfahrungswerte, keine gemessene Wirkungsstudie. Codex-Details stammen nur aus der Übersichtsseite, nicht aus einer eigenen Erprobung.
Quellen
- Claude Code: Overview, Anthropic Docs (abgerufen 2026-10-20) ↩1 ↩2 ↩3
- About GitHub Copilot coding agent, GitHub Docs (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- SWE-bench Leaderboards, swebench.com (abgerufen 2026-10-20) ↩1 ↩2
- Codex: Overview, OpenAI Developers (abgerufen 2026-10-20) ↩1 ↩2