 KI
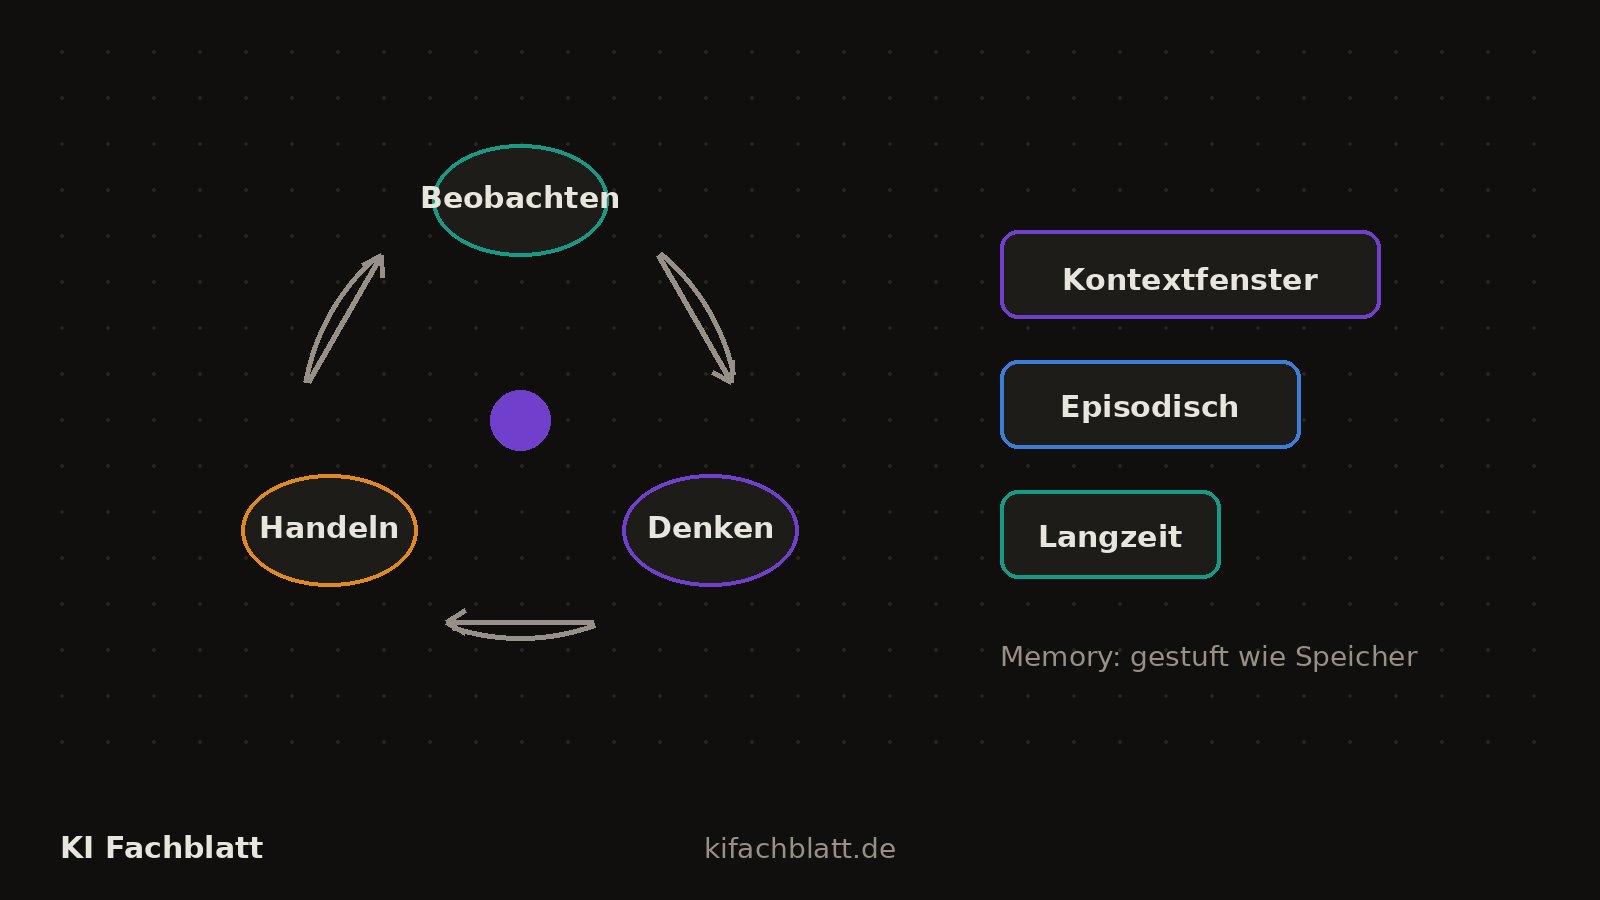
Was ein KI-Agent wirklich ist, klärt die Begriffsseite dieses Magazins: ein Modell, das in einer Schleife Werkzeuge benutzt. Dieser Artikel geht eine Ebene tiefer und beantwortet die Baufrage: Aus welchen Komponenten besteht so ein Agent, welche Muster für Planung und Memory haben sich bewährt, und wann lohnt Orchestrierung mehrerer Modelle? Die Quellenlage ist ungewöhnlich gut: Die zentralen Muster stammen aus peer-reviewten Arbeiten, und mit Anthropics Praxisbericht liegt eine ehrliche Industrie-Erfahrung vor, die erstaunlich oft zur einfachsten Lösung rät. [5]
Der Agent-Loop als Fundament
Jeder Agent läuft in derselben Schleife: Der aktuelle Zustand geht ins Modell, das Modell entscheidet den nächsten Schritt, ein Werkzeug führt ihn aus, das Ergebnis erweitert den Zustand, und es geht von vorne los, bis die Aufgabe gelöst oder ein Abbruchkriterium erreicht ist. Der Agent-Loop klingt trivial, aber zwei Entwurfsentscheidungen bestimmen alles Weitere: Was steht im Zustand (volle Historie, Zusammenfassung, strukturierte Notizen?), und wer beendet die Schleife (das Modell, ein Schrittlimit, ein Budget?).
Die einflussreichste Form dieser Schleife ist ReAct (Yao u. a., 2022): Das Modell schreibt abwechselnd Gedanken (reasoning traces) und Aktionen. Die Gedanken helfen ihm, Pläne zu bilden, zu verfolgen und bei Fehlern umzuschwenken; die Aktionen holen Information aus der Welt, etwa aus einer Wikipedia-API. In den Experimenten überwand ReAct auf HotpotQA und Fever das typische Halluzinieren und Fehler-Fortschreiben reiner Gedankenketten, und auf den interaktiven Umgebungen ALFWorld und WebShop schlug es Imitations- und Verstärkungslernen-Ansätze um absolute 34 beziehungsweise 10 Prozentpunkte Erfolgsrate, mit nur ein bis zwei Beispielen im Kontext. [1]
Workflow oder Agent?
Anthropic zieht in seinem Praxisbericht eine Trennlinie, die jede Architektur-Diskussion sortiert: Workflows sind Systeme, in denen Modelle und Werkzeuge über fest codierte Pfade laufen; Agenten sind Systeme, in denen das Modell seinen Ablauf und Werkzeugeinsatz selbst steuert. Die Empfehlung der Autoren nach Dutzenden Kundenprojekten: Suche die einfachste Lösung und erhöhe die Komplexität nur bei Bedarf; für viele Anwendungen reicht ein einzelner, gut gebauter Aufruf mit Abruf und Beispielen. Agenten-Systeme tauschen Latenz und Kosten gegen Aufgabenleistung, und dieser Tausch muss sich rechnen. [5]
Der Bericht benennt die erprobte Leiter der Workflow-Muster: Prompt Chaining (Schritte in Reihe mit programmatischen Prüfpunkten dazwischen), Routing (Eingaben klassifizieren und an spezialisierte Folgeaufgaben leiten, etwa einfache Fragen ans kleine, schwere ans große Modell), Parallelisierung (unabhängige Teilaufgaben gleichzeitig oder dieselbe Aufgabe mehrfach für Sicherheit), Orchestrator-Workers (ein zentrales Modell zerlegt dynamisch, Arbeiter führen aus, der Orchestrator synthetisiert) und Evaluator-Optimizer (ein Modell erzeugt, ein zweites bewertet, in einer Schleife). Erst danach kommen autonome Agenten. [5]
| Muster | Idee | Wann es trägt |
|---|---|---|
| Augmented LLM | ein Modell plus Abruf, Werkzeuge, Memory | Standardbaustein für fast alles |
| Prompt Chaining | feste Schrittfolge mit Gates | klare, zerlegbare Abläufe |
| Routing | klassifizieren und verteilen | getrennt behandelbare Eingabetypen |
| Parallelisierung | teilen oder mehrfach laufen lassen | Tempo oder Abstimmung nötig |
| Orchestrator-Workers | Planer zerlegt dynamisch, Arbeiter liefern | Zerlegung vorher nicht bekannt |
| Evaluator-Optimizer | Erzeuger und Prüfer im Wechsel | klare Bewertungskriterien vorhanden |
| Agent | Modell steuert selbst bis zum Ziel | offene Aufgaben, unvorhersehbare Schrittzahl |
Planung: drei Stufen des Nachdenkens
Stufe eins ist die lineare Gedankenkette: Das Modell denkt Schritt für Schritt nach, bevor es handelt. Stufe zwei ist Suche: Tree of Thoughts (Yao u. a., 2023) lässt das Modell mehrere Gedankenpfade parallel erkunden, Zwischenstände selbst bewerten und bei Sackgassen zurückspringen. Im Game of 24 stieg die Erfolgsrate von 4 Prozent (GPT-4 mit Gedankenkette) auf 74 Prozent (ToT); die Autoren nennen das bewusstes, über Pfadentscheidungen verhandelndes Problemlösen. [4] Der Preis: Viele zusätzliche Modellaufrufe pro Aufgabe. ToT lohnt sich dort, wo frühe Entscheidungen teuer kippen, nicht für Routinefragen.
Stufe drei ist Lernen aus dem eigenen Versuch, ohne das Modell umzutrainieren: Reflexion (Shinn u. a., 2023) verwandelt das Feedback der Umgebung (bestanden/nicht bestanden, Fehlermeldungen) in einen sprachlichen Selbstbericht, den der Agent in einen episodischen Speicher legt und beim nächsten Versuch mitliest. Im Paper erreichte der Reflexion-Agent 91 Prozent pass@1 auf dem Programmier-Benchmark HumanEval und übertraf damit das damalige GPT-4 mit 80 Prozent. [2] Die Zahlen stammen aus den Papers und sind auf deren Testbeds bezogen; die Muster dahinter (denken, suchen, reflektieren) sind das Übertragbare.
Memory: das Betriebssystem-Problem
Das Kontextfenster ist der Arbeitsspeicher des Agenten: schnell, teuer, begrenzt. Alles, was dauerhaft bleiben soll (Nutzerdaten, Zwischenergebnisse, gelernte Fehler), braucht eine zweite Ebene. MemGPT (Packer u. a., 2023) hat die Analogie explizit gemacht: Wie ein Betriebssystem mit virtuellem Speicher zwischen RAM und Platte verwaltet, soll der Agent zwischen Kontextfenster und externem Speicher selbst Seiten ein- und auslagern; die Autoren zeigten das an Dokumentanalyse jenseits des Kontextlimits und an Chat-Verläufen über viele Sitzungen. [3]
Praktisch landest du bei drei Speicherarten: dem Gesprächspuffer im Kontext (flüchtig), einem episodischen Speicher für Ereignisse und Reflexionen (meist als Datenbanktabelle oder Vektorindex, siehe RAG selbst bauen) und einem semantischen Speicher für Fakten (ebenfalls abrufbar). Die Falle ist Selbstvergiftung: Ein falscher Eintrag im Memory wandert in jede künftige Entscheidung. Schreib deshalb nur geprüfte Ergebnisse ins Langzeitgedächtnis, und protokolliere Herkunft und Zeitpunkt jedes Eintrags.
Orchestrierung: mehrere Modelle, ein System
Multi-Agent-Systeme verteilen Rollen: ein Planer, mehrere Spezialisten, ein Prüfer. Anthropics Orchestrator-Workers-Muster ist die zahme Form davon; wilde Formen mit frei chattenen Agenten erzeugen vor allem eins: mehr Tokens. Die Regel aus dem Praxisbericht gilt auch hier: Frameworks erleichtern den Start, verdecken aber Prompts und Antworten und laden zu Komplexität ein, die eine einfachere Lösung überflüssig gemacht hätte; die Autoren raten, mit den rohen LLM-APIs zu beginnen und jedes Framework zu verstehen, bevor man es einsetzt. [5]
Sicherheit von Anfang an
Ein Agent mit Werkzeugen ist ein Programm, das ungeprüfte Eingaben (Webseiten, E-Mails, Dokumente) in Aktionen übersetzt. Die drei Grundregeln: minimale Rechte pro Werkzeug, menschliche Freigabe bei Nebenwirkungen (Human-in-the-Loop) und eine isolierte Ausführungsumgebung (Sandboxing). Der vertiefende Artikel dazu ist Sicherheit für Agenten-Systeme; wie Agenten unter realen Bedingungen gemessen werden, zeigt unsere Analyse der LHTB-2 Langzeit-Benchmark.
Wie es weitergeht
Die Werkzeugebene unter diesen Mustern erklärt Function Calling und Werkzeugaufrufe; der Standard, über den Werkzeuge heute anwendungsübergreifend angedockt werden, ist Thema von MCP verstehen und einsetzen. Der Praxistest für alles hier: Coding-Agenten im Entwickleralltag.
Methode
Gelesen wurden am 20. Oktober 2026 die Abstracts und Einleitungen der vier genannten Papers sowie der vollständige Praxisbericht von Anthropic einschließlich der Workflow-Muster. Die Muster-Tabelle verdichtet den Bericht; Prozentzahlen stammen aus den Papers und sind auf deren Testumgebungen bezogen. Die Memory-Dreiteilung und die Sicherheitsregeln sind redaktionelle Einordnung. Der Text entstand mit KI-Unterstützung und wurde von der Redaktion verantwortet.
Grenzen
Die Paper-Zahlen (34/10 Prozentpunkte, 74 Prozent, 91 Prozent) stammen aus den jeweiligen Testumgebungen von 2022/2023 und sagen wenig über heutige Modelle und deine Aufgabe aus. Der Anthropic-Bericht ist eine Anbieter-Perspektive vom Dezember 2024; der dortige Werkzeug-Überblick ist teilweise überholt, die Architektur-Muster aber stabil. Wir haben keines der Muster für diesen Artikel neu implementiert oder gemessen. Die Memory-Dreiteilung ist eine pragmatische Einordnung, keine Standardtaxonomie.
Quellen
- ReAct: Synergizing Reasoning and Acting in Language Models, arXiv:2210.03629 (Yao u. a., ICLR 2023) (abgerufen 2026-10-20) ↩1 ↩2
- Reflexion: Language Agents with Verbal Reinforcement Learning, arXiv:2303.11366 (Shinn u. a., NeurIPS 2023) (abgerufen 2026-10-20) ↩1 ↩2
- MemGPT: Towards LLMs as Operating Systems, arXiv:2310.08560 (Packer u. a., 2023) (abgerufen 2026-10-20) ↩1 ↩2
- Tree of Thoughts: Deliberate Problem Solving with Large Language Models, arXiv:2305.10601 (Yao u. a., NeurIPS 2023) (abgerufen 2026-10-20) ↩1 ↩2
- Building effective agents, Anthropic Engineering (19.12.2024) (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6