 KI
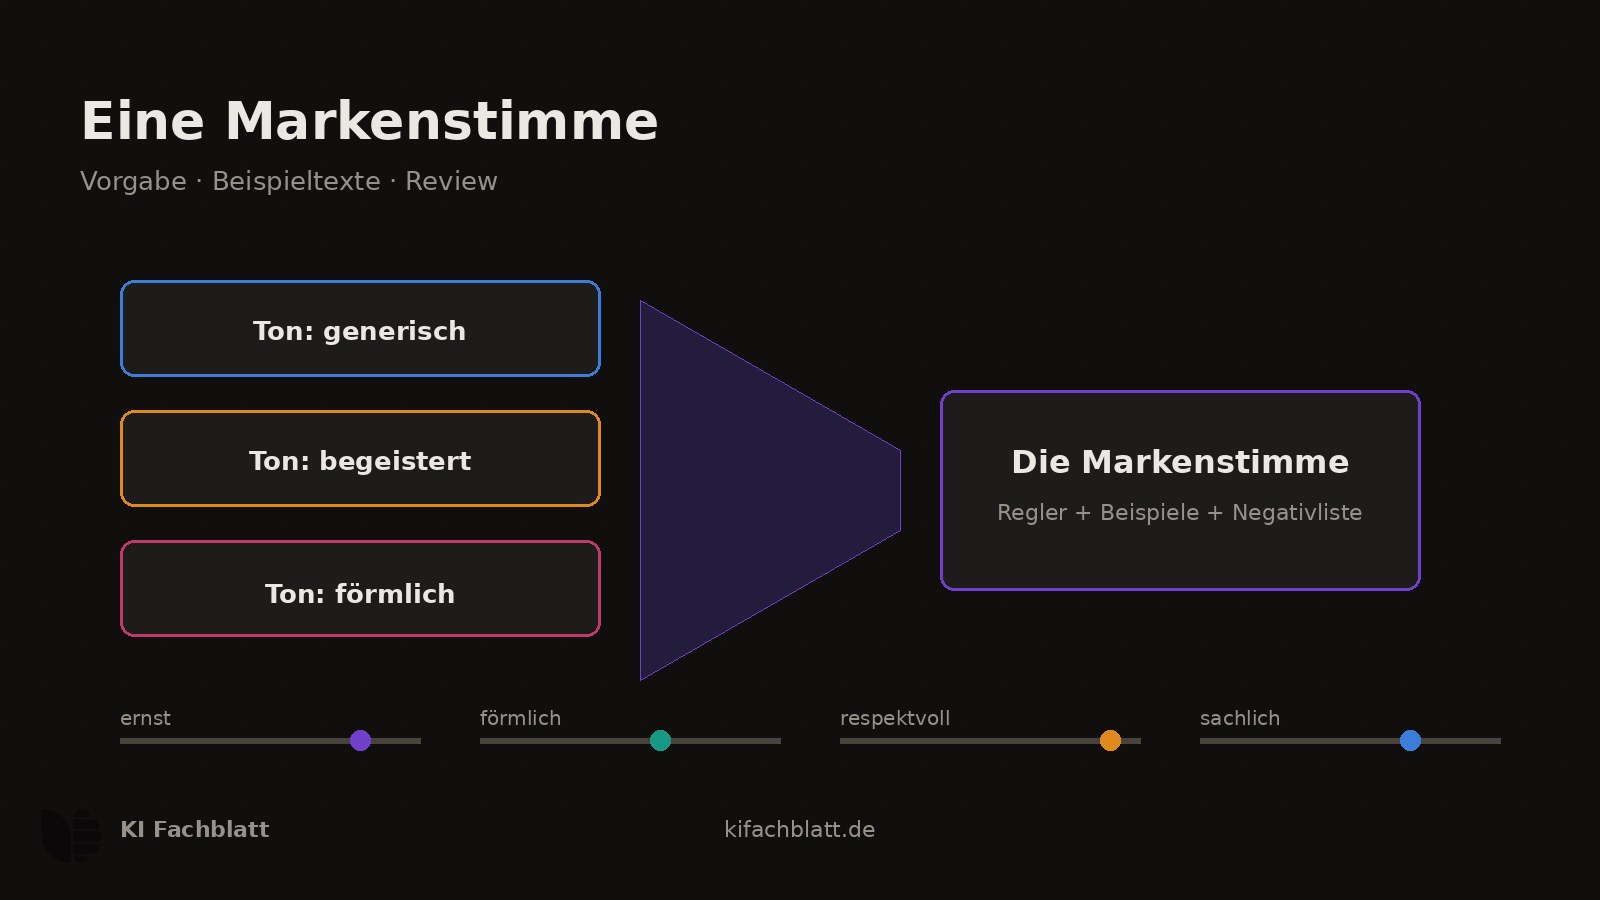
Wer drei verschiedene Modelle bittet, eine Produktankündigung zu schreiben, bekommt drei überraschend ähnliche Texte: freundlich, aufgeräumt, austauschbar. Das ist kein Zufall, sondern Statistik. Sprachmodelle reproduzieren den Durchschnitt dessen, was in ihren Trainingsdaten als guter Text gilt, und werden zusätzlich darauf trainiert, zu gefallen; die Neigung, dem Gegenüber nach dem Mund zu reden, hat als Sycophancy einen eigenen Forschungsbegriff. Eine Marke aber lebt vom Gegenteil: von wiedererkennbarer Abweichung. Markenkonsistenz mit KI ist deshalb keine Modellfrage, sondern eine Führungsfrage: Die Stimme muss so genau vorgegeben werden, dass ein Werkzeug ohne Gedächtnis für die Marke sie treffen kann.
Schritt 1: Die Stimme messbar machen
Die meisten Stilguides scheitern an Adjektiven: sympathisch, modern, hochwertig. Solche Worte hat jeder gelesen und jeder versteht anders, das Modell eingeschlossen. Nielsen Norman Group hat für Tonalität ein arbeitsfähiges Gerüst beschrieben: Vier Dimensionen, auf denen sich jede Stimme verorten lässt: witzig gegen ernst, förmlich gegen locker, respektvoll gegen respektlos, enthusiastisch gegen sachlich [1]. Der Nutzen ist praktisch: Statt der Marke ist humorvoll steht auf dem Regler humorvoll auf 2 von 10, nur trockene Formulierungen, keine Wortspiele. Was auf einem Regler steht, kann ein Briefing transportieren, ein Modell umsetzen und ein Reviewer prüfen.
Schritt 2: Beispiele statt Beschreibungen
Selbst die beste Reglerposition bleibt eine Beschreibung. Wirksamer ist das Material, aus dem Sprachmodelle nun einmal lernen: Beispiele. Drei bis fünf reale Texte im eigenen Ton, etwa die beste Kundenmail des letzten Jahres und ein Absatz aus der eigenen Website, schlagen jede Stilbeschreibung. Im Prompt wirken sie wie Few-Shot-Beispiele: Das Modell setzt das Muster fort, statt eine Anweisung zu interpretieren. Aus derselben Sammlung lassen sich auch Gegenbeispiele bauen, typische Modellfloskeln, die die Marke nie verwenden würde; die Negativliste ist oft kürzer und eindeutiger als die Positivliste.
Schritt 3: Die Vorgabe dauerhaft hinterlegen
Stilvorgaben gehören nicht in jeden Auftrag neu getippt, sondern in die dauerhaften Anweisungen der Werkzeuge. Bei ChatGPT dienen die Custom Instructions dazu: dauerhafte Angaben zu Kontext und gewünschter Antwortform, die für alle Unterhaltungen gelten [4]. Bei Claude lassen sich über die Personalisierungsfunktionen ebenfalls dauerhafte Anweisungen setzen; die bislang für Stilvorgaben genutzten Styles wurden im Juni 2026 in sogenannte Skills überführt, bestehende Styles werden automatisch migriert [2][3]. Für Teams heißt das: Die Markenstimme wird einmal als Paket aus Reglern, Beispieltexten und Negativliste gepflegt und in allen genutzten Werkzeugen hinterlegt, statt als Folklore in Köpfen zu wohnen. Wer mit APIs arbeitet, legt dieselbe Vorgabe in den System-Prompt.
Schritt 4: Review und Rückspielung
Keine Vorgabe hält von allein. Modelle ändern sich mit Updates, und selbst ein stabiles Modell driftet in langen Unterhaltungen Richtung Durchschnittston. Deshalb gehört der Ton-Check in dasselbe Review wie der Fakten-Check: Klingt der Entwurf nach uns oder nach dem Modell? Zwei Gewohnheiten machen die Prüfung billig und wirksam. Erstens die Blindprobe: Entwürfe gelegentlich ohne Herkunftsangabe lesen; wer Marke und Modell nicht auseinanderhalten kann, hat ein Tonproblem. Zweitens die Rückspielung: Jede gefundene Abweichung wird nicht nur korrigiert, sondern als Regel oder Beispiel in die Vorgabe zurückgespielt. So wird der Stilguide zu einem lernenden Bestand statt zu einem Dokument, das einmal geschrieben und nie geöffnet wird. Die Pflege-Mechanik entspricht der einer Prompt-Bibliothek: Beispiele, Testdatum, regelmäßige Durchsicht.
Grenzen: Was KI nicht konsistent halten kann
Ehrlichkeit gebietet drei Einschränkungen. Erstens: Je ungewöhnlicher die Markenstimme, desto mehr Review bleibt nötig; der Durchschnittston ist nun mal der Modus, in dem Modelle am stärksten sind. Zweitens: Konsistenz ist nicht nur Ton, sondern auch Haltung, welche Themen die Marke besetzt und welche nicht; diese Entscheidung kann kein Werkzeug treffen. Drittens: Eine Markenstimme, die es vor der KI-Nutzung nicht schriftlich gab, entsteht nicht durch KI; das Werkzeug macht eine vorhandene Stimme skalierbar, es erfindet sie nicht. Wer hier bei null steht, beginnt mit Schritt 1 und zehn selbst geschriebenen Texten, nicht mit einem Prompt.
Methode
Gelesen wurden am 20. Oktober 2026 der Nielsen-Norman-Group-Artikel zu den vier Dimensionen der Tonalität, der Claude-Support-Artikel zur Überführung von Styles in Skills (Stand Juni 2026), der Überblicksartikel zu Claudes Personalisierungsfunktionen und die OpenAI-Hilfeseite zu Custom Instructions. Das Vier-Schritte-Vorgehen ist eine redaktionelle Strukturierung; die Blindprobe und die Rückspielung sind Praxisempfehlungen der Redaktion und stammen nicht aus einer der Quellen.
Grenzen
Die vier Tonalitätsdimensionen sind ein etabliertes UX-Gerüst, keine wissenschaftliche Messskala mit Normwerten. Produktnamen und Funktionsumfänge der Werkzeuge ändern sich laufend; die Beschreibung gilt für den Recherchestand vom 20. Oktober 2026. Aussagen über die Wirkung von Beispieltexten beruhen auf dokumentiertem Few-Shot-Verhalten und Praxis, nicht auf einer kontrollierten Markenstudie.
Quellen
- The Four Dimensions of Tone of Voice, Nielsen Norman Group (abgerufen 2026-10-20) ↩1 ↩2
- Styles are moving to skills, Claude Help Center (Juni 2026) (abgerufen 2026-10-20) ↩1 ↩2
- Understanding Claude's personalization features, Claude Help Center (abgerufen 2026-10-20) ↩1 ↩2
- Custom instructions for ChatGPT, OpenAI Help Center (abgerufen 2026-10-20) ↩1 ↩2