 KI
Morgenüberblick vom 11. November 2026. Quellenstand: 06:38 Uhr MEZ. Diese Ausgabe bündelt drei Messarbeiten zum Betrieb von LLM-Agenten: die Aussagekraft gesättigter Benchmarks, die fachlichen Kosten gelöschter Denkhistorien im Routing und ein Gedächtnisdesign gegen selbstverschuldete Rückfälle. Alle Quellen sind Preprints; wir haben die hier verwendeten Aussagen mit den Originalquellen abgeglichen, eine unabhängige Replikation liegt uns nicht vor.
1. Agenten-Benchmarks: Sättigung als Messfehler
Setup. Dong (Lenovo), Zhan (Marquette) und Hu (Cornell) bewerten veröffentlichte Läufe von acht Benchmarks neu (darunter SWE-bench Verified und Terminal-Bench) und analysieren 57 Modellkarten von sieben Laboren: Nur ein Drittel der agentischen Ergebnisse einer Karte ist mit dem Vorgänger-Flaggschiff vergleichbar; die letzte Flaggschiff-Karte mit SWE-bench-Verified-Werten stammt vom April 2026 (Top Ten bei 76 bis 80 Prozent).
Befunde. Fehler A, das Bit ist zu grob: Die SWE-bench-Verified-Top-Ten bilden eine Gruppe (3,6 Punkte Spanne; September 2024: 19,2 Punkte, drei Gruppen), keines der 45 Paare trennt sich signifikant, der Test löst etwa 6,3 Punkte auf. Die Verifiziererfehler sind größer als die Abstände: Verstärkte SWE-ABS-Tests verwerfen 17,7 Prozent der Pässe des Median-Agenten (10,8 bis 23,2); die Korrektur schrumpft die Spitzengruppe von 23 auf fünf und kehrt acht von 18 Nachbarordnungen um, zufälliges Streichen eines Sechstels kehrt rechnerisch ebenso viele um. Fehler B, das Bit ist gedeckelt: Auf ALE-Bench schlagen 47,8 Prozent der Läufe den menschlichen Median, als Bestanden-Frage gegen diesen Wert kollabiert die Top Ten in eine Gruppe (S gleich 1,00), der abgestufte Score stellt drei Gruppen wieder her (S gleich 0,03). Eine höhere Hürde verschiebt das Band nur: Der Balken auf Siegerhöhe nullt 89 Prozent der älteren Modelle. Terminal-Bench-Nachlauf der Autoren: 13 Schwellen-Aufgaben, vier Modelle über ein Drittanbieter-Gateway, drei Versuche, 156 Läufe für rund 115 Dollar Listpreis; drei pass/fail-gleiche Modelle liegen auf einer Aufgabe bei Median-Beschleunigungen von 10,9 gegenüber 1,3, und 69 Prozent der Pässe schlagen die Referenz. Kostenachse: Sechs gleiche Top-Ten-Agenten unterscheiden sich um Faktor 7,3 bei Tokens pro Lauf, vier gepreiste um Faktor 5,5 bei Dollar (0,44 bis 2,47); der billigste Lauf nutzt das teuerste Modell pro Token. Vorschlag: gehärtetes Gate, geankerter log-ratio-Score (Clip bei drei Referenzabständen), Kosten als separate Achse, LLM-Juroren nur beim Bau der Prüfer, nicht zur Laufzeit. Limitationen: Verifiziererfehler nur für SWE-bench beziffert, ALE-Bench-Datierungen teils rekonstruiert, Nachlauf mit drei Versuchen grenzwertig, Rubrik-Aufgaben außerhalb.
2. Denkhistorie: Löschkosten sind eine Modelleigenschaft
Setup. Nach Darstellung der Autoren binden Anbieter Reasoning-Traces an den ausstellenden Account; über Vermittler weitergeleitete Anfragen kommen ohne Denkhistorie an (73 Prozent von 94.000 ShareGPT-Unterhaltungen sind mehrstufig). Jia, Zeng, Yang, Gao und Ma (University of Sussex u.a.) messen diese Löschung nach eigenen Angaben erstmals direkt, verblindet und über Seeds: drei Bedingungen (Behalten, Löschen aller Vorrunden, Löschen der bisherigen Denkhistorie ab 40 Prozent der Sitzung), vier Multi-Turn-Teilmengen des BFCL v4 mit 794 Aufgaben, drei Seeds, offizieller Checker, vLLM, Bootstrap-Intervalle. Fünf Modelle liefen auf allen 794 Aufgaben, Baichuan-M2-32B und Olmo-3-7B-Think auf einer 200er-Teilmenge.
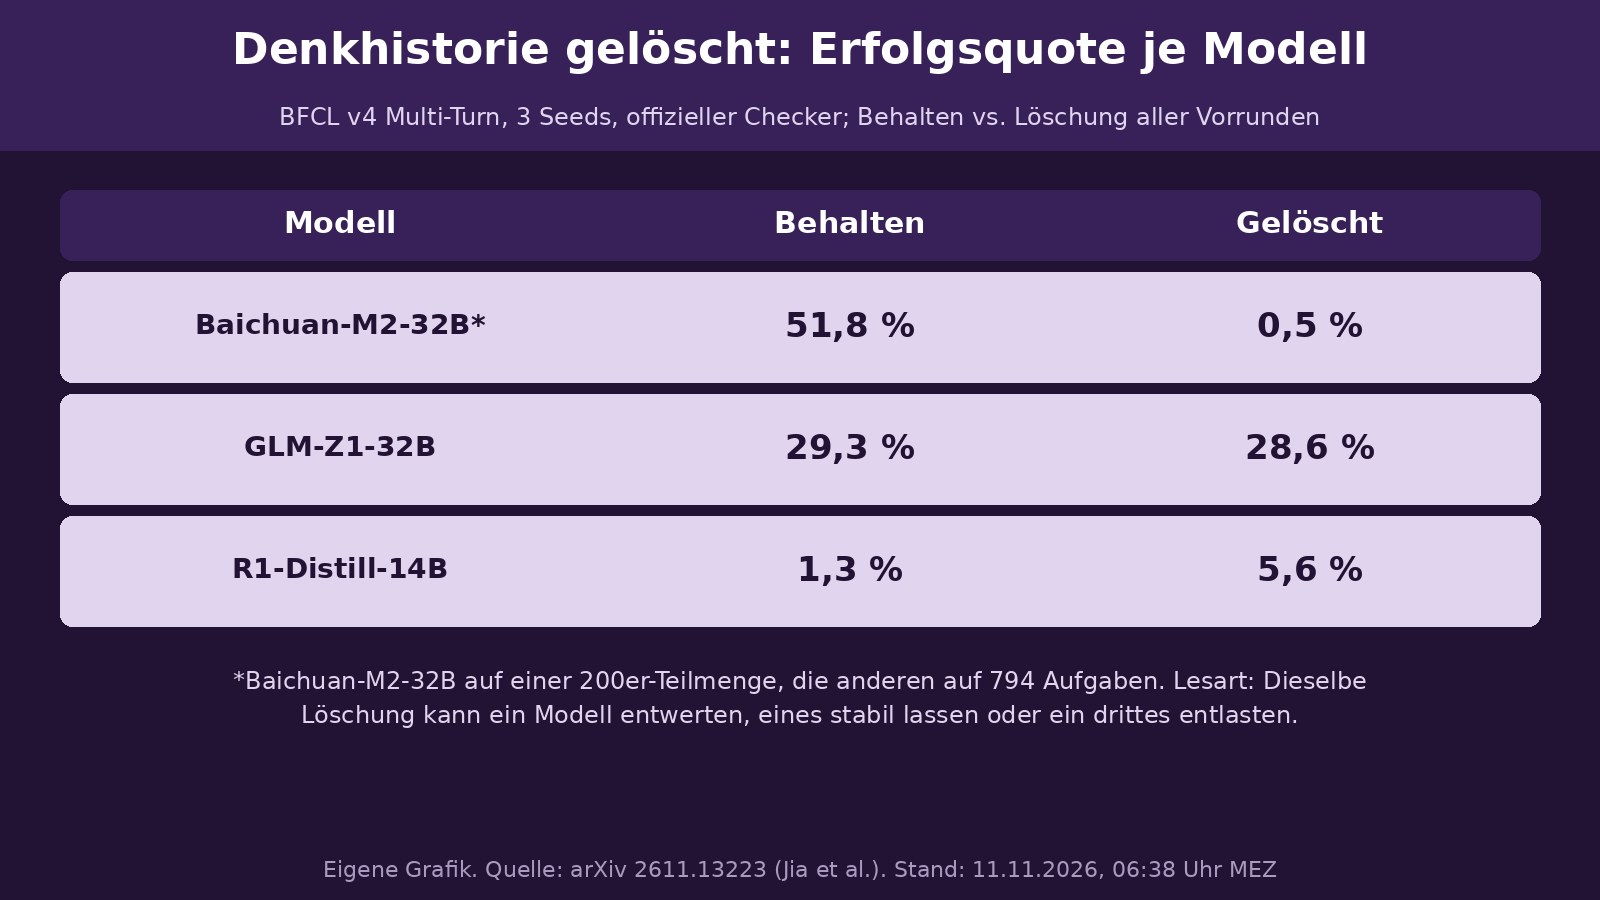
Befunde. Dieselbe Operation spannt minus 4,4 bis plus 51,3 Punkte auf, beide Enden mit Intervall jenseits von null: Baichuan-M2-32B fällt von 51,8 auf 0,5 Prozent Erfolg, GLM-Z1-32B hält 29,3 gegenüber 28,6, die drei Qwen3 liegen innerhalb von 3,1 Punkten um null, R1-Distill-14B verbessert sich von 1,3 auf 5,6 Prozent. Im untersuchten Rahmen reichen Parameterzahl und Aufgabenmix nicht als Erklärung; die drei 32B-Modelle spannen 51,5 Punkte. Im einzigen Dosisversuch (Qwen3-32B, 200 Aufgaben) liegen die Endpunkte bei 0 und 100 Prozent Löschung 1,5 Punkte auseinander; alle Arme zusammen reichen von 53,0 bis 56,5 Prozent Erfolg. Drei Verhaltenssignaturen: kompensierend (Qwen3-Reihe, GLM; Neuherleitung mit Zusatzaufrufen, in einem Fall 6 zu 410 Aufrufe bei gleichem Erfolg), schleifend (R1-Distill bei Mid-Session-Löschung 18,1 auf 68,7 Prozent Wiederholrate, Olmo cross-turn 30,2 auf 66,5), still (Baichuan: Erfolg weg, Wiederholrate nur 18,5 auf 26,5). Konsequenz: Zwei-Zellen-Screen mit je 200 Aufgaben vor dem Routing; Für den BFCL-Versuchsrahmen empfehlen die Autoren: Liegt das gesamte Intervall oberhalb von plus zehn Punkten, die Sitzung binden; sonst löschen und das Log überwachen. Andere Aufgabenfamilien brauchen eigene Tests. Limitationen: Übertrag auf andere Aufgabenfamilien offen, geschlossene Modelle nicht gemessen, Zusammenfassungs-Arm ausstehend, nur ein Checker-Projekt.
3. WikiTrace: Gedächtnis mit Rückweg zum Beleg
Setup. Lee, Choi, Baek und Hwang (KAIST und DeepAuto.ai) trennen die Wirkung von Agenten-Gedächtnis in Gewinn (neu gelöste Fälle) und Rückfall (verdorben gelöste Fälle). Bei den untersuchten Rückfällen führt in 52 Prozent ein befolgter Gedächtniseintrag in die Irre, am häufigsten ein falscher (20 Prozent); ein LLM-Juror klassifizierte die Ursachen. WikiTrace speichert pro Lauf höchstens drei Lektionen, jede verlinkt auf die Diagnose des Quelllaufs und den Rohlauf; Lektionen werden nie nachträglich geändert. Der Agent steigt zum Beleg ab, wenn eine Lektion undetailliert ist, aus einem gescheiterten Lauf stammt oder einer anderen widerspricht.
Befunde. Auf acht Suiten von fünf Benchmarks (ALFWorld, ScienceWorld, PlanCraft, Tau-3-bench Retail, AppWorld), Agent und Gedächtnisbauer deepseek-v4-flash, drei Durchläufe: WikiTrace 90,2 Punkte im Schnitt gegenüber 79,5 ohne Gedächtnis und 87,0 mit denselben Lektionen ohne Quellzugang; beste Werte auf allen acht Suiten und als einziges Verfahren überall mindestens auf Stand ohne Gedächtnis. Rückfall 4,5 Prozent gegenüber 6,5 (nur Lektionen) und 9,7 (Wiederholung ohne Gedächtnis); Gewinn 35 Punkte über der Wiederholungsbasis. Der Agent steigt häufiger bei schweren Aufgaben ab (44 gegenüber 22 Prozent) und ändert in 43 Prozent der Abstiege den Plan; diese Läufe liegen 8,3 Punkte über der Lektionen-Variante. Testzeit-Kosten mal 1,17 gegenüber der Lektionen-Variante; vervielfachte Baubudgets der Baselines (AWM neunfach) bleiben dahinter. Mit GLM-5.3-flash: 92,7 gegenüber 90,9 auf drei Suiten. Limitationen: Binäretiketten und Diagnosen können falsch sein, der Link verifiziert nichts, alle Lektionen stehen in der ersten Nachricht (Abrufproblem offen), Ursachenlabels von einem LLM-Juror. Code auf GitHub veröffentlicht (von uns auf Erreichbarkeit geprüft).
Quellen
- Agent Benchmarks Stop Ranking Before They Run Out of Tasks, arXiv (Dong, Zhan & Hu; Lenovo, Marquette University, Cornell University) (abgerufen 2026-11-11)
- Deletion Sensitivity Is a Property of the Model: A Three-Condition Measurement across Seven Open Reasoning Models, arXiv (Jia, Zeng, Yang, Gao & Ma; University of Sussex u.a.) (abgerufen 2026-11-11)
- Don't Just Trust Your Memory: Evidence-Linked Memory Reduces Memory-Induced Degradation in LLM Agents, arXiv (Lee, Choi, Baek & Hwang; KAIST und DeepAuto.ai) (abgerufen 2026-11-11)