 KI
Wer heute mit einem Sprachmodell lange Gespräche führt oder Agenten über viele Schritte arbeiten lässt, bezahlt dafür mit Kontext: Der Verlauf landet im Prompt, der KV-Cache wächst, und mit ihm Speicherbedarf und Latenz. MemTensor will diesen Trade-off mit MemT-1.0 an der Wurzel angehen: Die Modellfamilie macht ein persistentes, sich weiterentwickelndes Gedächtnis zu einem festen Bestandteil der Modellrechnung, statt Information ausschließlich im Kontextfenster zu halten [1][2]. Veröffentlicht wurden Technical Report, Code und Checkpoints; der unabhängige Release-Tracker AIFOD datiert die Veröffentlichung auf den 26. Oktober [4].
Die Modellfamilie im Überblick
| Eigenschaft | MemT-1.0-Nano | MemT-1.0-Flash |
|---|---|---|
| Backbone | Qwen3.6-35B-A3B | DeepSeek-V4-Flash |
| Parameter gesamt / aktiv pro Token | 36 Mrd. / 3 Mrd. | 288 Mrd. / 17 Mrd. |
| Trainierbare Speicherparameter | 451 Mio. | 3,61 Mrd. |
| Dynamischer Speicherzustand | 10 Mio. Elemente | 336 Mio. Elemente |
Beide Modelle sind MoE-Modelle: Pro Token ist nur ein Bruchteil der Parameter aktiv. Entscheidend ist die letzte Zeile der Tabelle - der dynamische Speicherzustand hat eine feste, konfigurierte Größe. Wächst der Verlauf, wird der Zustand aktualisiert, nicht länger [1][2].
- MemT-1.0-Nano
- MemT-1.0-Flash
Daten als Tabelle
| MemT-1.0-Nano | MemT-1.0-Flash | |
|---|---|---|
| Gesamt | 36 | 288 |
| Aktiv/Token | 3 | 17 |
| Speicher (train.) | 0,45 | 3,61 |
Herstellerangaben aus Technical Report und Repository [1][2]. Die Speicherparameter sind trainierbar; der dynamische Zustand kommt hinzu (Nano: 10 Mio. Elemente, Flash: 336 Mio.).
Wie das native Gedächtnis arbeitet
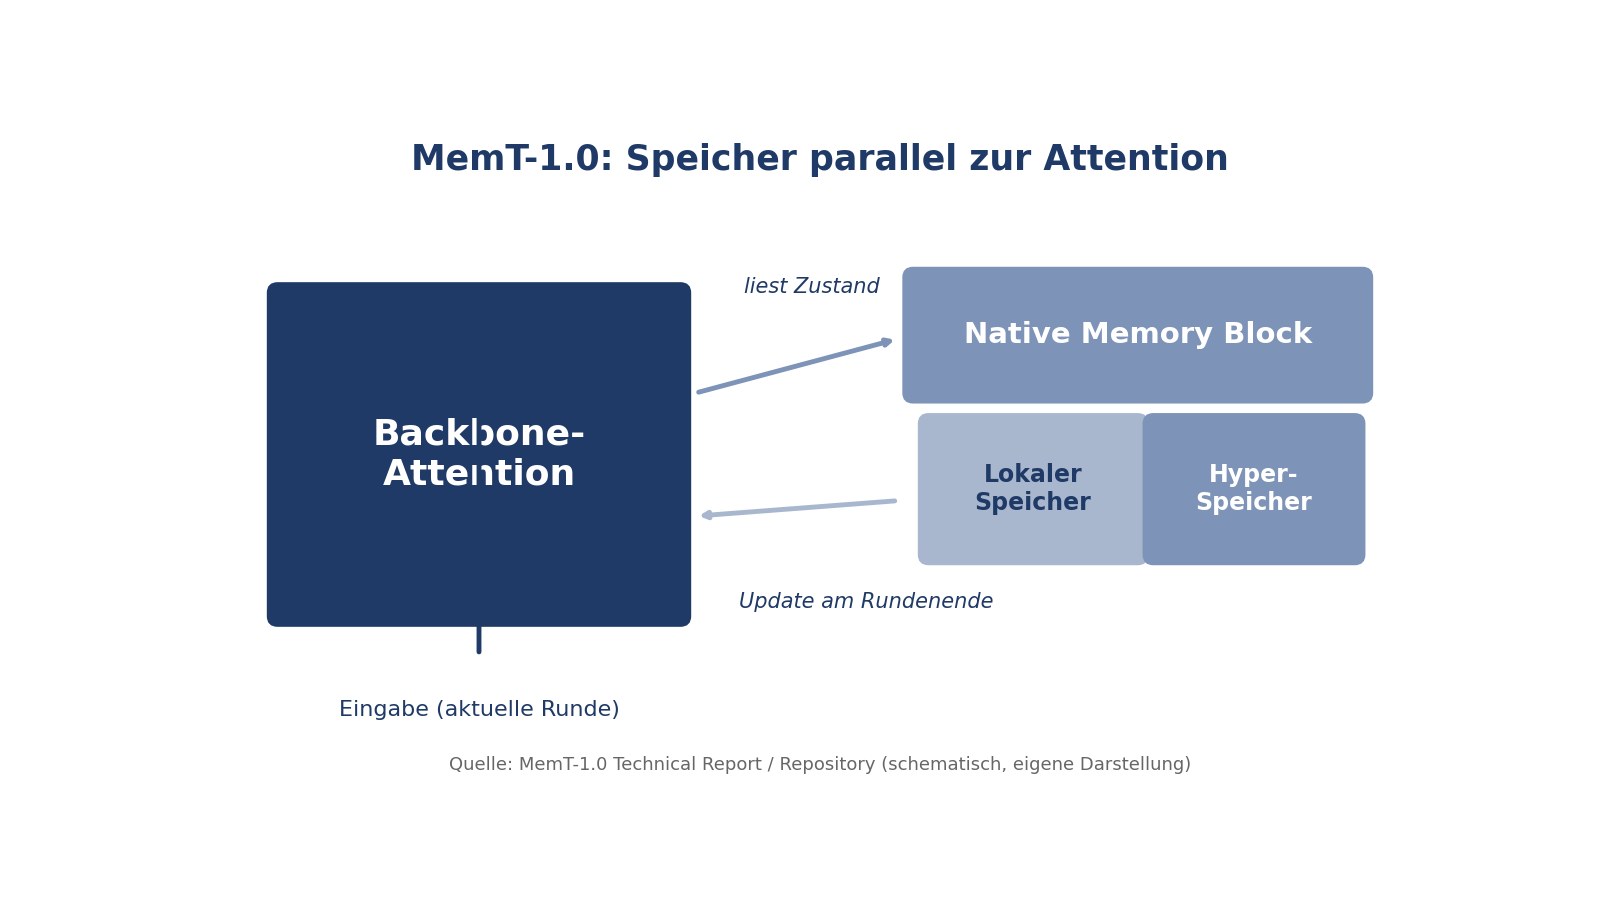
Der Kern ist ein Native Memory Block, der parallel zur gewöhnlichen Attention des Backbones läuft und aus zwei Komponenten besteht: Ein Local Memory Block führt eine dynamische, mehrkanalige Speichermatrix, die sich über die Interaktionsschritte weiterentwickelt. Ein Hyper Memory Block enthält trainierbare Projektionen für Schlüssel, Werte und Anfragen sowie Gatter zum Löschen, Schreiben und Vergessen [1][2]. Während der Generierung liest eine Memory-Attention aus dem aktuellen Zustand; am Ende jeder Runde oder jedes Segments aktualisiert ein stabilisiertes GDN-2-Verfahren (Gated DeltaNet-2) den Speicher tokenweise für die folgenden Schritte [1].
Für mehr Speicherkapazität führt das Paper Mixture-of-Storage (MoS) ein: Jeder Speicherblock wird in mehrere Speicher-Experten aufgeteilt, über die - anders als bei klassischem MoE - dense geroutet wird. Alle Experten beteiligen sich an jeder Speicheroperation; separate Router für Lesen und Schreiben teilen sich eine gemeinsame, trainierbare Adressmatrix [1].
Trainiert wurde in zwei Stufen - Continued Pre-Training und Post-Training - auf insgesamt 34 Milliarden Tokens. Zuvor wurde das Backbone gezielt vorbereitet: Die finale Mischung umfasst 126.500 Trajektorien (2,4 Mrd. Tokens), davon gut 90 Prozent der loss-tragenden Tokens aus agentischen Aufgaben. Nach Angaben der Autoren verbessert das vorbereitete Backbone alle sechs überwachten Benchmarks um durchschnittlich 6,3 Punkte gegenüber dem öffentlichen Release [1].
Was die Evaluation zeigt - und was nicht
Über elf Gedächtnis-Benchmarks hinweg belegen MemT-1.0-Flash und -Nano nach Herstellerangaben die Plätze eins und zwei unter den evaluierten parametrischen Speichermethoden - also Verfahren, die Gedächtnis in Modellparametern oder -zuständen halten. Gleichzeitig räumen die Autoren ein: Starke textbasierte Speichersysteme, die den Originaltext nachschlagen können, bleiben insgesamt vorn, insbesondere bei langen Verläufen, die das Wiederfinden konkreter Details verlangen [2][3]. Der feste Zustand ist also ein Kompromiss: Er spart Speicher, verliert aber irgendwann Feinheiten.
Die Effizienzrechnung im Paper: Bei 128.000 Tokens Verlauf erreicht MemT-1.0-Nano eine rund 1,86-fache Beschleunigung der End-to-End-Inferenz und eine etwa 66-fache Reduktion des persistenten Speichers gegenüber dem vollen KV-Cache. Bei 64.000 Tokens Verlauf liegt die Reduktion des logischen Zustands pro Trajektorie bei etwa dem 33-Fachen. Alle Werte stammen aus dem Technical Report und wurden nicht unabhängig nachgemessen [1].
Erfahrung als Speicher: Agentic Coding
Über das reine Erinnern hinaus demonstriert das Paper einen Agenten-Anwendungsfall: Gelöste Teilaufgaben aus früheren Coding-Aufgaben werden als prozedurale Erfahrung in den nativen Speicher überführt und bei neuen Aufgaben über die Memory-Attention abgerufen - ohne dass der Erfahrungstext im Kontext mitgeschleppt wird. Auf SWE-bench Verified und SWE-bench Multilingual steigere das laut Paper die durchschnittliche Erfolgsrate und die Konsistenz über wiederholte Läufe gegenüber Agenten ohne Erfahrung und liege auf dem Niveau explizit mitgegebenen Erfahrungstexts [1]. Konkrete Prozentwerte nennt die Zusammenfassung nicht.
Verfügbarkeit und Lizenz
Das Repository beschreibt den Betrieb über SGLang mit einem eigenen Python-Client (memt_sglang): Sessions lassen sich mit Memory-Snapshots speichern und später ohne Konversationsverlauf wieder aufnehmen; das Nano-Beispiel läuft auf zwei GPUs [2]. Checkpoints sind auf Hugging Face verfügbar [3]. Bei der Lizenz gilt Vorsicht: Der Code steht unter der PolyForm Noncommercial License, das Paper unter CC BY-NC-SA 4.0. Für Gewichte, Datensätze und Benchmark-Assets verweist das Repository auf separate Bedingungen, die mit den jeweiligen Veröffentlichungen kommen sollen. Kommerzielle Nutzung ist damit aktuell nicht pauschal erlaubt [2].
Einordnung: MemT-1.0 adressiert ein reales Kostenproblem langlebiger Agenten und liefert ein durchdachtes, offen dokumentiertes Design. Die zentralen Aussagen zu Benchmark-Rängen und Effizienz sind jedoch durchweg Herstellerangaben; unabhängige Reproduktionen stehen aus. Wer produktiv mit langen Verläufen arbeitet, sollte das Versprechen 'konstanter Speicher' gegen die eingeräumte Schwäche bei Detailfragen abwägen - und die Lizenzlage vor jeder kommerziellen Nutzung klären.
Methode
Analyse auf Basis des Technical Reports (arXiv), des offiziellen GitHub-Repositorys und der Hugging-Face-Modellkarte; alle Quellen wurden gelesen. Benchmark-, Effizienz- und Trainingsangaben sind durchweg Herstellerangaben; das Modell wurde von der Redaktion nicht selbst ausgeführt. Der Release-Tracker dient der Einordnung von Datum und Verfügbarkeit.
Grenzen
Keine eigenen Modelltests und keine unabhängige Verifikation der Benchmarks oder Effizienzwerte. Die vollständige Evaluationstabelle des Papers war im abrufbaren HTML nur teilweise einsehbar; einzelne Benchmark-Scores werden daher nicht zitiert. Die Lizenzbedingungen der Gewichte sind noch nicht final veröffentlicht.
Quellen
- MemT-1.0: Towards Memory-Native Evolution (Technical Report), arXiv / MemTensor (abgerufen 2026-10-31) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- MemTensor/MemT-1.0 - offizielles Repository, GitHub / MemTensor (abgerufen 2026-10-31) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- MemTensor/MemT-1.0-Flash - Modellkarte, Hugging Face / MemTensor (abgerufen 2026-10-31) ↩1 ↩2 ↩3
- AI Model Releases - October 2026 (Live Tracker), AIFOD (abgerufen 2026-10-31) ↩